lipforcing-results-backup
收藏资源简介:
该数据集是NeurIPS 2026 Submission109 Lip Forcing论文的推理结果与真实数据备份,创建于2026年7月24日,源自bai-vscode2环境的本地目录。它主要用于唇部同步或语音驱动面部动画任务的模型评估与比较,包含两个核心部分:推理输出(约7.5GB)和真实数据(约910MB)。推理输出部分存储了多个模型(如ours_1.3b_step500、ours_14b_step600等)在多个基准测试(如hdtf_81f、hallo3_81f等)上的预测结果,每个模型-基准组合目录包含metrics/和pairings/子目录。真实数据部分提供地面真实值,包括hallo3_81、talkvid_81和hdtf_long剪辑,其中hdtf_81的真实数据可通过hdtf_long前81帧重建。数据集还包含一个xdub_hdtf_long_reinference/目录,存储了对hdtf_long基准的重新推理结果。总规模约8.41GB,但部分样本存在缺失。该数据集适用于计算机视觉和多媒体领域的研究,特别是唇部同步算法的性能评估、基准测试和结果复现。
This dataset is a backup of inference results and ground truth data for the NeurIPS 2026 Submission109 Lip Forcing paper, created on July 24, 2026, from a local directory in the bai-vscode2 environment. It is primarily used for model evaluation and comparison in lip synchronization or speech-driven facial animation tasks, consisting of two core parts: inference output (approximately 7.5GB) and ground truth data (approximately 910MB). The inference output part stores predictions from multiple models (e.g., ours_1.3b_step500, ours_14b_step600, etc.) on multiple benchmarks (e.g., hdtf_81f, hallo3_81f, etc.), with each model-benchmark combination directory containing metrics/ and pairings/ subdirectories. The ground truth part provides ground truth values, including hallo3_81, talkvid_81, and hdtf_long clips, where the ground truth for hdtf_81 can be reconstructed from the first 81 frames of hdtf_long. The dataset also includes an xdub_hdtf_long_reinference/ directory storing re-inference results for the hdtf_long benchmark. The total size is approximately 8.41GB, but some samples are missing. It is suitable for research in computer vision and multimedia fields, particularly for performance evaluation, benchmarking, and result reproduction of lip synchronization algorithms.
数据集概述
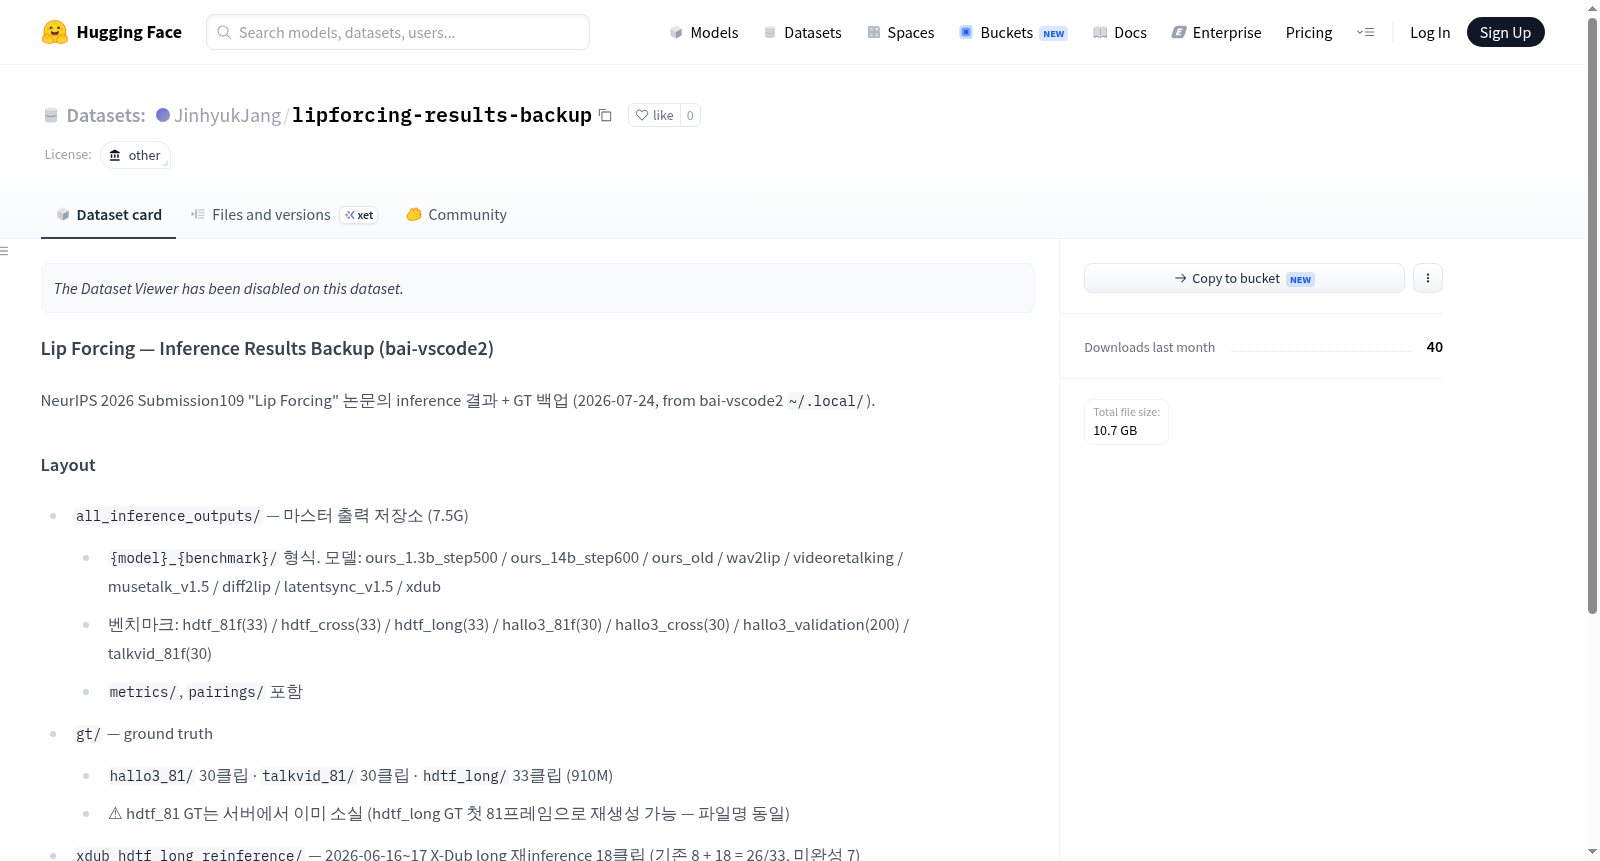
该数据集是论文《Lip Forcing》(NeurIPS 2026 Submission109)的推理结果与真实标签(GT)备份,数据来源于 2026-07-24 的服务器备份。
数据集内容
数据集主要包含三个部分:
| 目录 | 说明 |
|---|---|
all_inference_outputs/ |
主输出存储库(7.5G) |
gt/ |
真实标签(Ground Truth),包含 910M 数据 |
xdub_hdtf_long_reinference/ |
X-Dub 长视频重新推理结果(18 个片段) |
1. 推理输出 (all_inference_outputs/)
按 {模型}_{基准}/ 格式组织,包含的模型与基准如下:
模型:
- ours_1.3b_step500
- ours_14b_step600
- ours_old
- wav2lip
- videoretalking
- musetalk_v1.5
- diff2lip
- latentsync_v1.5
- xdub
基准(Benchmark):
- hdtf_81f(33)
- hdtf_cross(33)
- hdtf_long(33)
- hallo3_81f(30)
- hallo3_cross(30)
- hallo3_validation(200)
- talkvid_81f(30)
每个输出目录中还包含 metrics/ 和 pairings/ 子目录。
2. 真实标签 (gt/)
hallo3_81/:30 个片段talkvid_81/:30 个片段hdtf_long/:33 个片段- 注意:hdtf_81 的真实标签已在服务器上丢失,但可通过 hdtf_long 的真实标签前 81 帧重新生成(文件名相同)。
3. X-Dub 长视频重新推理
- 时间:2026-06-16 至 06-17
- 包含 18 个片段
- 当前状态:已覆盖 26/33,仍有 7 个未完成
已知缺口
| 模型/基准 | 缺失情况 |
|---|---|
| ours_1.3b_step500_hdtf_long | 31/33 |
| latentsync_v1.5_hdtf_long | 32/33 |
| xdub hdtf_long | 26/33 |
| wav2lip_hdtf_81f | 31/33 |
| wav2lip_hallo3_81f | 29/30 |
| wav2lip_hallo3_validation | 199/200 |
| videoretalking_hallo3_cross | 29/30 |
该数据集主要用于 Lip Forcing 论文的推理结果存档与对比验证,适合需要复现或分析该论文实验结果的用户使用。