遇见数据集

florentgbelidji/oa_german

收藏
Hugging Face2023-11-22 更新2024-03-04 收录
官方服务:

资源简介:

--- license: apache-2.0 dataset_info: features: - name: conversation_id dtype: string - name: user_id dtype: string - name: created_date dtype: string - name: messages list: - name: content dtype: string - name: role dtype: string - name: lang_original dtype: string - name: could_be_code dtype: bool splits: - name: train_english num_bytes: 29675151 num_examples: 18192 - name: train_german num_bytes: 28931906 num_examples: 18192 download_size: 21854409 dataset_size: 58607057 configs: - config_name: default data_files: - split: train_english path: data/train_english-* - split: train_german path: data/train_german-* ---

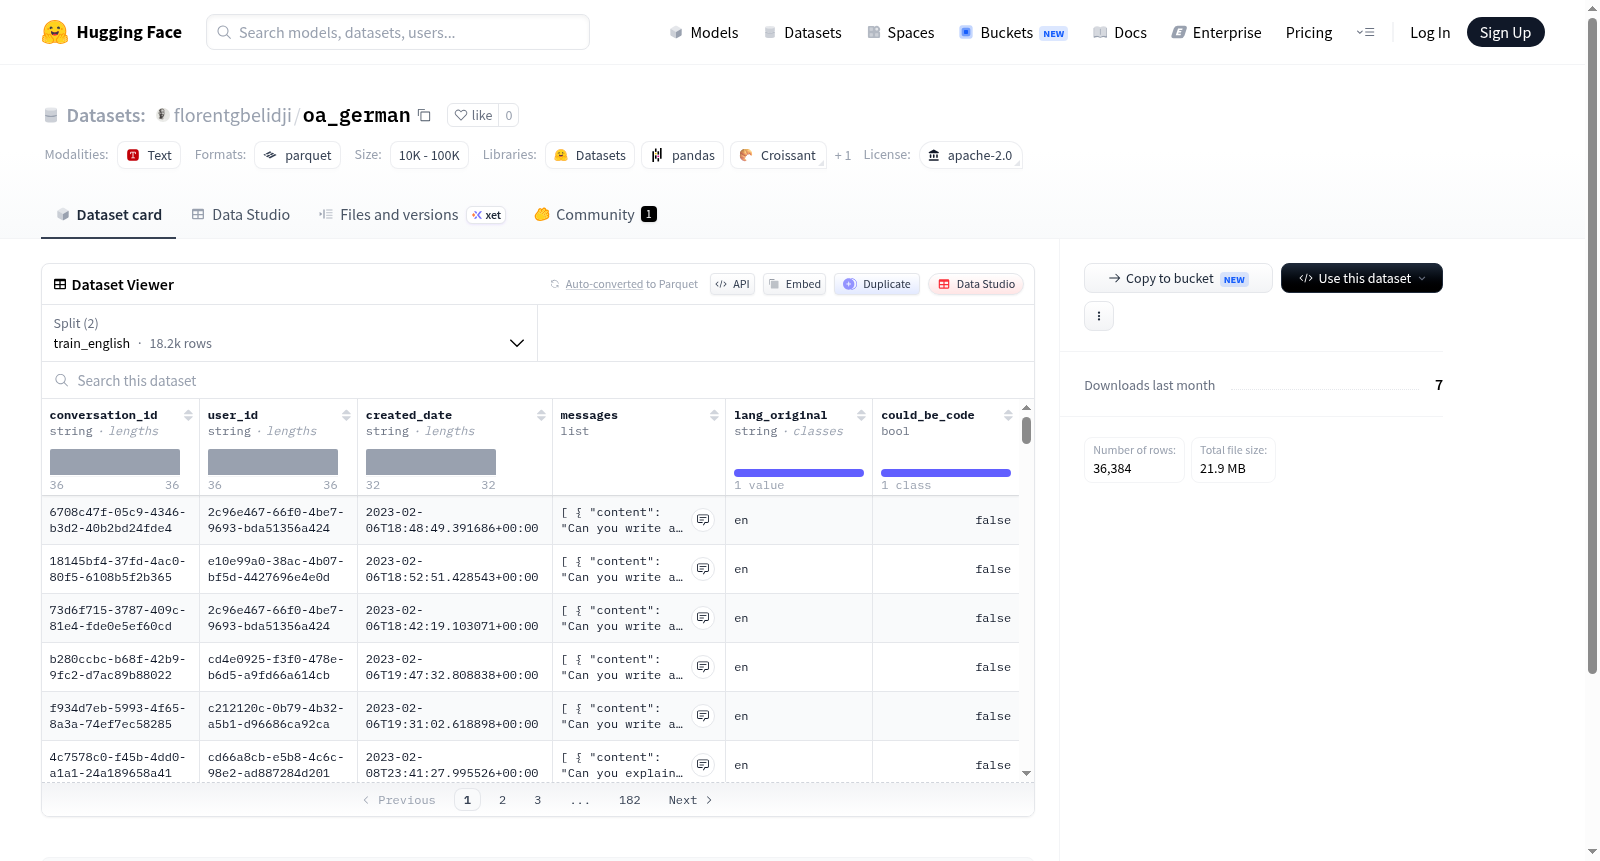
许可证:Apache-2.0 数据集信息: 特征: - 字段名:对话ID(conversation_id),数据类型:字符串 - 字段名:用户ID(user_id),数据类型:字符串 - 字段名:创建日期(created_date),数据类型:字符串 - 字段名:对话消息(messages),类型为列表,列表项包含: - 内容(content),数据类型:字符串 - 角色(role),数据类型:字符串 - 字段名:原语言(lang_original),数据类型:字符串 - 字段名:可能为代码(could_be_code),数据类型:布尔值 数据集拆分: - 拆分名称:英文训练集(train_english),字节数:29675151,样本数:18192 - 拆分名称:德文训练集(train_german),字节数:28931906,样本数:18192 下载大小:21854409 字节 数据集总大小:58607057 字节 配置项: - 配置名称:默认配置(default),数据文件: - 拆分:英文训练集(train_english),路径:data/train_english-* - 拆分:德文训练集(train_german),路径:data/train_german-*

提供机构:
florentgbelidji
原始信息汇总

数据集概述

许可证

  • Apache 2.0

数据集信息

特征

  • conversation_id: 字符串类型
  • user_id: 字符串类型
  • created_date: 字符串类型
  • messages: 列表类型
    • content: 字符串类型
    • role: 字符串类型
  • lang_original: 字符串类型
  • could_be_code: 布尔类型

数据分割

  • train_english:
    • 字节数: 29675151
    • 样本数: 18192
  • train_german:
    • 字节数: 28931906
    • 样本数: 18192

数据大小

  • 下载大小: 21854409 字节
  • 数据集大小: 58607057 字节

配置

  • default:
    • train_english: 路径为 data/train_english-*
    • train_german: 路径为 data/train_german-*
搜集汇总
数据集介绍
florentgbelidji/oa_german 数据集图片
构建方式
在对话系统与多语言自然语言处理领域,高质量的多语种对话数据集是推动模型泛化能力的关键资源。florentgbelidji/oa_german数据集基于Open Assistant项目构建,通过系统性地收集用户与助手之间的交互对话,并经过语言筛选与标注,形成了德英双语对齐的对话语料库。该数据集包含两个子集:train_english与train_german,各含18,192条对话样本,每条样本均包含对话标识符、用户标识符、创建日期、角色与内容构成的对话轮次,以及原始语言标记和是否为代码内容的布尔判断字段。构建过程确保了数据来源的多样性与对话结构的完整性,为跨语言对话研究提供了坚实基础。
特点
该数据集的核心特点在于其精心设计的双语对齐结构,使得研究者能够直接对比同源对话在英语与德语两种语言下的表达差异。每条对话均保留了完整的上下文轮次信息,并附带了语言来源与代码内容标记,便于进行语言特异性分析与代码相关对话的过滤。此外,数据集的规模适中,两个子集样本数量完全对称,为跨语言迁移学习与模型微调提供了均衡的训练基础。数据采用Apache-2.0许可证开放,降低了使用门槛,促进了学术与工业界的广泛共享与协作。
使用方法
使用该数据集时,研究者可通过HuggingFace的datasets库直接加载,指定config为'default'即可获取包含train_english与train_german两个分片的数据。每条样本的messages字段以列表形式存储对话轮次,每个轮次包含'content'与'role'键,便于构建对话模型输入。用户可根据任务需求,利用'lang_original'字段筛选特定语言数据,或通过'could_be_code'字段排除包含代码的对话。数据集适用于对话生成、多语言模型预训练与微调、以及跨语言对话理解等研究场景,支持灵活的分割与采样策略。
背景与挑战
背景概述
在自然语言处理领域,多语言对话数据集对于推动跨语言人机交互研究具有关键作用。florentgbelidji/oa_german数据集由研究者于近期创建,旨在为德语对话系统提供高质量的平行语料资源。该数据集基于OpenAssistant项目扩展而来,核心研究问题聚焦于如何构建与英语语料对齐的德语对话数据,以支持多语言对话模型的训练与评估。其影响力体现在为德语NLP社区提供了首个大规模、结构化的开源对话数据集,填补了德语在指令微调与对话生成任务中的数据空白,促进了多语言对话系统的公平性与鲁棒性研究。
当前挑战
该数据集面临的核心挑战首先在于领域问题层面:德语对话数据在语法复杂性、方言变体及文化语境上的独特性,使得模型在跨语言迁移时易出现语义偏差与生成质量下降,亟需更精细的对齐策略来缓解语言差异带来的性能折损。其次,构建过程中遭遇两大难题:一是原始英语对话数据的翻译质量难以保证,机器翻译结果可能引入不自然的表达或歧义;二是德语标注资源稀缺,导致角色标签与对话意图的标注一致性维护困难,需依赖多轮人工校验与迭代优化才能确保数据集的可靠性与可用性。
常用场景
经典使用场景
在自然语言处理与多语言对话系统研究领域,florentgbelidji/oa_german 数据集以其独特的双语对话结构而备受瞩目。该数据集精心收录了超过一万八千组德英对照的交互式对话样本,每一组对话均包含完整的用户身份标识、时间戳以及多轮消息序列。研究者可借此深入探究跨语言对话中的语义对齐、语用迁移与情感表达差异,尤其适用于训练和评估面向德语场景的对话生成模型。其经典应用场景包括构建德语开放域聊天机器人、多语言问答系统以及跨语言情感分析模型,为弥合语言鸿沟提供了坚实的数据基石。
实际应用
在实际应用层面,该数据集直接赋能于工业级德语智能客服系统的开发与优化。企业可基于这些对话样本训练能够理解德语俚语、方言变体及正式与非正式语体切换的对话引擎,显著提升客户服务场景中的用户满意度。此外,该数据集还广泛应用于德语教育领域的智能陪练系统,通过模拟真实对话情境帮助学习者提升口语交流能力。在跨文化交际软件中,该数据集支持构建具备文化敏感性的多语言助手,实现从商务洽谈到旅游导览等多样化场景的无缝语言切换,极大拓展了人机交互的边界。
衍生相关工作
基于这一数据集,学术界涌现出一系列具有影响力的衍生工作。研究者利用其双语特性开发了跨语言对话预训练模型,通过在德语和英语对话上的联合预训练,显著提升了模型在零样本跨语言迁移任务中的表现。另有工作聚焦于对话中的代码混合现象,利用数据集中‘could_be_code’字段筛选出技术性对话样本,推动了面向编程助手的德语对话理解研究。此外,该数据集还被用于构建多轮对话的语用标注体系,衍生出对话行为识别与对话策略分析等子任务,为对话系统的细粒度评估提供了新范式。这些工作共同编织起德语对话研究的学术网络,不断拓展该数据集的理论与实践价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务