dpo-swedish-interpreted
收藏资源简介:
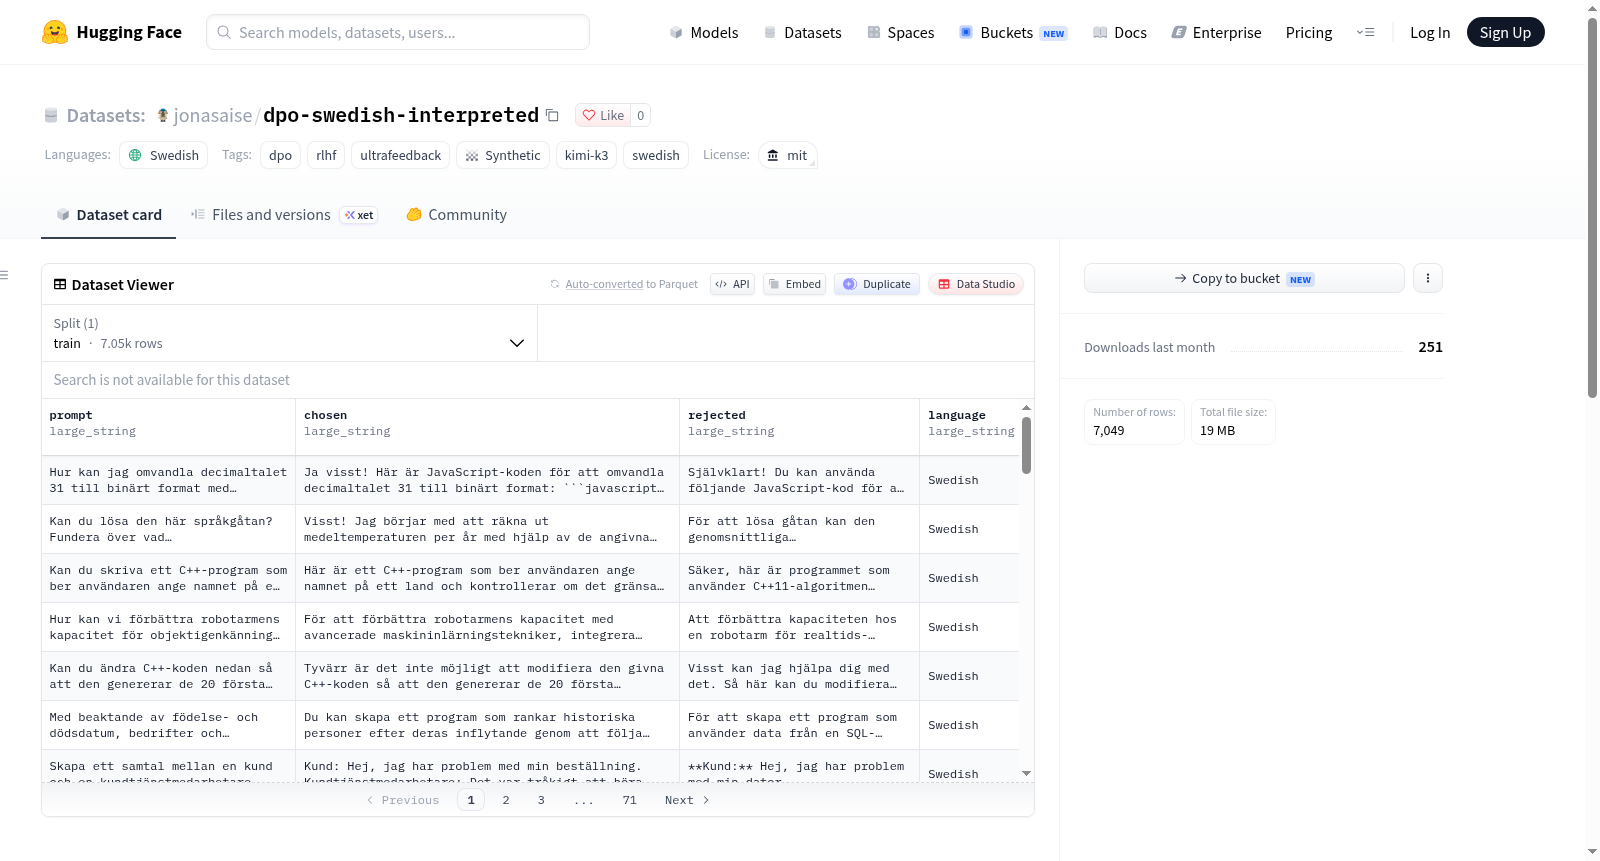
该数据集是专为直接偏好优化(DPO)和基于人类反馈的强化学习(RLHF)设计的瑞典语偏好对数据集。数据源自`argilla/ultrafeedback-binarized-preferences-cleaned`,通过`kimi-k3`模型进行翻译和文化适应生成。生成策略采用专门提示词,避免“翻译腔”和字面直译,要求模型深度本地化提示和优选回答以贴合瑞典文化和习语;同时有意生成一个质量较差的拒绝回答,该回答包含拙劣翻译、过多英语借词(Swenglish/Ice-lish)或美国中心幻觉。这为DPO/RLHF提供了高质量、针对性的信号,用于训练模型偏好地道、文化契合的瑞典语,而非机械的字典翻译。数据集包含以下字段:`prompt`(文化适应的瑞典语提示)、`chosen`(高质量、地道的瑞典语回答)、`rejected`(质量差的翻译回答)、`language`(目标语言,即瑞典语)。许可证为MIT,继承自源数据集。
This dataset is a Swedish preference pair dataset specifically designed for Direct Preference Optimization (DPO) and Reinforcement Learning from Human Feedback (RLHF). The data originates from `argilla/ultrafeedback-binarized-preferences-cleaned` and is generated through translation and cultural adaptation using the `kimi-k3` model. The generation strategy uses specialized prompts to avoid translationese and literal translations, requiring the model to deeply localize prompts and preferred responses to align with Swedish culture and idioms. Simultaneously, a deliberately low-quality rejected response is generated, containing poor translations, excessive English loanwords (Swenglish/Ice-lish), or American-centric hallucinations. This provides high-quality, targeted signals for DPO/RLHF, training models to prefer natural, culturally appropriate Swedish over mechanical dictionary translations. The dataset includes the following fields: `prompt` (culturally adapted Swedish prompt), `chosen` (high-quality, idiomatic Swedish response), `rejected` (low-quality translated response), and `language` (target language, i.e., Swedish). The license is MIT, inherited from the source dataset.
DPO Swedish Interpreted 数据集概述
基本信息
- 数据集地址:https://huggingface.co/datasets/jonasaise/dpo-swedish-interpreted
- 语言:瑞典语(sv)
- 许可证:MIT
- 标签:dpo、rlhf、ultrafeedback、synthetic、kimi-k3、swedish
数据集描述
该数据集包含直接偏好优化(DPO)配对,这些配对是从原始数据集 argilla/ultrafeedback-binarized-preferences-cleaned 翻译并进行文化适配为瑞典语而来。
来源与方法论
- 源数据集:argilla/ultrafeedback-binarized-preferences-cleaned(https://huggingface.co/datasets/argilla/ultrafeedback-binarized-preferences-cleaned)
- 合成所用模型:kimi-k3(通过本地端点)
- 翻译策略:数据集使用专门设计的提示词生成,以防止“翻译腔”和直接字面翻译。kimi-k3 模型被指示对提示词和被选择回答进行深度本地化,以契合瑞典文化和习语。此外,模型被有意生成了一个被拒绝的回答,该回答存在翻译质量差、过多英语外来词(Swenglish/Ice-lish)或以美国为中心的幻觉等问题。这为 DPO/RLHF 提供了高质量、有针对性的信号,教导模型偏好真实、扎根文化的瑞典语,而非机械的字典式翻译。
数据结构
数据集包含以下字段:
prompt:经过文化适配的瑞典语提示词。chosen:高质量、地道的瑞典语回答。rejected:翻译质量差、未经校准的回答。language:该行的目标语言。
配置
- 配置名称:default
- 数据文件:
- 分割:train
- 路径:data/**/*.parquet
许可证
该数据集继承其源数据集 argilla/ultrafeedback-binarized-preferences-cleaned 的许可证(MIT)。