
david-thrower/smollm-corpus-instruct-2M-cosmopedia-v2-gpt2-v2-streaming
收藏数据链接:
官方服务:
资源简介:
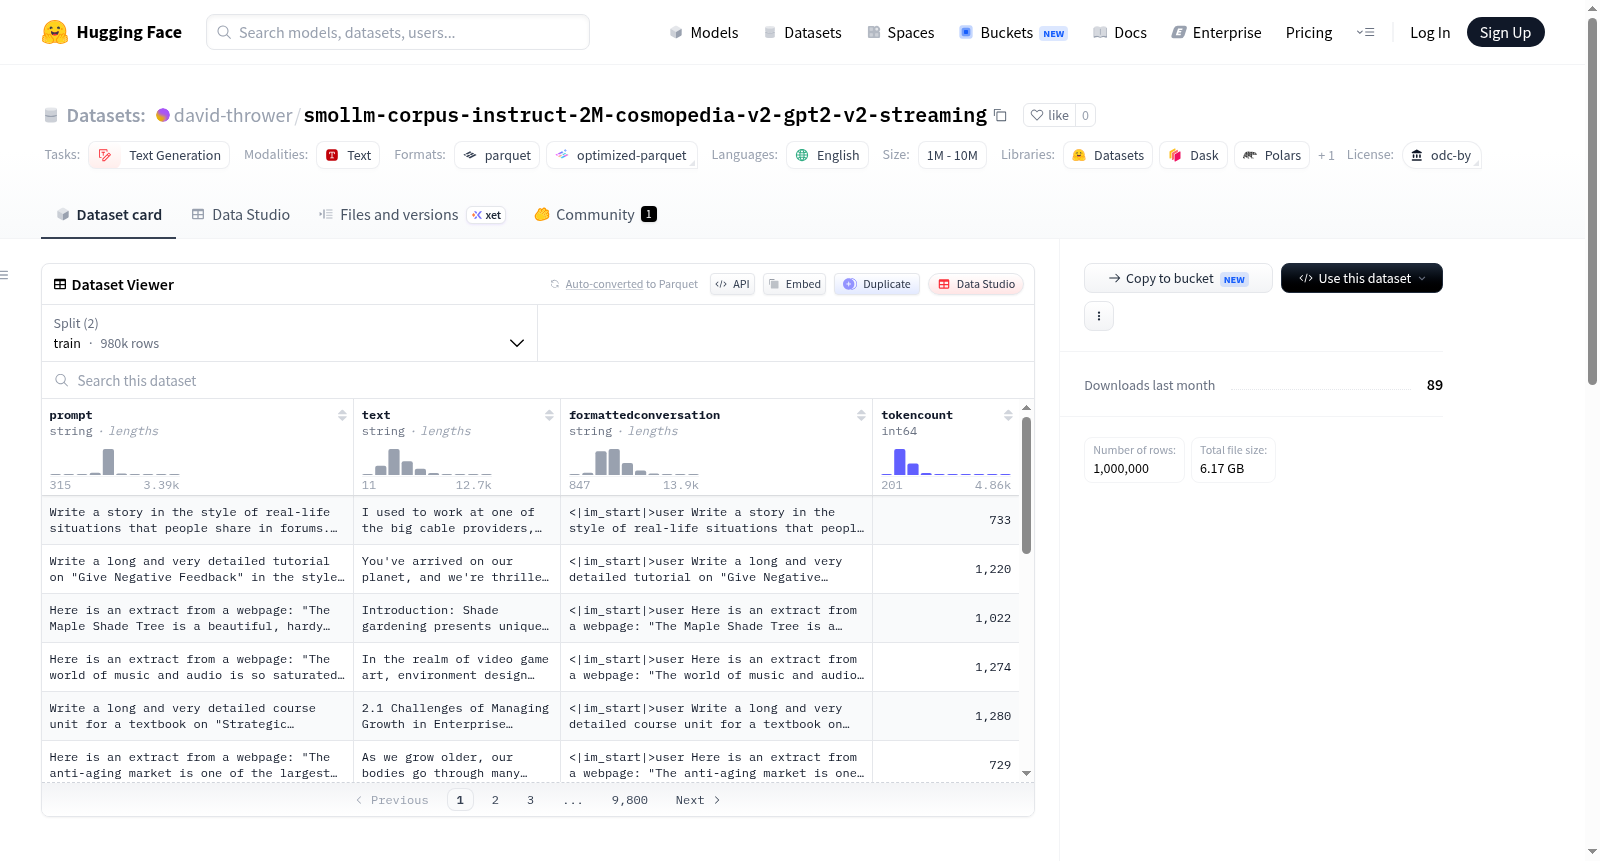
--- dataset_info: features: - name: prompt dtype: string - name: text dtype: string - name: formattedconversation dtype: string - name: tokencount dtype: int64 splits: - name: train num_bytes: 10598965781 num_examples: 980000 - name: val num_bytes: 216305424 num_examples: 20000 download_size: 6173404781 dataset_size: 10815271205 configs: - config_name: default data_files: - split: train path: data/train-* - split: val path: data/val-* ---
提供机构:
david-thrower搜集汇总
数据集介绍
构建方式
该数据集从HuggingFaceTB/smollm-corpus数据集的cosmopedia-v2分片中随机抽取子集构建而成。在原始数据的基础上,额外添加了`formattedconversation`列,该列通过拼接提示词、文本及特殊指令微调标记形成,专用于指令微调场景。同时,基于GPT2分词器结合微调特殊标记,计算并引入了`tokencount`列,以记录每条样本的标记数量,便于后续计算批次长度与训练效率。
使用方法
数据集以HuggingFace Datasets格式存储,支持流式加载以节省内存。用户可通过`load_dataset`函数指定`smollm-corpus-instruct-2M-cosmopedia-v2-gpt2-v2-streaming`名称,并选择`train`或`val`分片进行加载。在训练时,可直接使用`formattedconversation`列作为模型输入,或根据`tokencount`列筛选符合长度要求的样本,适配HelixLM等模型的训练策略。
背景与挑战
背景概述
smollm-corpus-instruct-2M-cosmopedia-v2-gpt2-v2-streaming数据集由David Thrower等研究人员于近期创建,旨在为HelixLM这一创新模型架构提供高质量指令微调数据。该数据集从HuggingFaceTB的smollm-cosmopedia-v2语料库子集中采样而来,并经过精心预处理,添加了格式化的对话列和基于GPT2分词器的token计数列,以支持基于指令的微调训练。HelixLM模型通过模拟神经科学中的神经柱与模块化概念,结合异构线性层与注意力层、循环深度及现代基础组件(如RoPE、SwiGLU、RMSNorm),实现了在小参数规模下超越更大模型的性能。该数据集在验证新型模型拓扑的有效性、推动轻量级高效语言模型发展方面具有重要影响力。
当前挑战
该数据集所解决的领域挑战在于,当前主流大规模语言模型依赖于海量参数和计算资源,难以在资源受限场景中部署,而HelixLM架构通过模块化稀疏连接与循环深度创新,力求在小参数规模下匹敌甚至超越更大模型的性能,数据集则需提供高质量指令微调样本以支撑这一目标。构建过程中面临的核心挑战包括:从原始Cosmopedia v2语料库中筛选出与指令微调任务高度相关的子集,确保数据多样性与质量平衡;设计统一的对话格式化方案,将prompt与text拼接并嵌入特殊token,以适应HelixLM模型特定的微调格式;以及基于GPT2分词器精确计算token数量,为模型训练提供可靠的序列长度控制。
常用场景
经典使用场景
在自然语言处理领域,smollm-corpus-instruct-2M-cosmopedia-v2-gpt2-v2-streaming数据集主要服务于指令微调任务,特别是针对中小规模语言模型的定制化训练。该数据集从HuggingFaceTB/smollm-corpus的cosmopedia-v2分片中精心抽样,并预处理了包含prompt、text及特殊标记的formattedconversation列,使其成为引导模型遵循指令、生成连贯回复的理想语料。其设计初衷在于为HelixLM架构的41M参数概念验证模型提供高质量微调数据,以探索模块化神经列拓扑等创新结构在语言生成中的效能。
解决学术问题
该数据集解决了中小规模模型在指令微调中缺乏高质量、结构化工语料的学术难题。传统上,大规模指令数据集如Alpaca或ShareGPT虽有效,但往往针对百亿级参数模型,难以在小模型上复现同等性能。通过提供经GPT2分词器预计算token数量及格式化对话列的数据集,研究者得以系统评估HelixLM等新架构在参数受限条件下的指令遵循能力,从而推动对模型拓扑与计算效率之间权衡的深入理解。其意义在于为轻量级模型部署开辟了新路径,证明了通过模块化设计可突破参数规模的性能瓶颈,对资源受限场景下的NLP研究具有重要启示。
实际应用
在实际应用中,该数据集可直接用于微调面向终端用户的小型对话代理、嵌入式助手或边缘设备上的文本生成模型。例如,在智能手机、物联网设备或离线环境中,基于此数据集微调的HelixLM模型能够执行简洁的指令响应、知识问答或任务导向对话,而无需依赖云端算力。此外,其预计算的token计数特性便于开发者快速估计推理成本和内存占用,使得在计算预算严格的项目中部署定制化语言模型成为可能。这种轻量化方案尤其适用于隐私敏感领域,如医疗咨询辅助或金融合规提示,因为模型可在本地运行,避免了数据传输风险。
数据集最近研究
最新研究方向
该数据集聚焦于为HelixLM等新型模型架构提供高质量指令微调语料,前沿研究重点在于探索模块化神经列拓扑结构(如cerebros-core-algorithm-alpha)与异构注意力层、循环深度及现代原语(如RoPE、SwiGLU、RMSNorm)的融合,旨在通过仿生神经科学原理提升小规模模型的推理效率与跨任务泛化能力,与当前追求高效、低参数量模型的热点趋势紧密契合,对推动边缘计算与资源受限场景下的语言模型部署具有重要影响。
以上内容由遇见数据集搜集并总结生成


