
dianavdavidson/gram-vaani-preprocessed
收藏官方服务:
资源简介:
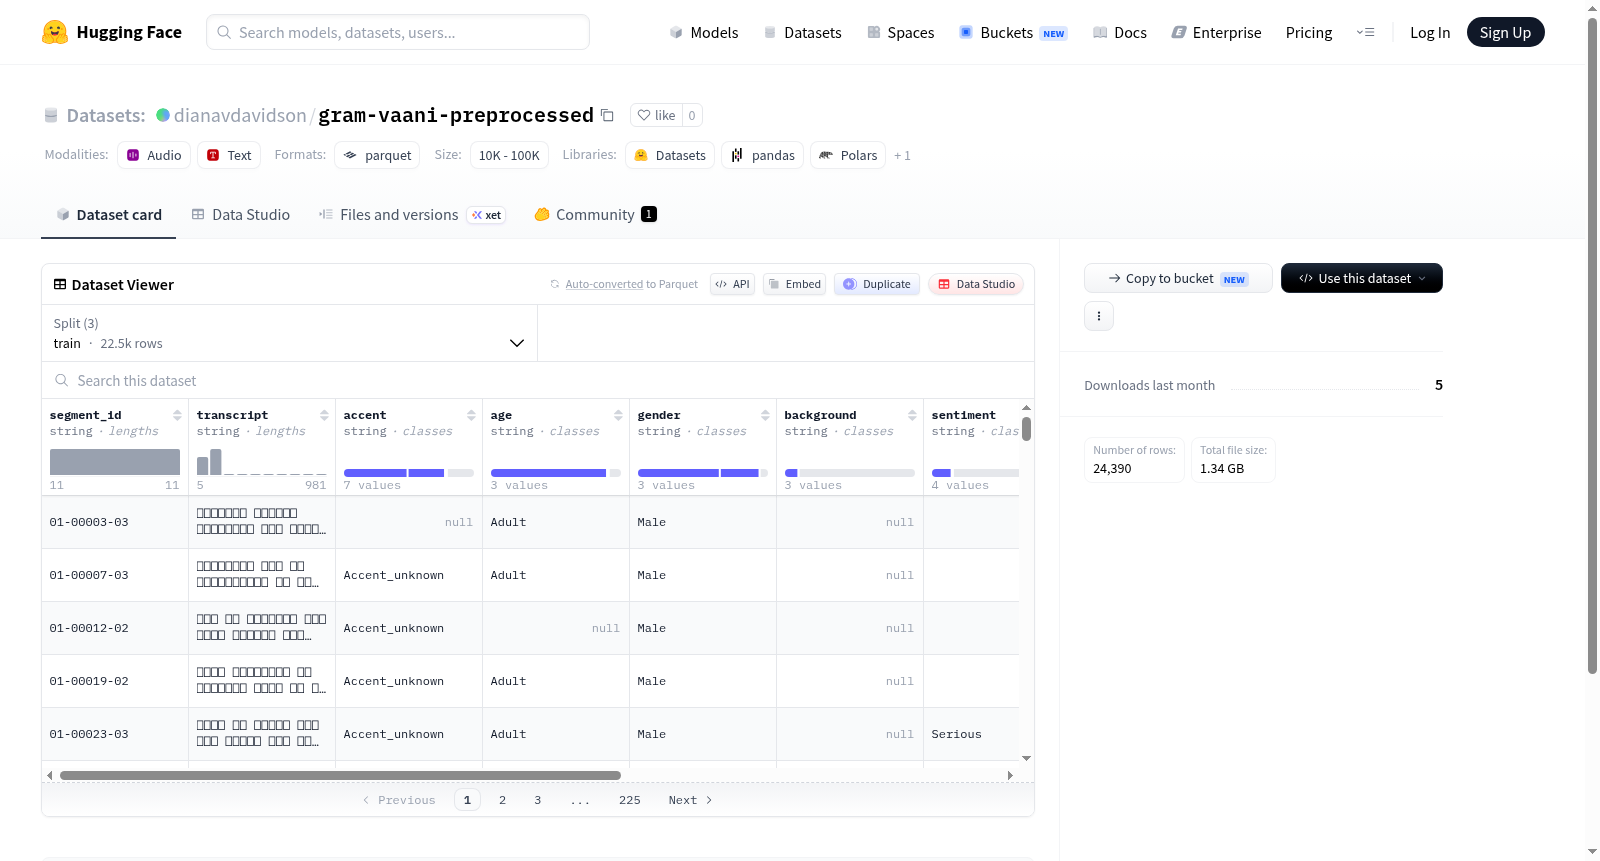
这是一个包含印地语音频及其转录文本的数据集,带有说话者的人口统计信息和情感标签。数据集包括音频特征(采样率16000Hz)、转录文本、口音、年龄、性别、背景、情感、地区、州等信息,用于语音识别或情感分析等自然语言处理任务。数据分为训练集(22454个样本)、验证集(1220个样本)和测试集(716个样本)。
This is a dataset containing Hindi audio and corresponding transcriptions, with speaker demographic information and sentiment labels. It includes audio features (sampling rate 16000 Hz), transcripts, accent, age, gender, background, sentiment, district, and state, designed for natural language processing tasks such as speech recognition or sentiment analysis. The data is split into train (22454 examples), validation (1220 examples), and test (716 examples) sets.
提供机构:
dianavdavidson搜集汇总
数据集介绍
构建方式
Gram-Vaani-Preprocessed数据集是在印度多语种语音多样性背景下构建的,专注于印地语方言。原始音频数据经过统一的16kHz采样率预处理,并针对说话人背景进行结构化标注。每条样本包含唯一的段落标识符(segment_id)、转写文本(transcript)、口音(accent)、年龄(age)、性别(gender)、背景(background)、情感(sentiment)、地区(district)和邦(state)等元信息。数据被划分为训练集(22,454条)、验证集(1,220条)和测试集(716条),总计超过24万条语音段落,覆盖广泛的声学与人口学特征,为多维度语音分析提供了坚实基础。
使用方法
数据集以Hugging Face Datasets库的标准结构存储,采用config_name 'hi'进行索引。用户可通过`load_dataset('gram-vaani-preprocessed', 'hi')`一键加载,自动获取音频波形(采样率16kHz)及所有标签字段。训练、验证、测试三个分片已预定义,可直接用于监督学习式划分。文本与离散标签(如情感、口音、邦、地区)无需额外预处理,可直接作为分类或回归任务的输入。音频路径和文本字段经标准化处理,便于与语音识别流程中的特征提取(如MFCC、Wav2Vec2)无缝对接。
背景与挑战
背景概述
在语音与语言处理领域,印度次大陆的语言多样性构成了独特而严峻的挑战,尤其是对于如印地语(Hindi)等低资源语言而言。Gram Vaani Preprocessed 数据集正是在这一背景下应运而生,由致力于方言与方言语音识别的研究人员或机构(推测为 Gram Vaani 团队)创建,旨在推动对印度方言口语的理解与处理。该数据集聚焦于印地语语音数据,核心研究问题是如何在有限资源下实现高精度的语音识别与多维度属性分析,涵盖口音、年龄、性别、背景及情感等标签。其发布不仅为方言语音识别提供了基准测试平台,更对促进印度农村及边缘化社区的语言技术普及具有深远影响,为构建包容性语音系统奠定了基础。
当前挑战
该数据集所面临的挑战是多层次的。首先,在领域问题层面,它针对的是低资源印地语语音识别中显著的方言变异与声学复杂性,例如不同地区口音(accent)的差异、年龄与性别对发音的影响,以及背景噪声的干扰——这些因素共同构成了传统语音模型在泛化能力上的瓶颈。其次,在构建过程中,数据采集面临数据稀疏性与标注一致性的严峻考验:从印度各邦(如数据集中的district和state字段所示)收集自然口语数据需克服地域覆盖不均、样本平衡困难,以及情感、背景等细粒度标签的客观标注标准缺失问题。此外,预处理流程需在保持16kHz采样率的同时,有效降噪并确保音频质量,这对自动化管线的鲁棒性提出了高要求。
常用场景
经典使用场景
Gram-Vaani-Preprocessed数据集专为印度印地语语音识别与声学建模研究而设计,其核心应用场景聚焦于多维度语音数据的深度挖掘。该数据集包含了22454条训练样本、1220条验证样本和716条测试样本,每条数据均配备16kHz采样率的音频文件及丰富的元信息,如说话人的口音、年龄、性别、背景、情感状态、所属地区及邦。这使得它成为研究语音信号中社会语言学变异性(例如地域口音差异、年龄相关语速变化、情感对声学特征的影响)的理想资源,尤其适用于构建鲁棒的、跨人群的自动语音识别(ASR)系统。
解决学术问题
该数据集有效解决了印地语语音识别研究中长期存在的两大瓶颈:数据稀缺性与人口统计多样性不足。通过系统性地标注说话人的人口统计学属性(如地区、年龄、情感状态),它为探究非标准发音与上下文干扰因素提供了量化工具。研究者可借此分析语音识别系统在特定群体(如老年用户或特定方言区)的性能偏差,进而开发对抗性去偏算法或自适应声学模型。其意义在于推动了低资源语言语音技术的公平性与泛化能力提升,促进了多语言社会场景下人机交互的包容性发展。
实际应用
在实际应用中,Gram-Vaani-Preprocessed数据集可赋能多项语音科技产品。例如,基于其标注的年龄与情感元数据,可开发面向印度老年群体的智能语音助手,通过适老化声学模型提升交互体验;借助地区口音信息,可优化客服中心的语音转录系统,使其准确理解来自不同邦的客户需求;结合情感标签,还能构建用于心理健康筛查的语音情感分析工具。这些场景均受益于数据集对真实世界声学环境与社会人口维度的细致刻画。
数据集最近研究
最新研究方向
Gram-Vaani-Preprocessed数据集是面向印度多语种语音识别与方言理解的前沿资源,尤其聚焦于印地语及其地域变体的细粒度建模。该数据集通过标注口音、年龄、性别、背景、情感及地理分布等多元元数据,为研究语音信号中的社会语言变异提供了结构化基础。当前,其应用方向紧密关联低资源语言领域的自监督预训练与迁移学习突破,例如利用wav2vec 2.0或HuBERT等模型在有限标注样本下捕捉方言特征。此外,情感与背景标签的引入使该数据集成为探索语音情感识别及多模态社会感知计算的热门选择,尤其在印度多语言融合的社会技术场景中,对构建包容性语音助手和方言适应系统具有显著实践价值。
以上内容由遇见数据集搜集并总结生成


