
softcatala/ca_text_corpus
收藏原始信息汇总
数据集概述
数据集基本信息
- 名称: ca-text-corpus
- 语言: 加泰罗尼亚语 (
ca) - 许可证: CC0 1.0 Universal
- 多语言性: 单语种
- 大小: 1M<n<10M
- 来源: 原创数据
- 任务类别: 文本生成
- 任务ID: 语言建模
数据集描述
数据集摘要
- 描述: 公共领域的加泰罗尼亚语文本语料库。
支持的任务和排行榜
- 信息: 待补充
语言
- 语言: 加泰罗尼亚语 (
ca)
数据集结构
数据实例
- 信息: 待补充
数据字段
- 信息: 待补充
数据分割
- 信息: 待补充
数据集创建
来源数据
- 初始数据收集和规范化: 待补充
- 源语言生产者: 待补充
注释
- 注释过程: 待补充
- 注释者: 待补充
个人和敏感信息
- 信息: 待补充
使用数据的考虑
数据集的社会影响
- 信息: 待补充
偏见的讨论
- 信息: 待补充
其他已知限制
- 信息: 待补充
附加信息
数据集管理者
- 信息: 待补充
许可证信息
- 许可证: CC0 1.0 Universal
引用信息
- 信息: 待补充
贡献者
- 贡献者: @albertvillanova
搜集汇总
数据集介绍
构建方式
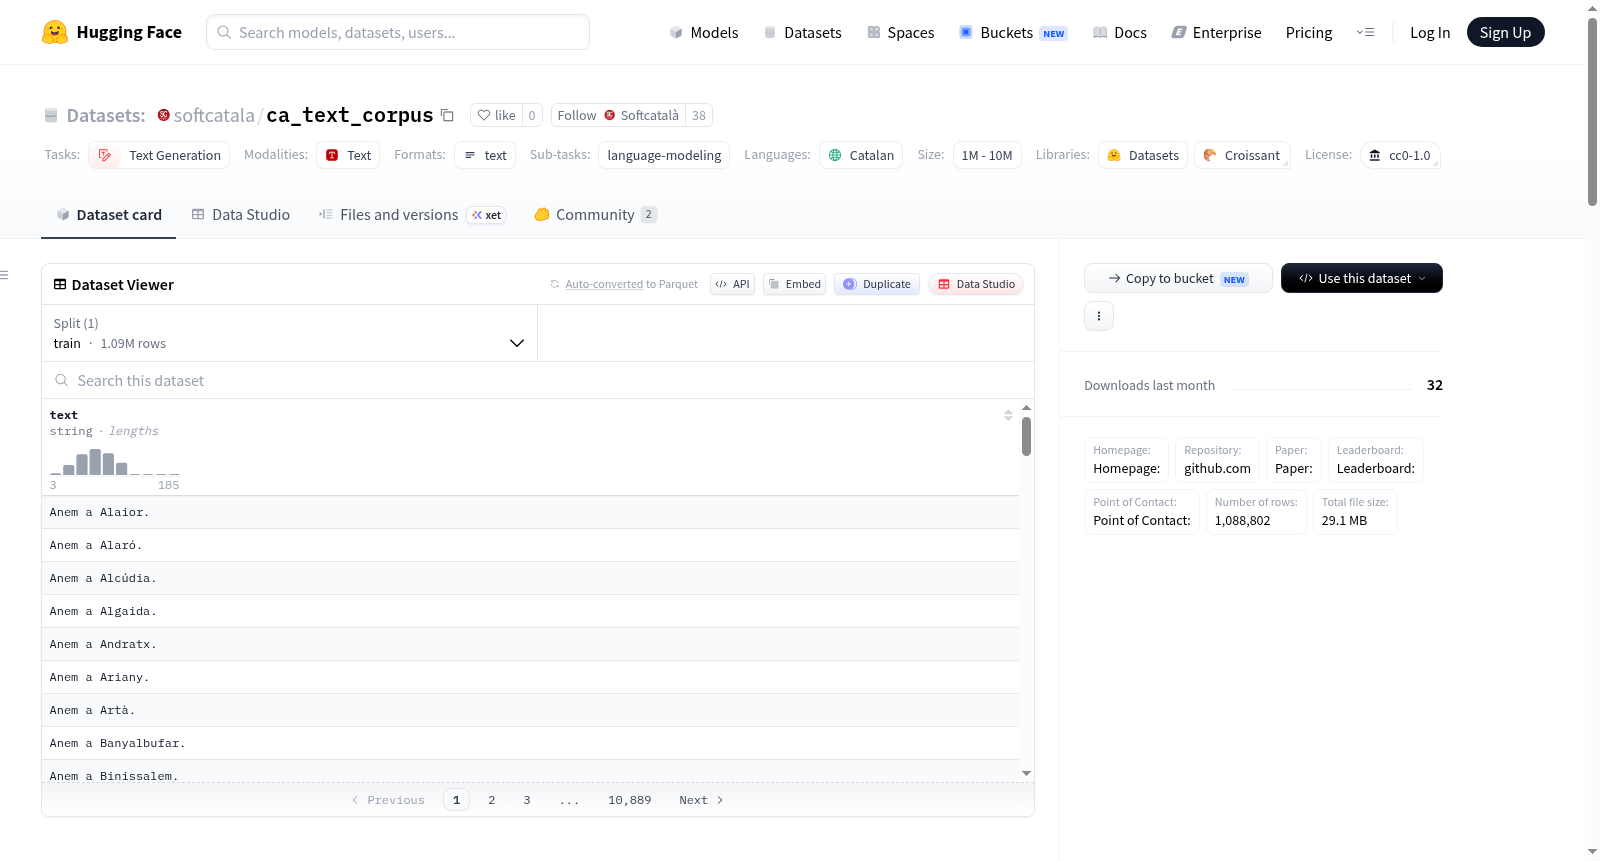
ca_text_corpus数据集旨在为加泰罗尼亚语技术项目提供可复用的公共领域文本资源。该语料库通过整合多种来源的短句与片段构建而成,涵盖常见表达、谚语、从加泰罗尼亚政府公报及巴伦西亚政府公报中遴选的公开文本、Riurau Editors出版社的出版物、Softcatala网站内容、开源书籍《自由软件:技术上可行、经济上可持续且社会公正》的节选、Common Voice项目的句子贡献,以及加泰罗尼亚语地区的地名信息。所有文本均源自公共领域或具有宽松许可协议,确保了法律上的可复用性。
特点
该数据集以简洁性为核心特点,每个样本均为加泰罗尼亚语的句子或极短文本片段,仅包含单一的'text'字段,无任何语言标注或元数据。语料库规模约为数百万条,专为语言建模与文本生成等任务设计。然而,其覆盖范围存在显著偏向:短句、谚语、公共管理文本、经过整理的公共领域素材以及地理名称占据主导地位,未能均衡反映现代加泰罗尼亚语的全貌、方言多样性或口语化表达,因此更适合作为辅助性资源而非独立语料库。
使用方法
数据集以单一'train'分割提供,便于直接加载使用。用户可通过Hugging Face Datasets库快速导入,例如使用`load_dataset('Softcatala/ca_text_corpus')`命令即可获取文本数据。该语料库适用于加泰罗尼亚语的语言模型预训练、文本生成实验、句子候选筛选,或为语音合成与识别系统提供提示句来源。由于采用CC0 1.0通用许可证,研究者可以自由地将其整合到下游项目中,无需附加版权限制。
背景与挑战
背景概述
在自然语言处理领域,低资源语言的语料库构建始终是推动语言技术普惠化与多样性的关键环节。ca_text_corpus数据集由致力于加泰罗尼亚语言数字化的非营利组织Softcatala于近期创建,旨在为加泰罗尼亚语这一全球逾千万人使用的罗曼语族语言提供开放、可复用的文本资源。该数据集聚焦于语言建模与文本生成等基础任务,通过汇集公共领域或宽松许可下的短句、谚语、行政公报摘录及地理名称等素材,构建了一个约百万句级规模的单语语料库。其核心研究问题在于突破加泰罗尼亚语在技术工具开发中的数据稀缺瓶颈,支撑下游任务如语音合成的提示句选取或语言模型预训练,对加泰罗尼亚语人机交互与数字存续具有显著推动作用,也为其他低资源语言的语料建设提供了可参照的协作范式。
当前挑战
当前数据集面临双重挑战。领域层面,加泰罗尼亚语作为低资源语言,长期受限于互联网语料的匮乏及商业技术投入不足,使其在机器翻译、对话系统等前沿NLP任务中难以获得与高资源语言同等质量的表现;该数据集虽缓解了基础文本数据的可用性问题,但其规模远小于现代大规模预训练语料,难以单独支撑对当代加泰罗尼亚语用法、方言变体及口语化表达的泛化建模。构建过程中,挑战集中于数据源的多样化与平衡性:尽管整合了政府公报、志愿者贡献、地理名录等碎片化来源,但样本结构显著偏向短句、谚语及行政文本,缺乏对新闻、社交网络及学术文献等复杂体裁的系统覆盖,且未加入人工标注,限制了其在语义理解等任务中的直接应用。此外,质量控制依赖原始来源的公共领域属性,缺乏对敏感信息的主动筛查机制,增大了下游使用时的伦理风险。
常用场景
经典使用场景
在加泰兰语自然语言处理的研究版图中,ca_text_corpus作为一种高质量且许可开放的小型语料库,最经典的用途是作为语言建模和文本生成的基准数据集。研究者可依托其中丰富的短句、谚语及官方公报文本,训练或微调针对加泰兰语的神经语言模型,从而在低资源语言场景下评估模型对词汇、句法和语义的捕捉能力。此外,该数据集常被用于句子选择任务,为构建语音数据集挑选合适的提示语句,体现了其在多模态语言技术中的桥梁作用。
解决学术问题
针对加泰兰语这类中低资源语言,ca_text_corpus有效缓解了因高质量公开文本稀缺而导致的研究困境。它解决了传统语料库难以兼顾许可友好性与语言多样性的问题,使学术团队能够在合法合规的前提下开展语言统计特征分析、词汇覆盖度评估以及跨语言模型迁移效果的对比实验。该数据集的公开共享显著推动了加泰兰语基本语言技术工具的研发,为后续更复杂的句法分析和语义理解任务奠定了数据基础,对保护语言多样性具有深远意义。
衍生相关工作
基于ca_text_corpus,学术界和工业界衍生出多项富有启发性的工作。研究团队常将其作为加泰兰语子网络爬虫数据的校正集,用于提升大规模抓取文本的清洗质量;也有工作利用该语料库中的谚语和公共文本,构建加泰兰语到其他语言的小型平行语料,支持机器翻译系统的冷启动。此外,该数据集成为“开源语音技术”社区的重要支柱,其句子被广泛选入Common Voice等众包语音项目,间接催生了对低资源语言声学模型预训练方法的系统性探索,推动了加泰兰语语音合成与识别技术的突破。
以上内容由遇见数据集搜集并总结生成


