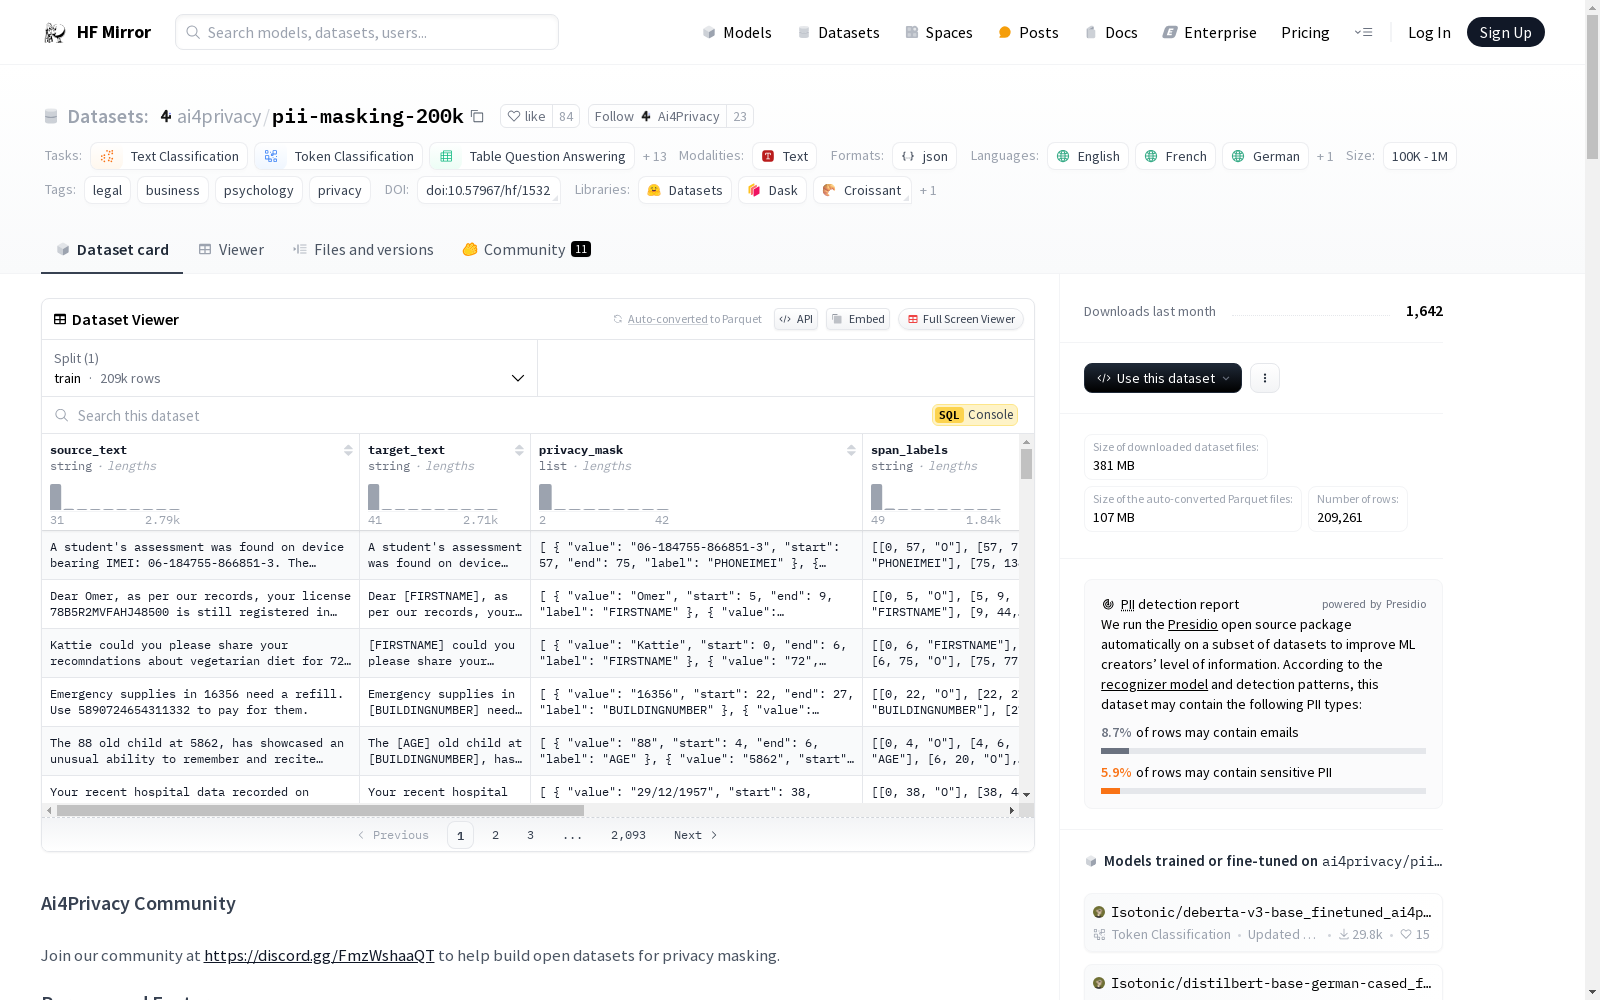
ai4privacy/pii-masking-200k
收藏资源简介:
Ai4Privacy PII200k数据集是一个用于训练模型以从文本中移除个人可识别信息(PII)的多语言数据集,特别是在AI助手和大型语言模型(LLMs)的上下文中。数据集包含约209k个示例,涵盖了54种PII类别,针对229个讨论主题/用例,分布在商业、教育、心理学和法律等领域,并采用了5种交互风格。数据集通过专有算法生成,并经过人工验证以确保高质量。数据集支持英语、法语、德语和意大利语,未来将支持更多语言。
The Ai4Privacy PII200k Dataset is a multilingual dataset designed for training models to remove personally identifiable information (PII) from text, specifically in the context of AI assistants and large language models (LLMs). The dataset contains approximately 209,000 examples, covering 54 PII categories, targeting 229 discussion topics/use cases across domains such as business, education, psychology, and law, and adopting 5 interaction styles. It was generated using proprietary algorithms and manually validated to ensure high data quality. The dataset supports English, French, German and Italian, with plans to support more languages in the future.
数据集概述
基本信息
- 名称: Ai4Privacy PII200k Dataset
- 大小: 13.6m text tokens in ~209k examples with 649k PII tokens
- 语言: 英语、法语、德语、意大利语
- 数据来源: 原始数据,使用专有算法生成的合成数据
- 数据质量: 经过人机交互验证的高质量数据集
任务类别
- 文本分类
- 令牌分类
- 表格问答
- 问答
- 零样本分类
- 摘要
- 特征提取
- 文本生成
- 文本到文本生成
- 翻译
- 填充掩码
- 表格分类
- 表格到文本
- 文本检索
- 其他
应用领域
- 法律
- 商业
- 心理学
- 隐私
数据集结构
- 文件格式:
.jsonl - 数据内容:
- source_text: 包含PII的自然语言文本
- target_text: PII免费的自然文本
- privacy_mask: PII令牌实例与自然文本中字符串之间的映射
- span_labels: 开始、结束位置及PII令牌实例的数组
- mbert_bio_labels: 私人令牌开始位置的通用表示
- mbert_text_tokens: 使用Bert家族分词器分解的未屏蔽句子令牌
- 元数据: 包括ID、语言和数据集类型(训练、测试等)
兼容的机器学习任务
- 令牌分类: 使用多种模型,如ALBERT、BERT、BigBird等
- 文本生成: 映射未屏蔽文本到屏蔽文本或隐私掩码属性
数据集用途
- 训练模型以移除文本中的个人身份信息(PII),特别是在AI助手和LLMs的上下文中。
- 包含54种PII类别,针对229个讨论主题/用例,跨越商业、教育、心理学和法律领域。