
遇见数据集

ucsbai/SAW-Bench

收藏
Hugging Face2026-06-28 更新2026-07-22 收录
官方服务:

资源简介:

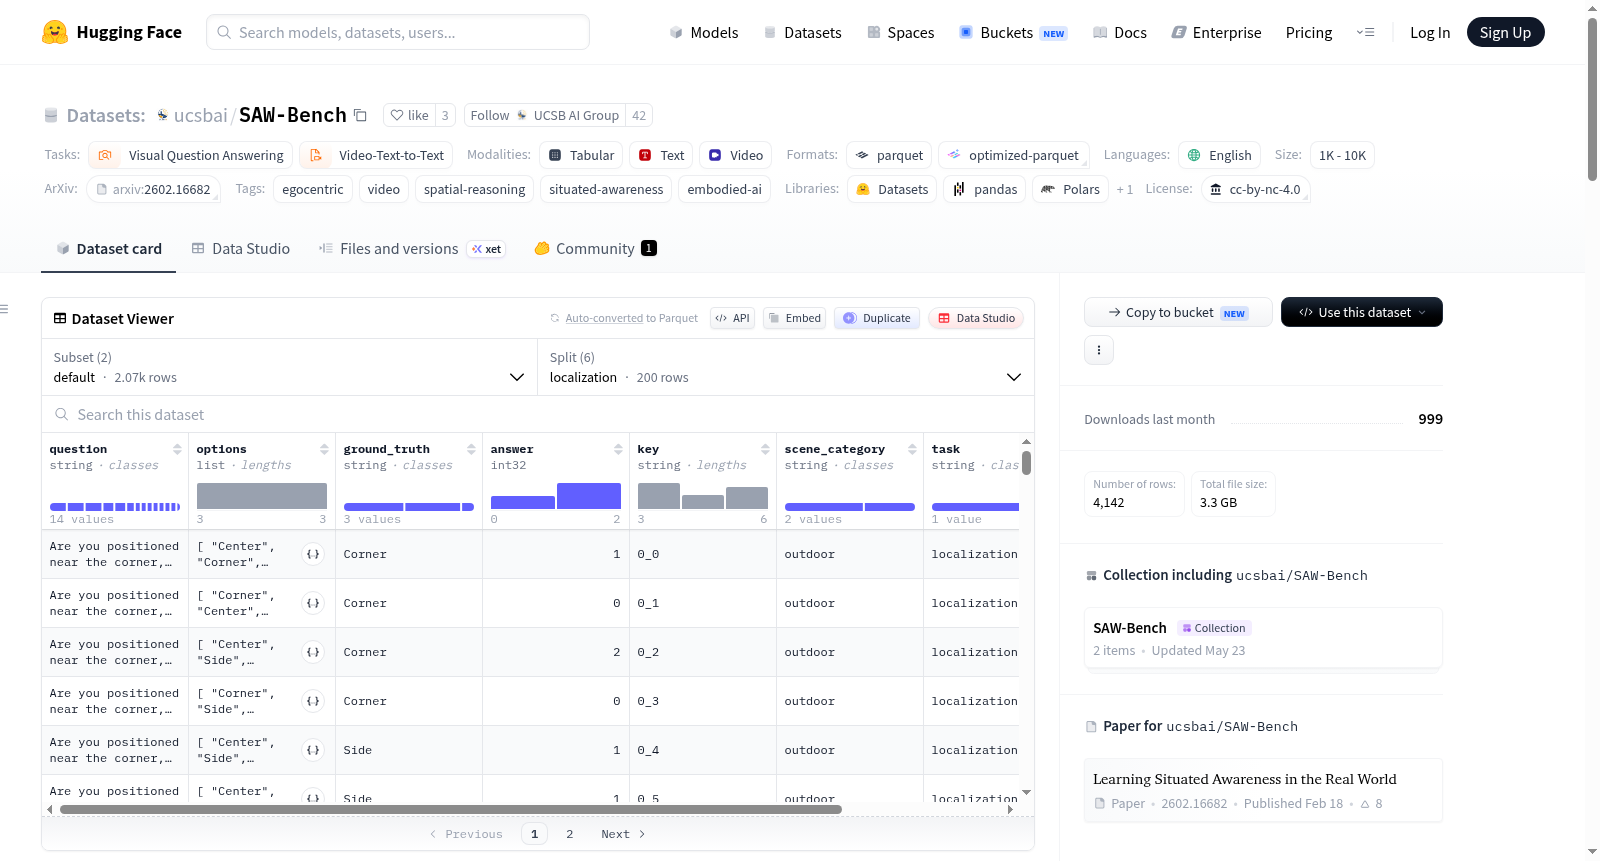
SAW-Bench(真实世界中的情境感知基准测试)是一个用于评估多模态基础模型中“观察者中心”情境感知能力的基准测试,即从自我中心视角随时间推移推理空间、运动和可能行动的能力。与先前强调“环境中心”关系(场景中物体如何相互关联)的基准测试不同,SAW-Bench探究模型是否能从自我中心视频中保持一致的观察者中心空间状态。它包含786个使用Ray-Ban Meta(第二代)智能眼镜捕获的真实世界视频,以及2,071个人工标注的问答对,涵盖六项任务:定位(在空间中的位置)、方向(目标相对于当前朝向的位置)、形状(行进路径的形状)、反向规划(如何返回起点)、记忆(两次访问间场景的变化)和可操作性(从当前姿态可行的行动)。即使最佳模型也落后人类表现37.66%。数据集适用于非商业学术研究,遵循CC BY-NC 4.0许可证。

SAW-Bench (Situated Awareness in the Real World) is a benchmark for evaluating observer-centric situated awareness in multimodal foundation models — the ability to reason about space, motion, and possible actions relative to ones own egocentric viewpoint as it evolves over time. Unlike prior benchmarks that emphasize environment-centric relations (how objects relate to each other in a scene), SAW-Bench probes whether a model can maintain a coherent observer-centric spatial state from egocentric video. It comprises 786 real-world videos captured with Ray-Ban Meta (Gen 2) smart glasses and 2,071 human-annotated question–answer pairs across six tasks: localization, direction, shape, revplan, memory, and affordance. Even the best model trails humans by 37.66%. The dataset is for non-commercial academic research only, under CC BY-NC 4.0 license.
提供机构:
ucsbai
搜集汇总
数据集介绍
ucsbai/SAW-Bench 数据集图片
构建方式
SAW-Bench是一个专为评估多模态基础模型情境感知能力而设计的基准数据集。其构建基于786段由佩戴Ray-Ban Meta第二代智能眼镜的参与者自主录制的真实世界第一视角视频,覆盖室内与室外多种场景。研究人员针对这些视频精心设计了2,071个经过人工标注的多选题,涵盖定位、方向、路径形状、回溯规划、记忆与功能可供性等六大任务维度,以系统考察模型从自我中心动态视角进行空间、运动及可行行动推理的能力。
使用方法
研究者可通过HuggingFace Datasets库便捷加载数据:使用`load_dataset("ucsbai/SAW-Bench", split="direction")`按任务分片获取问答对,或使用`load_dataset("ucsbai/SAW-Bench", "all", split="test")`加载全部任务。视频文件则需通过`snapshot_download`工具单独下载,并存储至本地目录。完整的评估流程,包括视频下载、模型推理、答案解析与得分计算,可参照其GitHub仓库中提供的标准化流水线实现。
背景与挑战
背景概述
在具身人工智能与多模态基础模型快速发展的背景下,模型对环境的理解往往局限于静态的物体间关系,而忽视了观察者自身在动态空间变化中的位置感知。SAW-Bench(Situated Awareness in the Real World)数据集于2026年由加州大学圣塔芭芭拉分校等机构的研究人员创建,旨在系统评估模型的第一人称情境意识——即从自我中心的视角随时间推移推理空间、运动及可行行动的能力。该数据集包含786段由Ray-Ban Meta智能眼镜采集的真实世界视频,以及2,071个经人工标注的多选题问答对,覆盖定位、方向、路径形状、返回规划、场景变化记忆和可行动作共六个任务。SAW-Bench填补了现有基准过于侧重环境中心表征的空白,将评估焦点转向观察者中心的空间推理,推动了多模态模型在真实世界具身场景中能力边界的认识。
当前挑战
SAW-Bench所解决的领域核心挑战在于,现有视觉问答与视频理解基准多关注场景中物体与物体的空间关系,却极少考察模型能否在时空演化中维持对自我位置的连贯表征,即缺乏对情境意识的系统度量。此外,构建过程面临两大困难:一是真实世界自我中心视频的录制难以避免隐私问题,需对偶然入镜的行人及可识别位置进行处理并制定严格的使用规范;二是任务设计的多样性要求从持续性视频中提取细粒度的空间轨迹信息,如路径形状的判别和往返动作的规划,这对人工标注的准确性与一致性提出了极高要求。即便当前最强模型的表现仍落后人类37.66%,凸显了这一挑战的艰巨性。
常用场景
经典使用场景
SAW-Bench作为评估多模态基础模型情境感知能力的标杆,其经典使用场景聚焦于以自我为中心的视觉推理任务。研究人员利用该基准测试模型在六个核心维度上的表现:空间定位(判断观察者所处的空间位置)、方向感知(识别目标相对于自身朝向的相对方位)、路径形状理解(推断所经过轨迹的几何形态)、逆向规划(规划返回起始点的路径)、场景记忆(感知两次访问间的场景变化)以及可行动作推断(从当前姿态判别可执行的操作)。这些任务共同构成了对模型在真实世界动态环境中维持连贯自我中心空间状态能力的系统检验。
解决学术问题
该数据集解决了学术研究中多模态模型缺乏从第一人称视角动态理解空间关系的核心难题。传统视觉问答基准多关注场景中物体之间的静态关系,而SAW-Bench则聚焦于观察者自身与环境的动态交互,揭示了现有最先进模型在此类任务上与人类表现存在37.66%的悬殊差距。这一发现推动学术界重新审视情境感知能力在具身人工智能中的定义与评估方式,促使研究者关注模型是否能够真正理解自身的时空位置、运动历史以及环境可行性,而非仅停留在目标识别层面。
实际应用
在实际应用层面,SAW-Bench所衡量的能力直接服务于增强现实导航、智能眼镜辅助系统、自主机器人导航以及人机协作等前沿领域。例如,增强现实设备需要实时感知佩戴者所处的空间方位以叠加精准的导航信息;服务机器人必须理解自身相对于环境的位置才能执行灵活的避障与路径规划;智能辅助系统则需觉察用户在真实场景中的行动可行性以提供及时的指导。该基准为这些应用场景中的模型评估提供了标准化的测试框架。
数据集最近研究
最新研究方向
SAW-Bench聚焦于多模态基础模型在真实世界第一人称视频中的情境感知能力评估,通过六大任务(空间定位、方向判断、路径形状推理、逆向路径规划、场景记忆变化及可操作行为推断)系统探测模型从自我中心视觉流中维持连贯观察者空间状态的能力。该基准挑战了传统以环境为中心的空间关系推理范式,揭示了当前最先进模型与人类水平间37.66%的显著鸿沟,直接呼应具身智能体在无地图导航、动态场景理解与自主决策等前沿热点领域的迫切需求。其采用Ray-Ban Meta智能眼镜采集的786段真实第一人称视频,为打破实验室模拟与现实复杂环境之间的域迁移壁垒提供了关键数据支撑,对推动应用于服务机器人、增强现实与辅助技术等领域的情境推理算法具有里程碑式的基础价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

