Nemotron-RL-Instruction-Following-Citation-Formatting-v1-prompt-only
收藏资源简介:
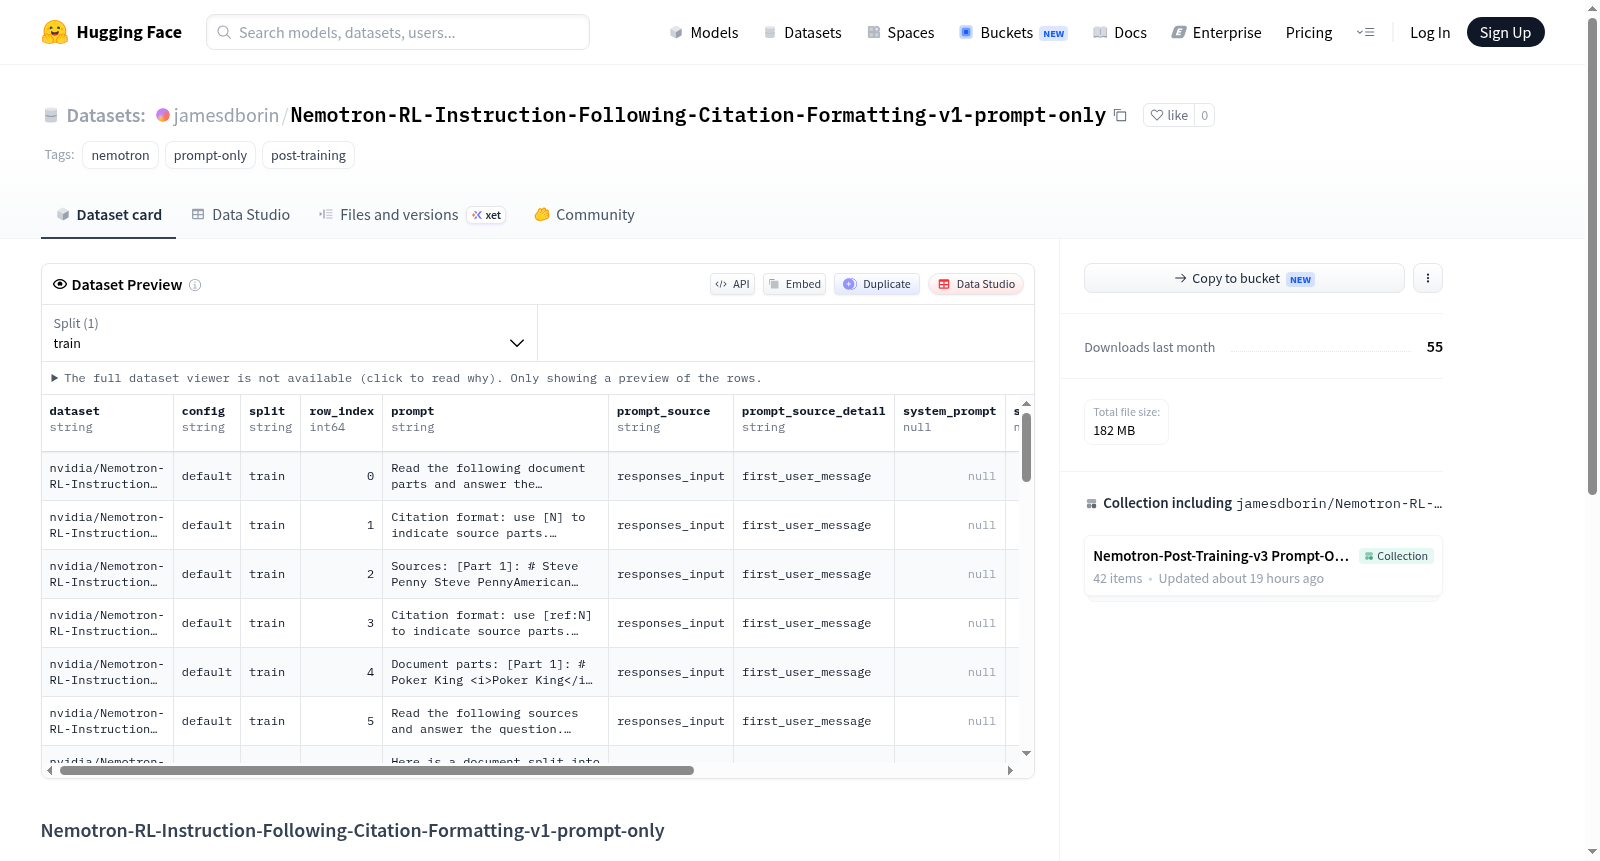
Nemotron-RL-Instruction-Following-Citation-Formatting-v1-prompt-only 是一个专门从源数据集 nvidia/Nemotron-RL-Instruction-Following-Citation-Formatting-v1 中提取的提示集合数据集,专注于指令遵循和引文格式化任务。它属于Nemotron项目的一部分,专为强化学习后训练场景设计,标签包括 nemotron、prompt-only 和 post-training。数据集核心文件为 prompts.csv,包含9540条提取记录,每条记录提供用户提示、分离的系统提示以及结构化的可用工具定义(当源行定义了工具时),其中嵌套值以JSON格式编码存储在CSV单元格中。此外,数据集还包括 summary.md(提供源行数、提取行数、行数差异和失败提示计数的统计摘要)和 null_or_empty_rows.md(记录提示提取为空或无效的行索引)。统计摘要显示提取行数为9540,失败行数为0,行数差异为0,表明数据提取完整且无错误。该数据集由 jamesdborin 通过 Nemotron Post-Training v3 提示提取工作流上传,适用于语言模型的指令微调、强化学习对齐或任务特定评估,尤其适合需要结构化提示和工具定义的研究与应用。
Nemotron-RL-Instruction-Following-Citation-Formatting-v1-prompt-only is a prompt-only dataset specifically extracted from the source dataset nvidia/Nemotron-RL-Instruction-Following-Citation-Formatting-v1, focusing on instruction-following and citation formatting tasks. It is part of the Nemotron project, designed for reinforcement learning post-training scenarios, with labels including nemotron, prompt-only, and post-training. The core file is prompts.csv, containing 9,540 extracted records, each providing a prompt (user prompt), a separate system_prompt, and structured tools (available tool definitions when defined in the source row), with nested values encoded in JSON format within CSV cells. Additionally, the dataset includes summary.md (providing statistical summaries of source row count, extracted row count, row difference, and failed prompt count) and null_or_empty_rows.md (recording row indices where prompt extraction was null or invalid). The statistical summary shows an extracted row count of 9,540, failed row count of 0, and row difference of 0, indicating complete and error-free data extraction. This dataset was uploaded by jamesdborin via the Nemotron Post-Training v3 prompt extraction workflow and is suitable for instruction fine-tuning of language models, reinforcement learning alignment, or task-specific evaluation, particularly for research and applications requiring structured prompts and tool definitions.