finance-news-sentiment-35k
收藏资源简介:
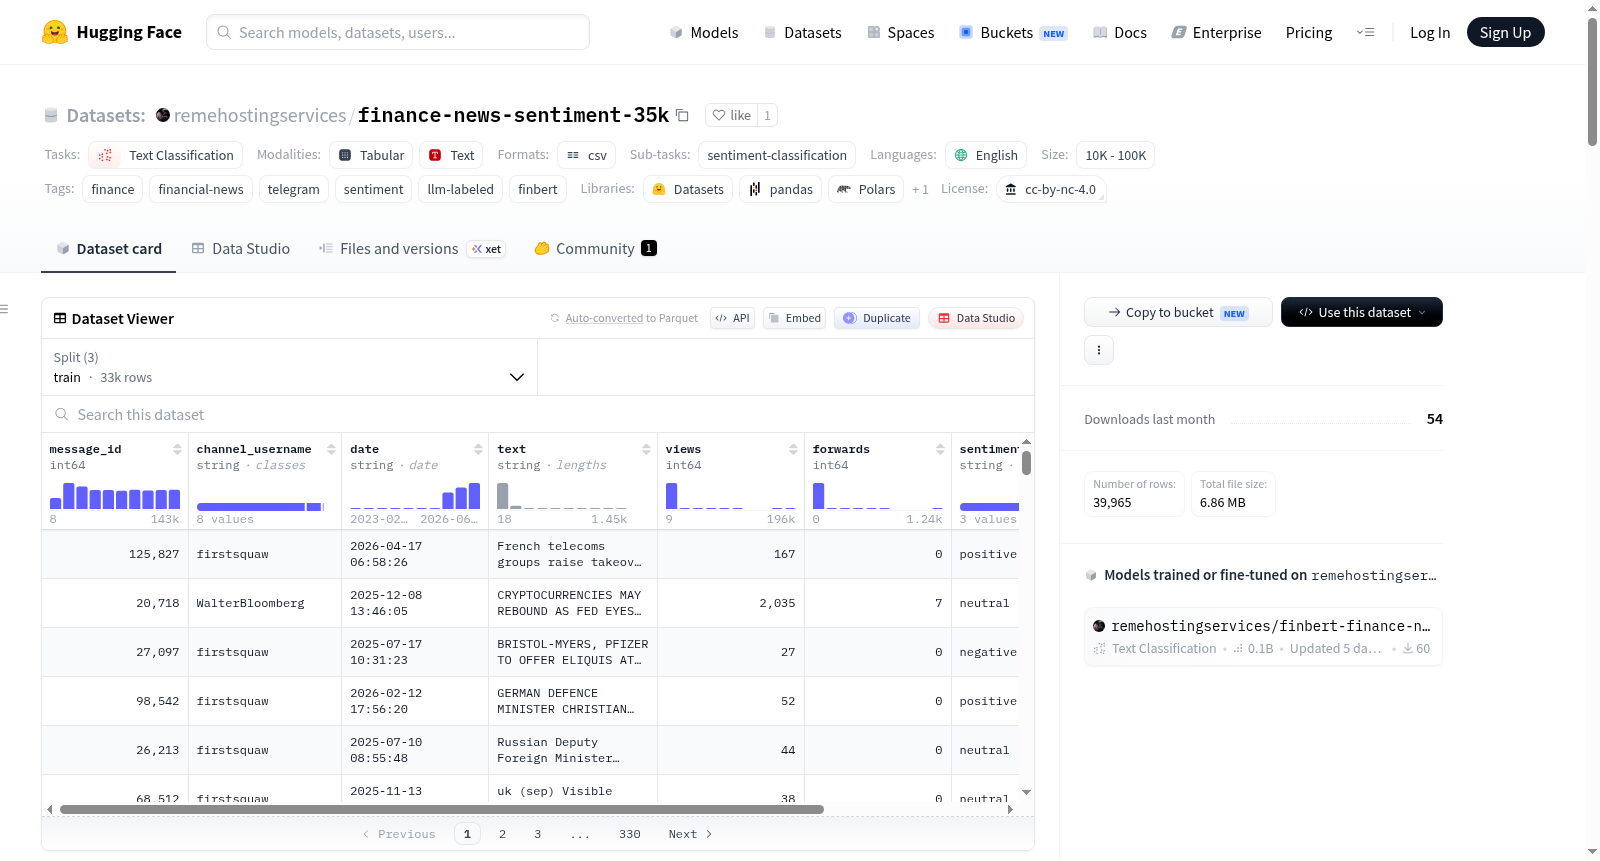
该数据集包含39,965条英文财经新闻标题,来自公开的Telegram财经新闻频道。每条标题由两个LLM(Claude Opus 5和OpenAI gpt-5.6-sol)进行三分类情感标注(正面/负面/中性)和二级主题标签标注,分歧由更强模型仲裁。数据覆盖8个频道,95%来自两个频道,约99%的行来自最近12个月(2025年6月至2026年6月)。划分为训练集(32,970行)、验证集(3,495行)和测试集(3,500行),按情感分层。情感分布:训练集中正面16.5%、负面23.2%、中性60.3%。主题标签分布:地缘政治15,533、宏观10,385、股票7,687、大宗商品2,763、其他1,682、加密货币1,132、监管783。适用于金融新闻情感分类和主题分类任务。
This dataset contains 39,965 English financial news headlines collected from public Telegram financial news channels. Each headline is annotated by two independent LLM judges (Claude Opus 5 and OpenAI gpt-5.6-sol) with three-class sentiment (positive/negative/neutral) and secondary topic labels according to a unified rulebook. Disagreements are resolved by a stronger model (Claude Fable 5). Data comes from 8 channels, with two channels contributing about 95% of the data, and about 99% of rows from the last 12 months (June 2025 to June 2026). The dataset is split into training (32,970 rows), validation (3,495 rows), and test (3,500 rows), stratified by sentiment. Sentiment distribution: training set has 16.5% positive, 23.2% negative, 60.3% neutral. Topic label distribution: geopolitics 15,533, macro 10,385, stocks 7,687, commodities 2,763, other 1,682, crypto 1,132, regulation 783. Suitable for financial news sentiment classification and topic classification tasks.
Finance News Sentiment 40k 数据集总结
基本信息
- 数据集名称:Finance News Sentiment 40k
- 规模:39,965 条英文金融新闻标题(符合 10K<n<100K 规模类别)
- 许可证:CC BY-NC 4.0(仅针对标注内容,新闻文本归属原始来源)
- 语言:英文
- 任务类型:文本分类(情感分类)
- 标签:金融、金融新闻、Telegram、情感、LLM 标注、FinBERT
数据内容
数据集划分
| 划分 | 行数 | positive | negative | neutral |
|---|---|---|---|---|
| train | 32,970 | 16.5% | 23.2% | 60.3% |
| validation | 3,495 | 16.1% | 23.0% | 60.9% |
| test | 3,500 | 16.1% | 23.0% | 60.9% |
字段说明
message_id:Telegram 频道内消息 IDchannel_username:信息来源频道date:发布时间戳(UTC)text:英文新闻标题/短文本views、forwards:采集时的互动计数sentiment:三分类情感标签(positive/negative/neutral),定义针对投资者视角的新闻好坏reason:主题分类,包括 geopolitics(15,533)、macro(10,385)、equities(7,687)、commodities(2,763)、other(1,682)、crypto(1,132)、regulatory(783)
数据来源
- 来自 8 个公开 Telegram 金融新闻频道(2023年2月至2026年6月)
- 经去重的 142k 消息池中采样生成
- 两个主要频道占总数据 95%(firstsquaw 83.0%,WalterBloomberg 12.2%)
- 约 99% 的数据来自最近 12 个月(2025年6月-2026年6月),地理政治(伊朗/霍尔木兹)、关税和美联储政策相关新闻占比较高
标注方法
- 盲标打包:数据随机打乱后以 40 条为一组,仅包含 ID 和文本
- 双模型独立标注:Claude Opus 5 与 OpenAI gpt-5.6-sol(通过 Codex)遵循同一书面规则独立标注
- 仲裁机制:分歧数据由更强模型 Claude Fable 5 逐条仲裁
- v1 标注一致性:两模型在 v1 数据上同意率为 85.4%,盲审计同意率为 91.3%-94.3%
- v2 主动学习扩充:新增 4,997 行(基于 v1 模型最不确定的 3,999 条 + 1,001 条随机样本),两模型同意率降至 81.0%
版本信息
| 版本 | 行数 | 训练集 | 特点 |
|---|---|---|---|
| v1(2026-09-03) | 34,968 | 27,973 | 随机样本,80/10/10 分层划分 |
| v2(2026-09-04) | 39,965 | 32,970 | 基于主动学习增加 4,997 行 |
验证集和测试集在两版本中字节级一致,可保持测试结果可比。
模型性能
基于该数据集微调的 FinBERT 模型达到测试准确率 0.847 / 宏平均 F1 0.810。
标注质量审计发现
- 分歧主要是阈值问题:11% 的样本存在情感分歧,其中 94% 是中性↔方向性的边界问题
- 置信度可预测分歧:双方模型均给出"高置信度"时(占 41%),分歧率仅 0.4%
- 仲裁偏向受会话影响:仲裁者对 Opus 5 的 ~70% 偏向属于特定生产会话特征,新会话中该偏向接近随机
- 模型误差与标注模糊性相关:在双方高置信度一致的样本上模型错误率 3.4%,仲裁样本上错误率高达 42.9%
局限性
- 无人工金标准:标签由 LLM 生成,预期模型在该数据上测试集准确率上限约为 0.85
- 中性类别宽泛:日常数据发布、政治声明和小幅价格变动被设计性地归为中性
- 来源与时间集中:单一频道占主导,数据集中于特定地缘政治和宏观经济时期
- v2 选择偏差:新增样本为非随机采样,过度代表边界案例
参考文献与代码
- 标注管道开源代码:https://github.com/RemeDegen/finance-news-sentiment
- 标签可靠性审计研究:https://github.com/RemeDegen/nlp-judge-audit
- 微调模型:https://huggingface.co/remehostingservices/finbert-finance-news-sentiment