
juancavallotti/multilingual-gec
收藏官方服务:
资源简介:
该数据集可用于训练Transformer模型(如T5)来纠正英语、西班牙语、法语和德语的简单句子中的语法错误。数据集通过代码生成,并基于互联网上常见的语法错误信息。数据集包含每种语言的句子实例,并提供了语言、原始句子、修改后的句子、主要和次要转换等数据字段。
This dataset can be used to train Transformer models (e.g., T5) to correct grammatical errors in simple sentences of English, Spanish, French and German. It is generated via code and based on commonly encountered grammatical error data from the Internet. The dataset includes sentence instances for each language, with data fields such as language, original sentence, modified sentence, primary and secondary transformations, etc.
提供机构:
juancavallotti原始信息汇总
数据集概述
- 名称: Multi Lingual Grammar Error Correction Dataset
- 作者: Juan Alberto López Cavallotti
- 发布日期: 2023年1月6日
- 许可: Apache-2.0
- 标签: 语法, GEC, 多语言, 语言检测
- 大小: 100K<n<1M
数据集详情
- 任务类别:
- 翻译
- 语法错误修正
- 语言检测
- 支持语言:
- 英语
- 西班牙语
- 法语
- 德语
数据集结构
- 数据实例:
- 德语: 32282句
- 英语: 51393句
- 西班牙语: 67672句
- 法语: 67157句
- 数据字段:
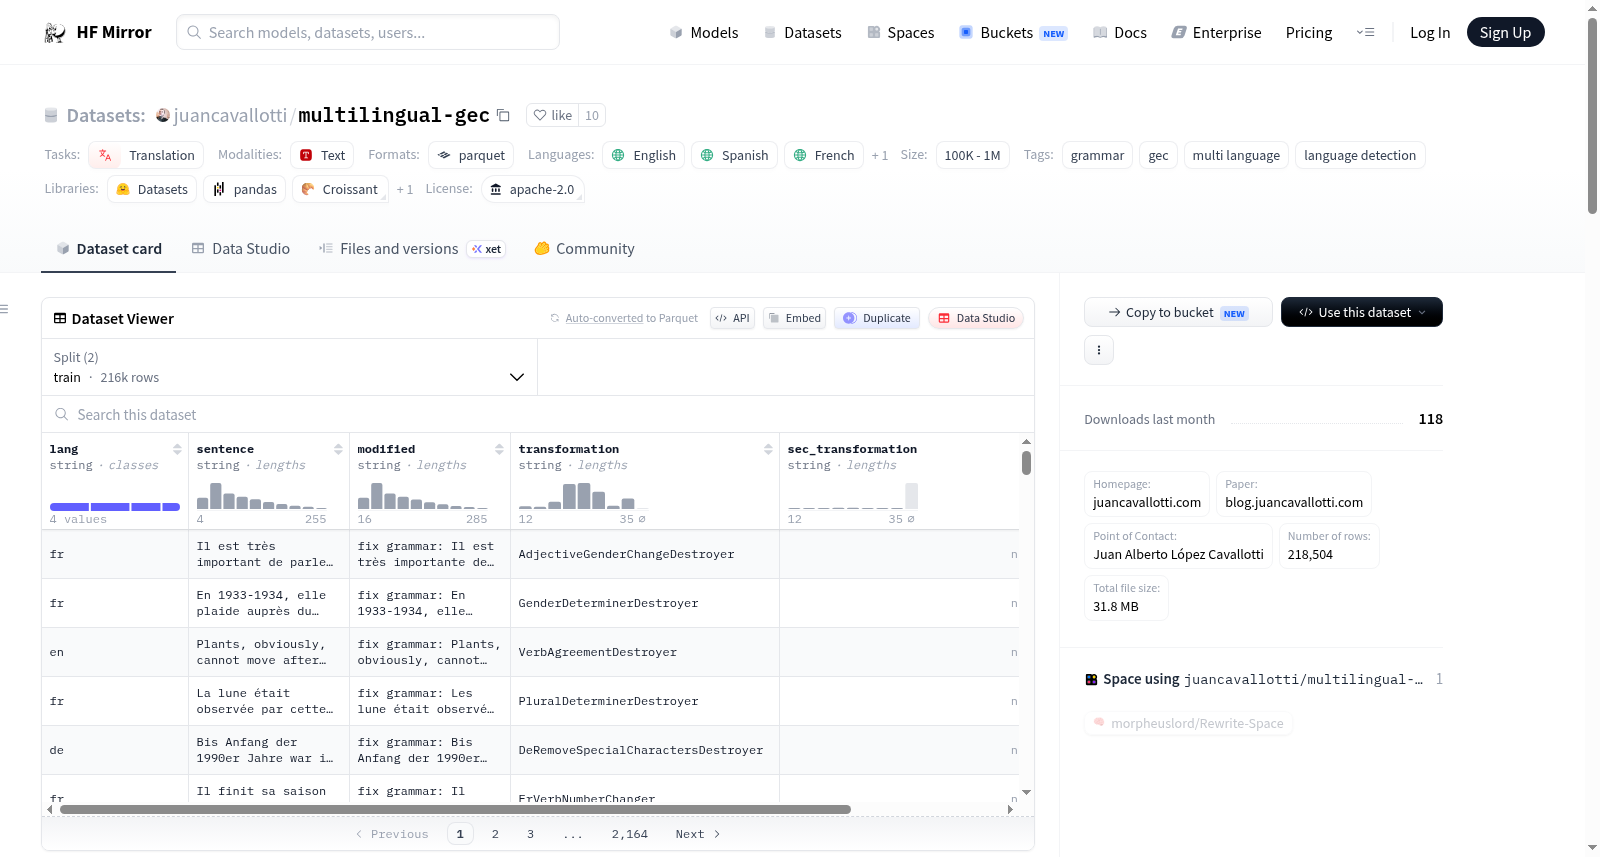
lang: 句子语言sentence: 原始句子modified: 错误句子transformation: 主要转换sec_transformation: 次要转换(如有)
数据集创建
- 来源数据:
- 初始数据收集自多个开源数据集,如Tatoeba。
- 注释过程:
- 自动注释,由生成脚本完成。
其他信息
- 许可证: Apache 2 License
- 引用信息: 引用时请提及原始数据集和作者Juan Alberto López Cavallotti。
搜集汇总
数据集介绍
背景与挑战
背景概述
该数据集是一个多语言语法错误纠正(GEC)数据集,包含英语、西班牙语、法语和德语的句子对,总计约21.8万行数据。它通过合成方法生成,每个实例包括原始句子和包含语法错误的修改句子,旨在训练Transformer模型(如T5)自动纠正语法错误,并支持语言检测任务。
以上内容由遇见数据集搜集并总结生成


