
lightonai/colpali-train-images
收藏官方服务:
资源简介:
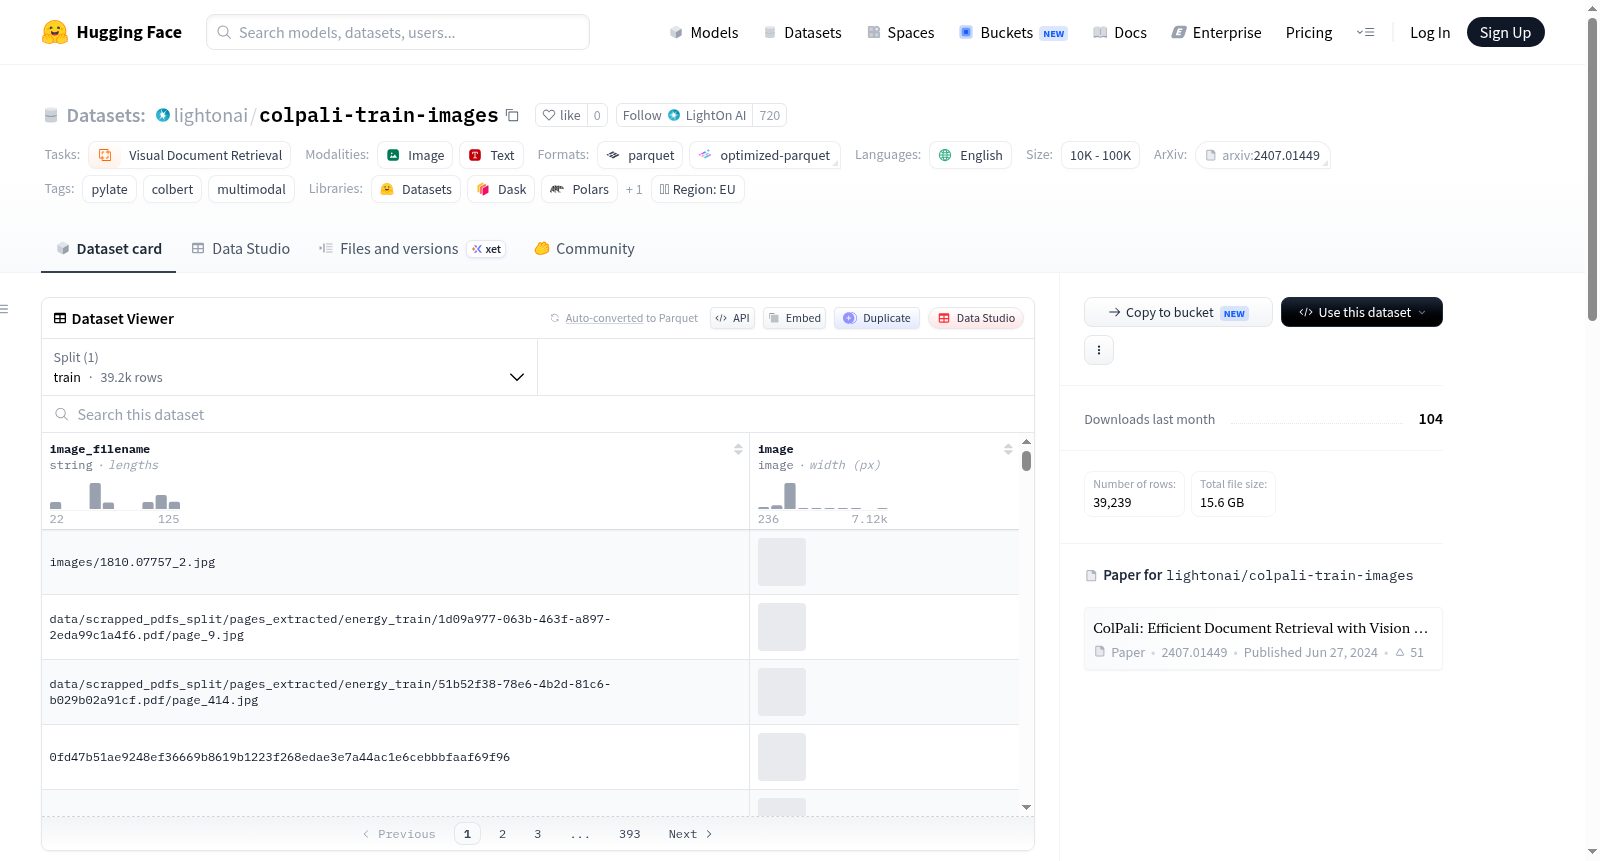
该数据集包含用于[lightonai/colpali-train-fine-tuning]的文档页面图像。该对是[vidore/colpali_train_set]的重新格式化衍生版本,用于多模态检索微调。
This dataset contains the document-page images used by [lightonai/colpali-train-fine-tuning]. The pair is a reformatted derivative of [vidore/colpali_train_set] for multimodal retrieval fine-tuning.
提供机构:
lightonai搜集汇总
数据集介绍
构建方式
在视觉文档检索这一前沿领域,多模态模型的训练离不开大规模、高质量的文档图像数据。ColPali-Train-Images数据集正是为此而生,它是为补充lightonai/colpali-train-fine-tuning微调数据集而专门构建的文档页面图像集合。该数据集是对vidore/colpali_train_set的重新格式化衍生版本,继承了其融合多个学术数据集与合成数据的特性。数据集的构建聚焦于图像与文本描述的严格对齐,通过保留稳定的image_filename作为唯一标识键,确保了与配套微调数据集中文档配置的无缝关联,从而支撑起高效的多模态检索微调任务。
使用方法
使用ColPali-Train-Images数据集极为便捷。研究者可通过Hugging Face的datasets库直接加载,仅需一行代码即可将训练集图像读入内存:调用load_dataset函数并指定数据集名称与split参数为'train'。加载后,关键在于利用image_filename字段与配套的lightonai/colpali-train-fine-tuning数据集中的documents配置进行表连接操作,以image_filename作为共享键,将图像数据与对应的文本和标注信息合并,从而构建出完整的训练样本,用于微调多模态文档检索模型。
背景与挑战
背景概述
在视觉文档检索领域中,多模态模型的发展为文本与图像之间的语义匹配带来了新的契机。ColPali Train Images数据集于2024年由LightOn AI团队创建,旨在配合ColPali模型的微调训练,该模型由Manuel Faysse等人在论文《ColPali: Efficient Document Retrieval with Vision Language Models》中提出,发表于arXiv,致力于通过视觉语言模型提升文档检索的效率与准确性。该数据集源自vidore/colpali_train_set,经过重新格式化,包含近4万张文档页面图像,为多模态检索任务提供了稳定的训练图像资源,推动了视觉文档检索领域的进步。
当前挑战
该数据集所解决的核心领域问题是视觉文档检索中的多模态对齐挑战,即如何有效地将文档图像与文本查询进行语义匹配,以突破传统基于文本检索方法在处理复杂文档布局时的局限。在构建过程中,数据集面临多重挑战:首先,需从多个学术数据集和合成数据源中整合高质量文档图像,确保数据多样性和代表性;其次,图像与微调数据集中文本特征的稳定关联需通过image_filename键精确维护,避免数据碎片化;此外,原始数据的许可问题要求在使用和分发前审慎检查各组成源的授权,增加了数据治理的复杂性。
常用场景
经典使用场景
ColPali Train Images数据集专为多模态检索任务而构建,特别聚焦于视觉文档检索领域。它包含近四万张高质量的文档页面图像,这些图像源自学术数据集与合成数据的精心整合。研究者通常利用该数据集与配套的微调数据集(lightonai/colpali-train-fine-tuning)结合,通过图像文件名建立稳固的关联,从而训练能够理解文档视觉结构并高效检索相关页面的多模态模型。这一经典使用方式为视觉语言模型在文档层面的检索与理解提供了坚实的训练基础。
解决学术问题
该数据集有效解决了传统文档检索中文本表示与视觉信息割裂的学术难题。在以往的检索框架中,模型往往只能处理纯文本查询,难以捕捉文档中的图表、布局与视觉语义。ColPali Train Images通过提供对齐的文档图像,支撑了ColPali模型的发展,使得视觉语言模型能够直接对文档页面进行编码和检索,显著提升了多模态信息检索的准确性与鲁棒性。这一突破推动了信息检索领域向更深层次的视觉-语义融合迈进。
实际应用
在实际应用中,ColPali Train Images训练出的模型可广泛应用于企业文档管理系统、数字图书馆、法律卷宗检索及学术论文搜索等场景。例如,用户可以通过自然语言描述快速找到包含特定图表或版式的合同页面,或从海量扫描件中精准定位所需报告。该数据集所赋能的技术还适用于自动问答系统中的证据定位,以及电子商务平台的产品目录检索,显著提升了复杂视觉文档的搜索效率与用户体验。
数据集最近研究
最新研究方向
多模态文档检索领域正迎来范式革新,其中视觉语言模型与晚期交互机制的深度融合成为前沿焦点。ColPali Train Images作为专为ColPali模型微调设计的视觉文档图像集,其核心价值在于支撑一种新型的多模态检索架构——通过将vision transformer编码器与ColBERT风格的后期交互评分相结合,绕过传统OCR管线直接实现图像级文档检索。该数据集源自学术与合成数据组合的精炼派生,其39,239张训练页面图像紧密对齐配套的微调问答对,为跨模态表征学习提供了关键训练燃料。这一方向不仅回应了PDF、幻灯片等复杂版面文档难以用纯文本建模的行业痛点,更推动了LLM在真实企业知识库检索、智能合规审查等场景中的落地效率,标志着视觉文档理解从单一图像分类迈向端到端语义检索的进化拐点。
以上内容由遇见数据集搜集并总结生成


