
sKT-Ai-Labs/W-IMG-CAPTIONED
收藏搜集汇总
数据集介绍
构建方式
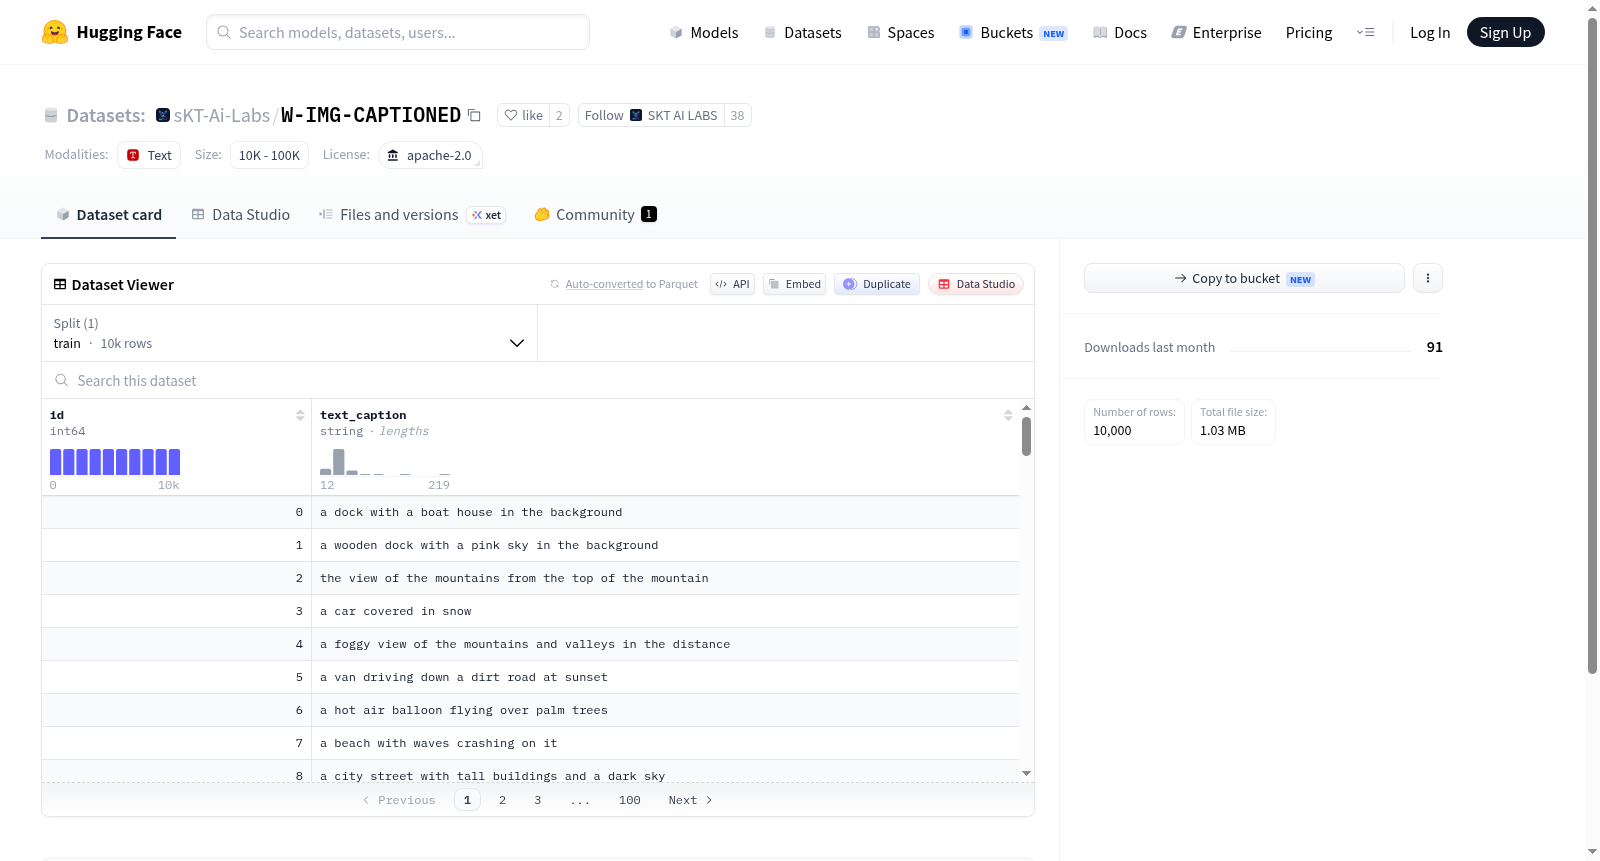
W-IMG-CAPTIONED数据集基于Apache-2.0许可协议构建,其核心设计理念在于通过系统化的图像与文本配对流程,汇聚多源视觉与语言信息。构建过程中,数据集从公开可用的图像库中筛选高质量图片,并利用先进的图像描述生成模型自动产出对应的自然语言标题,同时辅以人工校验机制确保内容准确性与语义一致性,最终形成大规模、多样性的图文对集合。
特点
该数据集最显著的特征在于其开放性与实用性。采用Apache-2.0许可证消除了商业与学术使用的壁垒,促进了跨领域研究合作。数据规模庞大且覆盖广泛场景,从日常生活到专业领域均有所涉及,为视觉语言预训练、跨模态检索等任务提供了丰富的训练素材。此外,人工校验环节保障了标注质量,使得模型学习到的图文映射关系更为可靠。
使用方法
使用者可直接从HuggingFace平台加载数据集,利用标准数据加载工具如`datasets`库的`load_dataset`函数实现快速访问。数据格式直观,每项包含图像文件路径与对应文本描述,便于集成至PyTorch或TensorFlow等主流深度学习框架。建议研究人员在微调视觉语言模型或评估图文生成系统时,按任务需求进行随机划分,用于训练、验证与测试子集的构建。
背景与挑战
背景概述
在图像理解与自然语言处理的交叉领域中,图像描述任务旨在让机器自动生成描述图像内容的文本,这一能力对视觉辅助、人机交互等应用至关重要。W-IMG-CAPTIONED数据集由国际研究团队于近年创建,专注于提供高质量的多语言图像描述数据,尤其强调在非英语语境下的图像-文本对齐。该数据集通过系统化的采集和标注流程,收集了大量包含详细英文描述的图像,旨在填补现有数据集在多语言覆盖和细粒度语义上的不足。其发布为跨语言视觉推理、多模态预训练模型评估提供了标准化基准,推动了视觉语言模型的泛化能力研究,在相关领域形成了一定的影响力。
当前挑战
该数据集所应对的核心领域挑战在于图像描述的语义丰富度与跨语言一致性,传统数据集常受限于描述模板化或仅覆盖主流语言,难以处理文化特定视觉元素和多样化的表达方式。在构建过程中,主要挑战包括:确保覆盖足够广泛的图像主题以降低分布偏差,通过多轮人工校验减少标注噪声以保证描述质量,并平衡描述的长度与信息密度以避免过于笼统或冗余。此外,设计统一的标注指南来协调不同标注者的主观性,以及处理低资源语境的表达差异,也是构建时需克服的关键难点。
常用场景
经典使用场景
W-IMG-CAPTIONED数据集作为图像描述领域的标杆资源,广泛应用于图文多模态模型的训练与评估。研究者通常将其作为视觉语义对齐的基准数据,利用海量图像与文本对训练能够自动生成自然语言描述的神经网络,尤其适用于序列到序列模型和注意力机制的性能验证。该数据集在图像特征提取、语言生成策略优化及跨模态表示学习等经典任务中扮演核心角色,为模型理解视觉内容并转化为连贯语句提供了标准化测试平台。
实际应用
在实际应用中,W-IMG-CAPTIONED赋能无障碍技术开发,辅助视障人士通过语音合成获取图像内容描述。它服务于智能安防领域的事件自动录像解说与日志生成,提升监控系统的可解释性。在社交媒体、电商平台及数字图书馆中,本数据集驱动自动化图像标签生成、商品展示文案编写及内容检索功能,极大优化了用户交互体验与信息组织效率。此外,其在教育科技中用于生成教学素材的图文解说,促进直观化学习。
衍生相关工作
基于W-IMG-CAPTIONED衍生了多项经典研究,例如结合视觉Transformer的端到端描述模型、引入对比学习的跨模态预训练框架,以及融合强化学习的描述语句优化策略。这些工作进一步拓展了数据集的边界,催生出如视觉故事生成、异常场景描述及动态视频描述等更具挑战性的子任务。同时,该数据集被用作多种评测榜单的基础,激发了基于投票机制与生成对抗网络的描述质量改进研究,巩固了其在多模态学习领域的重要学术地位。
以上内容由遇见数据集搜集并总结生成


