a-share-l2-market-depth
收藏资源简介:
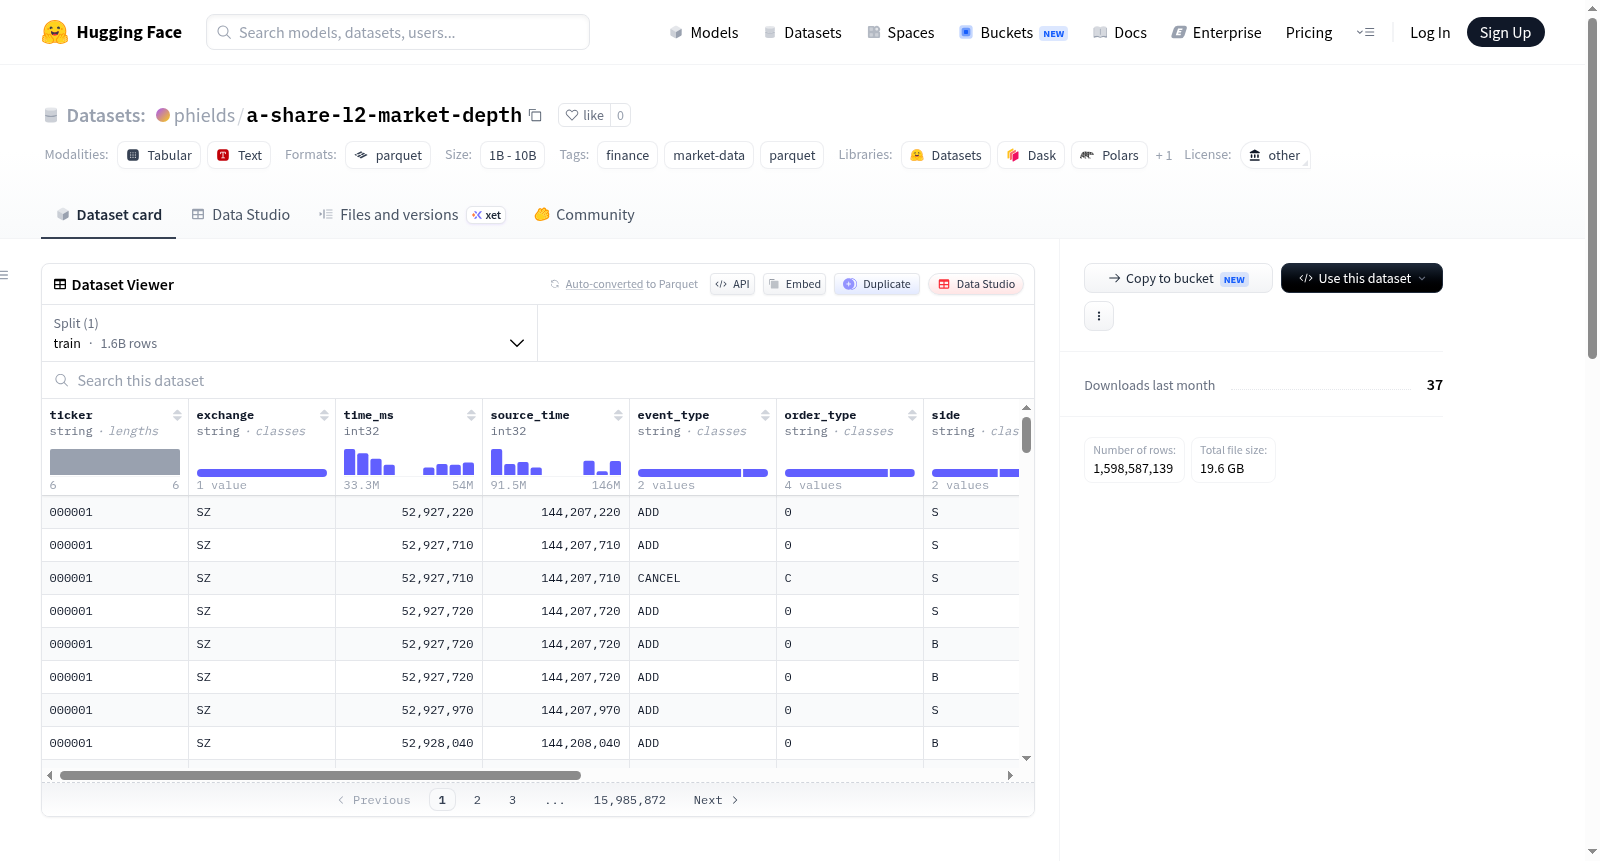
本数据集提供中国A股市场的Level 2行情深度数据,包含规范化的订单事件和十档行情快照。数据集由两个核心表格构成:l2_orders表记录了上海证券交易所的订单添加/删除事件以及深圳证券交易所的订单提交事件,其中深圳市场的取消记录(成交代码=C)被归一化至同一表中,并标注source_table=trades_cancel,且不重复包含在独立的交易数据集中。l2_snapshots表则包含毫秒级时间戳、会话统计信息、总买卖量汇总以及十个档位的买卖价格和委托量。数据覆盖时间为2026年7月24日(仅一个交易日)。数据规模方面,l2_orders表共有249,705,486行,压缩后大小为2.14 GiB;l2_snapshots表共有20,279,887行,压缩后大小为0.91 GiB。数据采用分区存储结构,按交易日(trade_date)和股票代码前缀(code_prefix)组织。数据集的默认股票范围遵循配套交易数据集使用的A股代码前缀:00、30、60和68。需要注意的是,规范化的供应商文件未保留交易所通道序列号、每档订单数量或最佳档位的前50订单队列。该数据集适用于金融市场数据分析、高频交易研究、市场微观结构分析等任务。用户需自行确认其使用符合相关供应商、交易所及再分发条款的规定。
This dataset provides Level 2 market depth data for Chinas A-share market, including normalized order events and ten-level market snapshots. It consists of two core tables: the l2_orders table records order addition/deletion events from the Shanghai Stock Exchange and order submission events from the Shenzhen Stock Exchange, where cancellation records (trade code=C) from the Shenzhen market are normalized into the same table with source_table=trades_cancel, and are not duplicated in the independent trading dataset. The l2_snapshots table contains millisecond timestamps, session statistics, total buy/sell volume summaries, and ten-level bid/ask prices and order quantities. The data covers only one trading day: July 24, 2026. In terms of data size, the l2_orders table has 249,705,486 rows, compressed to 2.14 GiB; the l2_snapshots table has 20,279,887 rows, compressed to 0.91 GiB. The data is partitioned by trading date (trade_date) and stock code prefix (code_prefix). The default stock universe follows the A-share code prefixes used in the accompanying trading dataset: 00, 30, 60, and 68. Note that the normalized vendor files do not retain exchange channel sequence numbers, per-level order counts, or the top 50 order queues at the best bid/ask. This dataset is suitable for financial market data analysis, high-frequency trading research, market microstructure analysis, and other tasks. Users are responsible for ensuring their usage complies with the terms of relevant vendors, exchanges, and redistribution policies.
数据集概述
数据集名称:China A-share Level 2 Market Depth(中国A股二级市场深度)
许可证:其他(自定义许可)
标签:金融、市场数据、Parquet格式
覆盖范围
- 日期范围:2026-07-24 至 2026-07-24(仅1个交易日)
- 交易日数:1天
数据表与规模
| 数据表 | 行数 | Parquet文件数 | 压缩后大小 |
|---|---|---|---|
l2_orders |
249,705,486 | 10 | 2.14 GiB |
l2_snapshots |
20,279,887 | 4 | 0.91 GiB |
数据存储结构
data/l2_orders/trade_date=YYYY-MM-DD/code_prefix=XX/part-00000.parquet data/l2_snapshots/trade_date=YYYY-MM-DD/code_prefix=XX/part-00000.parquet metadata/l2_orders/ metadata/l2_snapshots/
- 数据按交易日期和股票代码前缀分区存储
数据内容说明
l2_orders:包含上海市场(SH)的添加/删除事件,以及深圳市场(SZ)的订单提交记录。深圳市场的撤单记录(成交代码=C)被标准化到同一张表中,标记为source_table=trades_cancel,不重复出现在交易数据集。l2_snapshots:包含毫秒级时间戳、会话统计、买卖总量汇总,以及十档买卖盘价格和数量。
元数据
每个数据表在 metadata/<table>/ 目录下拥有独立的:
- Schema(数据结构定义)
- Manifest(文件清单)
- Daily Manifest(每日文件清单)
- Ticker Calendar(股票日历)
默认股票范围
遵循配套交易数据集所使用的A股股票代码前缀:00、30、60、68。
限制说明
标准化后的供应商文件不保留交易所通道序列号、逐档委托数量及最优档前50队列。用户需自行确认其使用方式符合供应商、交易所及再分发条款。