
stefanocarrera/autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.25_g8_run1
收藏数据链接:
官方服务:
资源简介:
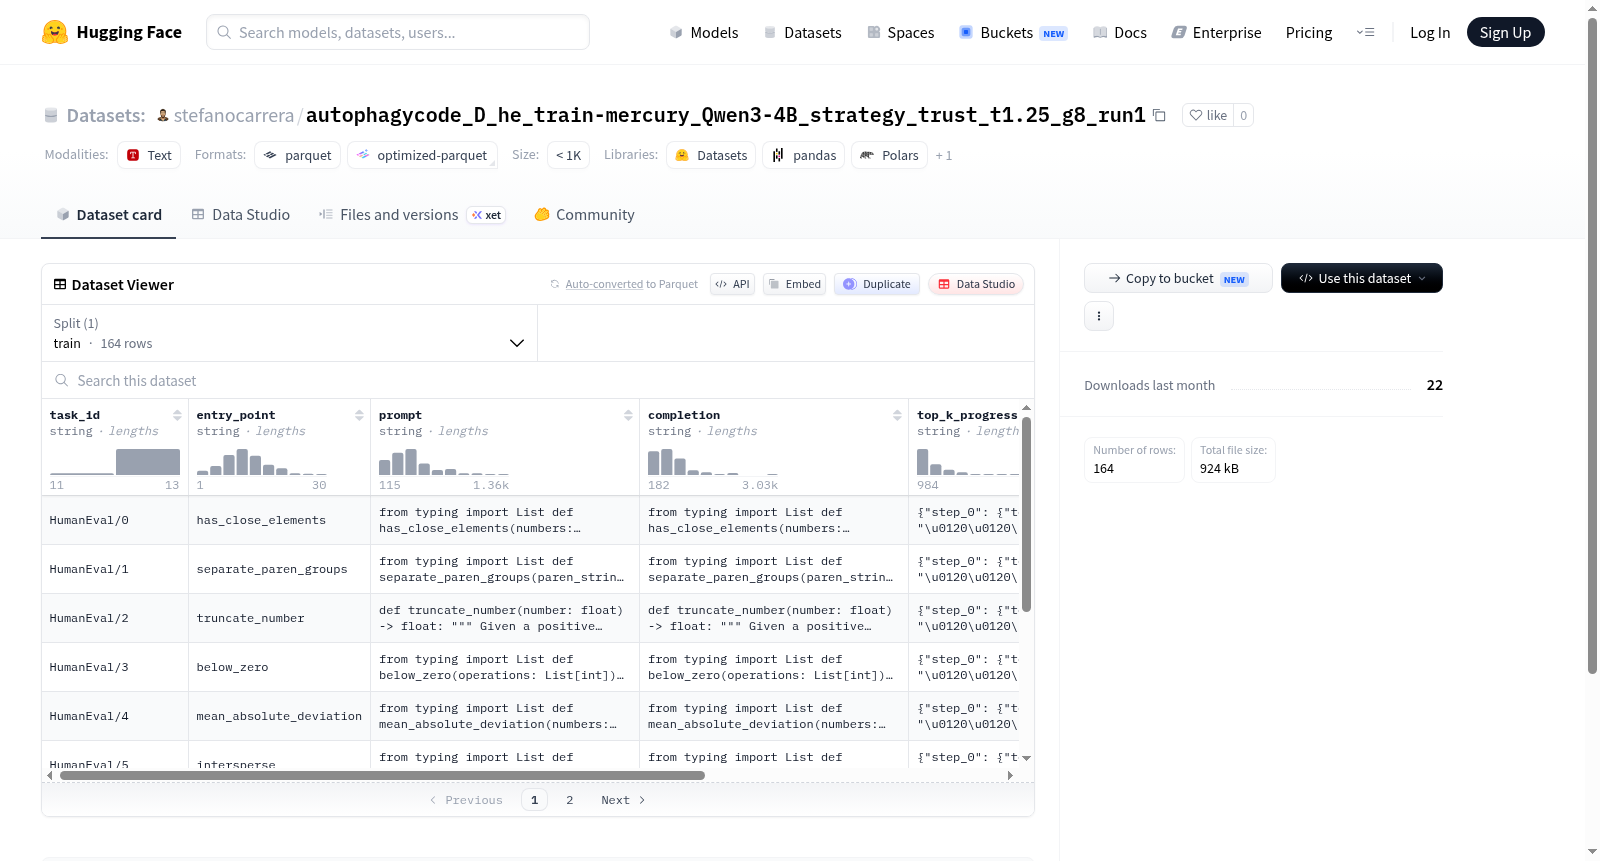
该数据集是一个结构化数据集,包含164个训练示例,总大小约3.58 MB。特征包括任务ID(task_id)、入口点(entry_point)、提示(prompt)、完成(completion)、top_k进展(top_k_progression)和测试(test),主要用于任务相关的自然语言处理或代码生成分析。数据以训练拆分形式提供,下载大小约921 KB。
This dataset is a structured dataset containing 164 training examples with a total size of approximately 3.58 MB. Features include task_id, entry_point, prompt, completion, top_k_progression, and test, primarily used for task-related natural language processing or code generation analysis. The data is provided in a training split format, with a download size of about 921 KB.
提供机构:
stefanocarrera搜集汇总
数据集介绍
构建方式
本数据集名为autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.25_g8_run1,是面向代码生成与推理任务构建的高质量微调数据集。其构建过程基于自回归策略,依托Qwen3-4B模型在温度参数t=1.25及8次采样的配置下,生成候选代码补全序列,并通过信任度过滤机制筛选出高置信度的正向样本。数据集中每个样本包含任务标识、函数入口点、提示文本、补全代码、Top-K进展信息及测试用例等字段,共计164条训练样本,总存储规模约为3.5 MB,体现出小样本高密度的特点。
特点
该数据集的核心特点在于其结构化与多维度信息整合能力。每个样本不仅包含标准的prompt与completion配对,还额外记录了top_k_progression字段,用以刻画模型在推理过程中的渐进式生成路径。此外,test字段提供了可执行的测试脚本,便于对生成的代码进行自动化验证。这种设计使得数据集不仅适用于监督微调,还能支持代码生成的中间状态分析、信任度评估与采样策略优化等研究方向。
使用方法
使用者可通过HuggingFace Datasets库轻松加载该数据集,指定default配置下的train分割即可获取全部164条样本。数据集包含string类型的task_id、entry_point、prompt、completion、top_k_progression和test字段,适用于训练代码生成模型或评估模型在特定函数补全任务上的表现。建议结合test字段中的测试代码进行正确性验证,并可将top_k_progression作为额外信号用于强化学习或重排策略的输入。数据文件以parquet或arrow格式存储,支持高效读取与批处理。
背景与挑战
背景概述
该数据集由研究团队在近期基于Qwen3-4B模型构建,旨在探索自动化代码生成中的信任策略优化问题。其核心研究问题聚焦于如何通过调整生成策略(如信任阈值t1.25与组采样率g8)提升大语言模型在编程任务中的可靠性与结果质量。数据集包含164个训练样本,涵盖任务标识、代码入口点、提示词、补全结果及渐进式top-k反馈等多元特征,为分析模型在代码生成过程中的行为演化提供了结构化资源。作为将自监督学习范式引入代码合成领域的尝试,该数据集推动了在低资源场景下对模型生成策略可解释性与鲁棒性的研究。
当前挑战
当前数据集面临的核心挑战在于:首先,领域层面,代码生成任务存在语义等价性与语法多样性之间的冲突,模型需在有限样本中平衡创新性与正确性;其次,构建过程中,信任阈值的设定缺乏通用理论指导,可能导致生成结果在激进探索与保守复制间失衡;此外,仅含164例的小规模样本易引发过拟合风险,难以验证策略的跨任务泛化能力。这些挑战共同制约了自动化代码补全系统在高可靠性要求场景下的实际部署效能。
常用场景
经典使用场景
该数据集在代码智能与程序合成领域中扮演着关键角色,主要用于训练和评估大语言模型在数学推理与代码生成任务上的表现。具体而言,它聚焦于从自然语言描述到可执行代码的转换过程,尤其针对涉及复杂数学逻辑的问题,模型需要依据给定的`prompt`(问题描述)生成对应的`completion`(代码解决方案),并通过`test`字段中的测试用例进行验证。数据集中的`top_k_progression`字段记录了模型在推理过程中逐步探索的路径,为分析其思考链提供了宝贵素材。这一经典使用场景不仅检验了模型对数学语义的理解能力,还对其代码结构的正确性与效率提出了严苛要求,是推动代码生成技术发展的重要基准。
实际应用
在实际应用中,该数据集驱动的模型可直接赋能智能编程辅助工具,例如自动生成数学公式的求解代码、科学计算脚本或数据预处理流程。基于其训练得到的系统能够为不具备深厚编程背景的科研人员提供从自然语言问题到可运行代码的即时转换服务,显著降低跨学科编程的门槛。此外,该数据集在自动化软件测试领域亦展现出巨大潜力,通过生成针对特定逻辑的测试用例代码,加速软件质量保障流程。在在线教育平台中,它可用于构建个性化编程辅导系统,实时分析学生的解题思路并给出针对性的代码优化建议,从而提升学习效率与编程素养。
衍生相关工作
基于该数据集,学术界涌现了一系列卓有影响的研究工作。例如,研究者借鉴其`top_k_progression`结构,提出了用于评估模型思维链多样性的新指标,催生了多项关于多路径推理策略的对比分析。此外,该数据集成为检验程序修复与优化算法效果的常用基准,相关成果发表于国际顶级会议如ICLR、NeurIPS。受其启发,多个衍生数据集被构建,专门针对不同编程语言或特定数学领域(如概率论、线性代数)的推理任务进行扩展。同时,该数据集也推动了强化学习与监督学习混合训练策略在代码生成任务中的探索,形成了一套结合探索与利用的自动化编程范式,为后续工作奠定了坚实的基础。
以上内容由遇见数据集搜集并总结生成


