
遇见数据集

electricsheepasia/asia-ilo-how-temp-age-ec2-nb-mean-weekly-hours-actually-worked-per-employed-per

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

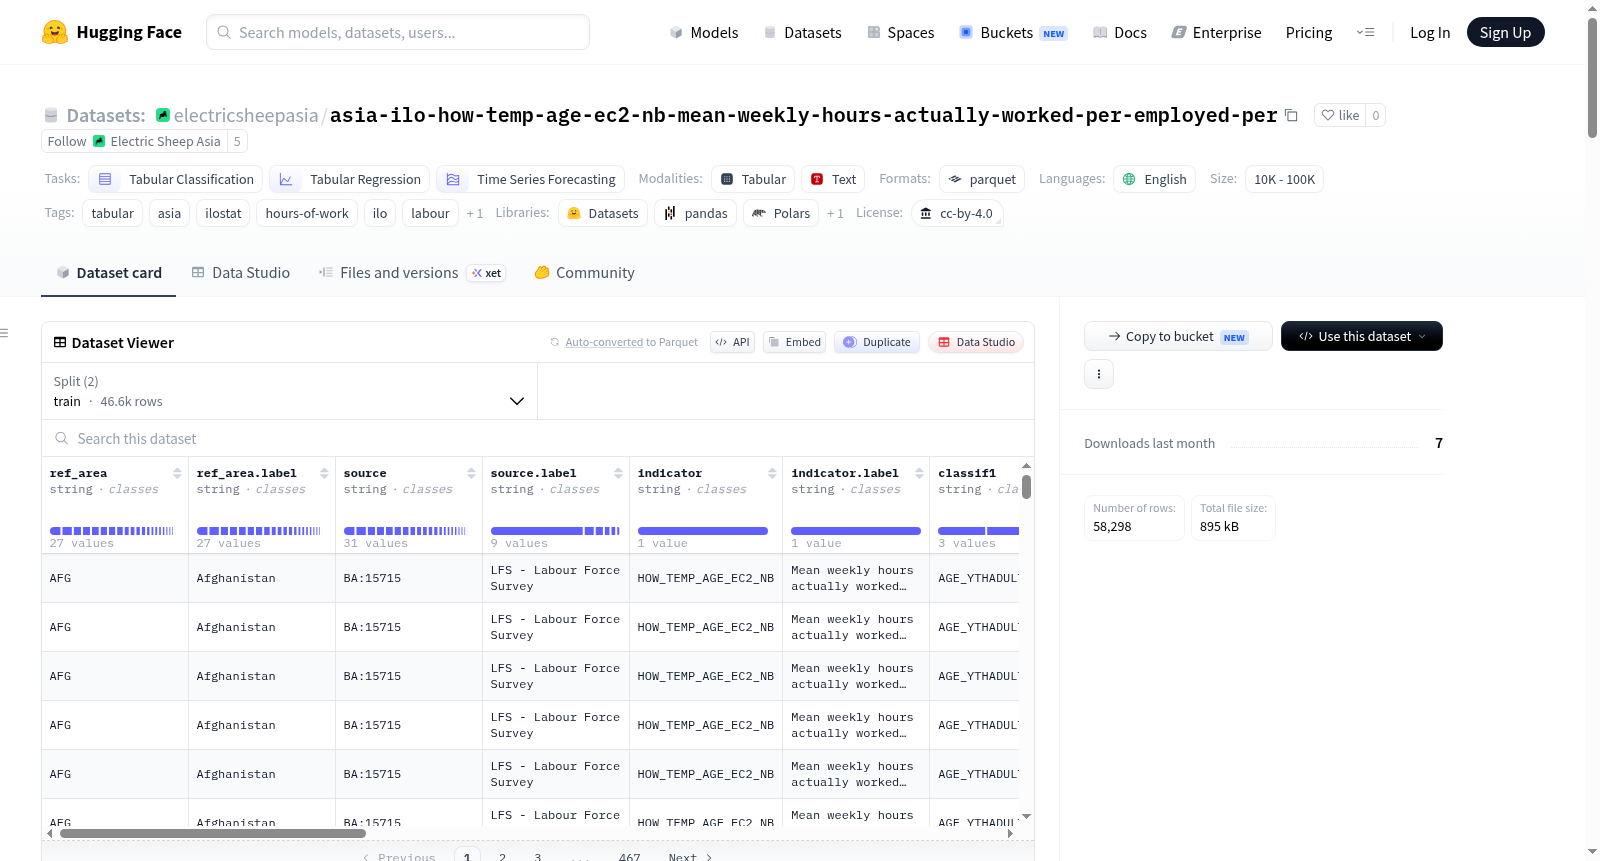
该数据集是一个表格数据集,包含58,298个观测值,覆盖32个亚洲国家从1997年至2025年的数据。核心指标是按年龄和经济活动划分的就业人员实际平均每周工作小时数(ISIC 2级分类),用于衡量劳动市场的工作时间。数据来源于国际劳工组织(ILO)的ILOSTAT数据库,通过API获取并过滤为亚洲国家,涵盖年龄和经济活动的细分维度。数据集适用于表格分类、回归和时间序列预测等机器学习任务,支持按国家、年份和指标进行过滤和分析。

This dataset contains 58,298 observations across 32 Asia countries from 1997 to 2025, focusing on the indicator Mean weekly hours actually worked per employed person by age and economic activity - ISIC level 2. It provides detailed labor market data on actual weekly working hours, disaggregated by age groups and economic activities, sourced from the International Labour Organization (ILO) ILOSTAT database via API and filtered for Asian countries. The dataset is designed for tabular classification, regression, and time-series forecasting tasks, with schema including country codes, time years, indicator values, and classification labels.
提供机构:
electricsheepasia
搜集汇总
数据集介绍
electricsheepasia/asia-ilo-how-temp-age-ec2-nb-mean-weekly-hours-actually-worked-per-employed-per 数据集图片
构建方式
该数据集源自国际劳工组织(ILO)的ILOSTAT中央统计数据库,经由Electric Sheep Asia团队二次封装与整合。原始数据通过ILOSTAT REST API接口直接获取,指标代码为HOW_TEMP_AGE_EC2_NB,并依据亚洲ISO3国家代码进行地理范围筛选。ILOSTAT本身采用国际劳工统计学家会议(ICLS)定义的标准,对各国劳动力调查、住户收入调查及行政记录等原始微观数据进行统一协调与标准化处理,确保了跨国家、跨时间序列的数据可比性。最终形成的观察值总量达58,298条,覆盖32个亚洲国家,时间跨度涵盖1997年至2025年。
特点
该数据集聚焦于亚洲区域按年龄和经济活动(ISIC二级分类)划分的受雇人员周均实际工作时长,是探究亚洲劳动力市场时间配置模式的核心指标。其独特之处在于融合了地理、时间与分类维度:涵盖32个亚洲国家近三十年的年度观测,且每条记录均附有详细的分类标识(如年龄组、经济行业)、数据来源标注及观察状态标志,为研究者提供了透明的数据溯源与质量评估能力。数据现已转换为Parquet格式,兼顾了存储效率与机器学习流水线的读取速度。
使用方法
用户可通过HuggingFace Datasets库轻松加载数据,仅需一行代码即可返回可操作的pandas DataFrame。支持按国家代码(如IND)快速过滤至单一国家的子集,或针对特定指标进行时间序列分析与可视化。更可借助pivot_table函数将数据重塑为国家×年份的矩阵格式,便于跨国的面板数据分析与建模。该数据集适用于监督学习中的时序预测、回归分析以及表格分类等任务,是劳动经济学与亚洲发展研究领域不可多得的标准化数据资源。
背景与挑战
背景概述
亚太地区劳动市场的精准分析依赖于高质量的工作时间数据。该数据集由国际劳工组织(ILO)统计部门创建,并由Electric Sheep Asia于2025年重新打包发布,核心研究问题是揭示亚洲32个国家1997至2025年间,按年龄与经济行业划分的就业人员实际周均工时变化规律。数据源自ILOSTAT数据库,该库通过协调各国劳动力调查数据,为全球劳动统计提供权威基准。作为亚太地区首个大规模、多维度工时数据集,它填补了区域劳动经济学中细粒度时空分析的空白,为政策制定者与研究者评估非标准就业、生产率波动及劳动权益保障提供了关键数据支撑,推动了面向发展中经济体的劳动统计研究。
当前挑战
数据集所解决的领域挑战在于对亚洲劳动市场中工时异质性的系统刻画。区域内各国统计能力差异显著,部分国家调查频率不统一、分类标准存异,导致跨国可比性受损。构建过程中,需从ILOSTAT原始API提取数据,但不同来源的元数据格式(如来源标记、观测状态标志)不兼容,需通过重构分类变量(年龄、经济活动)与筛选最佳来源进行协调。此外,亚洲地区非正式经济占比较高,传统调查难以捕捉真实工时,导致部分观测值不可靠。数据整合时还需应对年度频率与月度/季度序列之间的粒度缺失,以及因指标多重来源导致的冗余记录,这些均对数据清洗与标准化提出严苛要求。
常用场景
经典使用场景
在劳动经济学与政策研究领域,该数据集最经典的用途是作为面板数据源,用于分析亚洲地区不同年龄组与经济活动部门的劳动者每周实际工作时间的长周期演变规律。研究者可借助其中涵盖32个国家、跨越近三十年(1997—2025年)的观测值,构建固定效应或随机效应模型,分解年龄、行业与时间效应对工时水平的异质性影响。其精细的ICLS国际定义对齐与来源可追溯性,使得跨国比较研究具备了方法论上的严谨基础。
实际应用
在实际应用中,该数据集被广泛运用于政府劳动统计部门与跨国经济组织的动态监测系统。例如,各国劳工部可据此追踪特定年龄段或重点产业(如制造业、服务业)的工时变动趋势,判断是否存在系统性超时劳动风险,从而为修订劳动标准与工时法规提供实证支撑。国际金融机构与区域发展银行也常利用该数据构建预测模型,评估劳动力供给变化对亚洲供应链稳定性的潜在冲击,支持投资国别风险评估与产业政策制定。
衍生相关工作
围绕该数据集,学术界衍生出多项具有影响力的研究。典型工作包括基于该数据验证“工时收敛假说”的面板协整分析,以及利用分类维度构建的多级分层贝叶斯模型来估计隐性就业比例。另有研究者将其与ILO其他数据库(如失业率与工资水平)进行关联,探讨工时弹性化对劳动生产率的长周期挤出效应。在方法论层面,该数据还催生了处理国际分类差异的元数据对齐框架,被后续多项跨国劳动力市场比较研究采纳为基准方案。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

