ipfs_lebanon_laws
收藏资源简介:
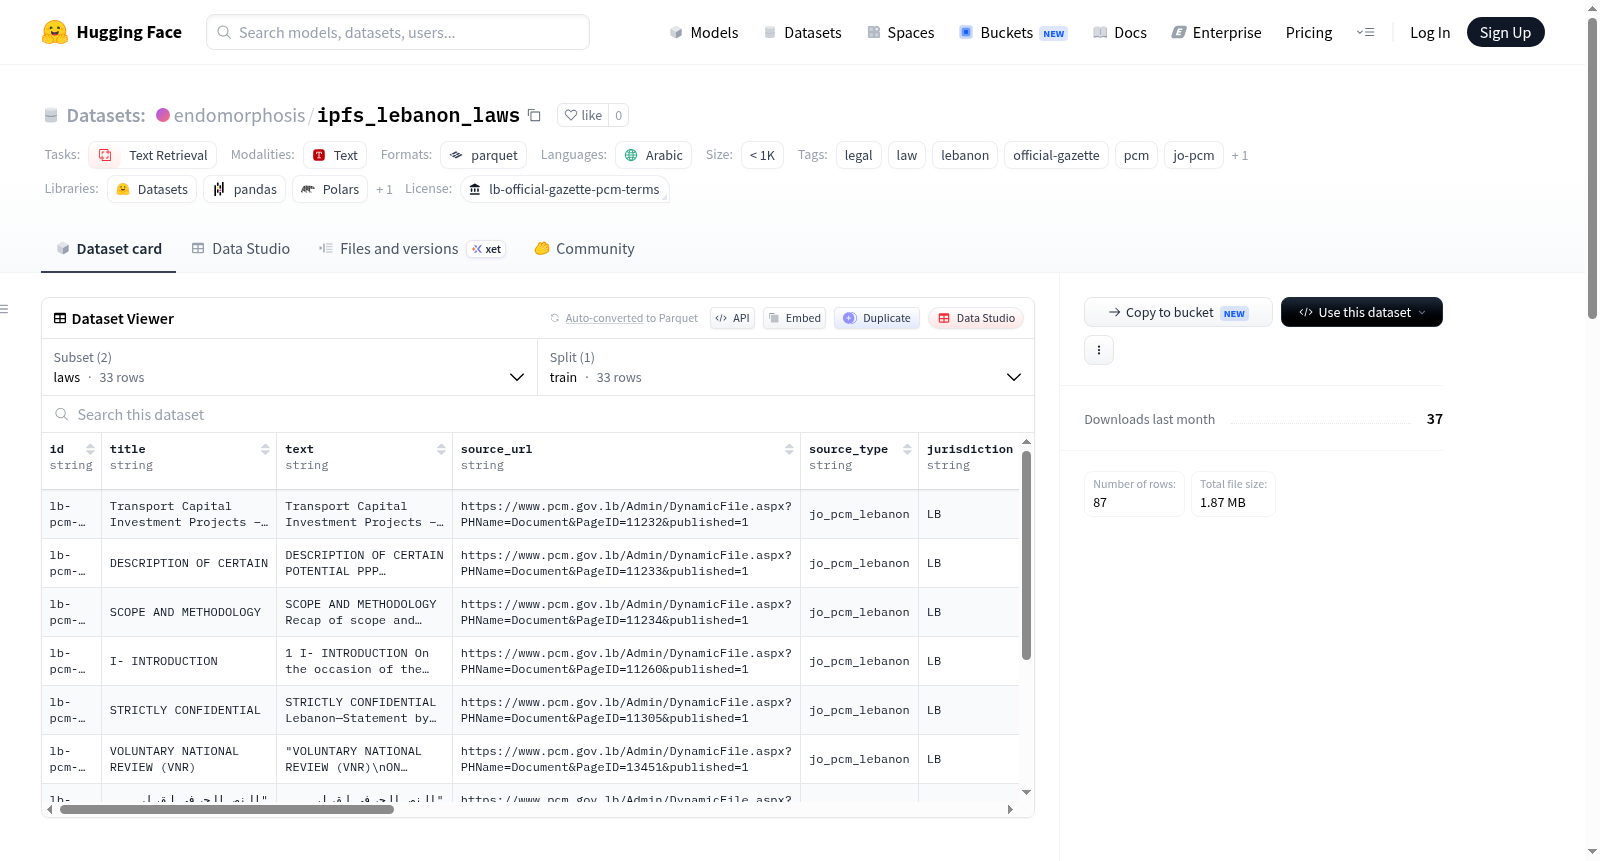
该数据集是黎巴嫩官方公报(jo.pcm.gov.lb)和部长会议主席官网(pcm.gov.lb)上官方国家立法的研究快照。数据集包含两个部分:laws(法律/文书)和articles(文章/条款),分别存储在data/laws.parquet和data/articles.parquet文件中。数据集共有33条法律/文书和54个文章/条款,语言为阿拉伯语,管辖区域为黎巴嫩。数据收集日期为2026年9月9日(来源文本如此),覆盖范围不完整(catalog-backed incomplete),且仅涵盖指定网站,不包含其他法律数据库(如Adala/Qistas)。请注意:本数据集不构成法律建议,官方来源(官方公报)具有优先效力。适用任务为文本检索,特别适用于法律文本的检索与分析。许可证为lb-official-gazette-pcm-terms。已知局限性包括:仅限特定网站,且阿拉伯语OCR质量可能不佳。
This dataset is a research snapshot of official national legislation from the Lebanese Official Gazette (jo.pcm.gov.lb) and the website of the Presidency of the Council of Ministers (pcm.gov.lb). It contains two parts: laws (instruments) and articles (clauses), stored in data/laws.parquet and data/articles.parquet respectively. The dataset includes 33 laws/instruments and 54 articles/clauses, in Arabic language, with jurisdiction over Lebanon. The data collection date is September 9, 2026 (as per source text), coverage is incomplete (catalog-backed incomplete), and only covers specified websites, excluding other legal databases (e.g., Adala/Qistas). Note: This dataset does not constitute legal advice; official sources (Official Gazette) take precedence. Applicable task is text retrieval, particularly suitable for legal text retrieval and analysis. License: lb-official-gazette-pcm-terms. Known limitations include: restricted to specific websites and potentially poor Arabic OCR quality.
数据集概述
名称与基本信息
- 数据集名称:Lebanon Official Gazette / PCM (jo.pcm.gov.lb)
- 语言:阿拉伯语(ar)
- 领域:法律、黎巴嫩、官方公报、部长会议主席府
- 许可:
lb-official-gazette-pcm-terms(非标准许可,标注为“other”) - 数据规模:少于1K条记录
- 司法管辖区:黎巴嫩
数据来源与时间
- 来源机构:黎巴嫩官方公报(jo.pcm.gov.lb)与部长会议主席府(pcm.gov.lb)
- 快照日期:2026-09-09
- 覆盖范围:基于目录备份,不完整
- 采集方式:通过自定义脚本
scrapers/collect_lb.py抓取
数据内容与配置
数据集包含两个配置(config):
| 配置名 | 文件路径 | 说明 |
|---|---|---|
laws |
data/laws.parquet |
每条记录对应一份法律/文书(共33条) |
articles |
data/articles.parquet |
每条记录对应一个条款/章节(共54条) |
任务与标签
- 任务类别:文本检索(text-retrieval)
- 标签:法律、黎巴嫩、官方公报、PCM、官方文本等
已知局限
- 数据仅覆盖jo.pcm.gov.lb / pcm.gov.lb官方网站,不包含Adala/Qistas等第三方法律数据库。
- 当官方实时页面失效时,使用Wayback Machine备份,但官方公报(egazette)的完整期刊内容常受登录墙限制,导致数据不全。
- 阿拉伯语OCR文本质量可能较薄弱。
使用与免责声明
- 非法律建议:数据集仅为研究快照,不构成法律意见。
- 版权与复用:使用须遵守黎巴嫩官方公报/PCM的相关条款;官方正式公报文本优先于本数据集内容。
相关链接
- 原始数据来源:https://jo.pcm.gov.lb/