shopify-products-catalog-sample
收藏资源简介:
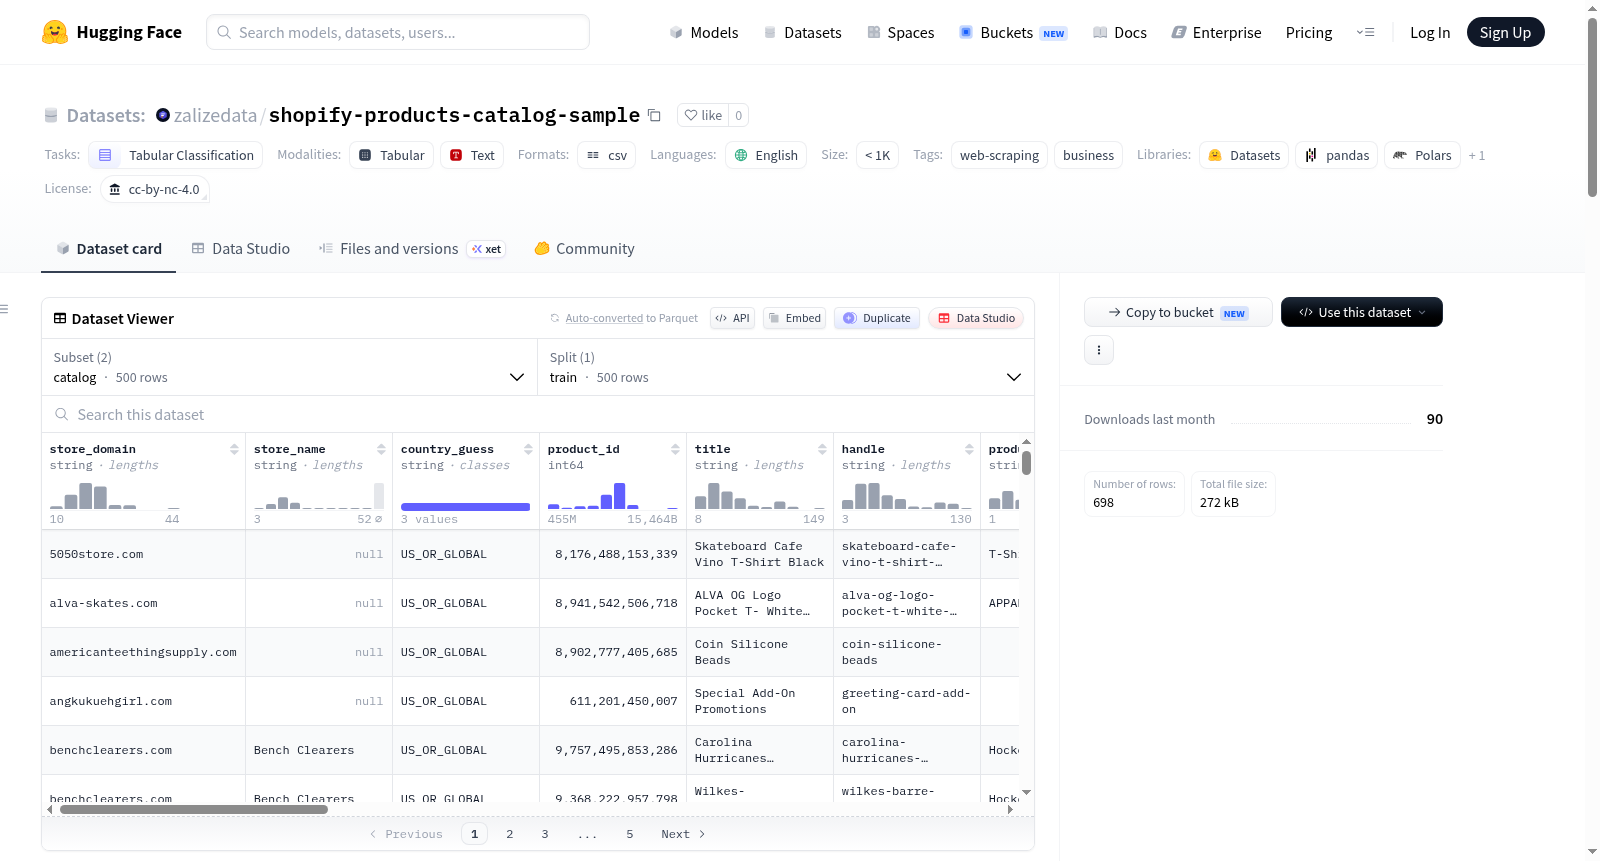
本数据集为 Shopify 独立站(DTC 商店)产品目录与价格历史的免费样本,通过抓取公开、无需登录的 Shopify 商店 `products.json` 端点构建。样本覆盖 386 家商店、533,479 个 SKU 行(2026-08-01 快照),完整数据集含 4,100+ 商店、6.18M SKU,并每周更新快照,同时生成价格变化和可用性变化事件。数据集包含两个配置:`catalog`(每行代表一个产品变体在每个快照的信息,主键为 `store_domain, variant_id, fetched_at`,共 21 个字段,如 `store_domain`, `country_guess`, `product_id`, `title`, `product_type`, `vendor`, `tags`, `variant_id`, `sku`, `price`, `compare_at_price`, `available`, `image_count`, `published_at`, `fetched_at`, `niche` 等)和 `price_changes`(派生事件:新上架、价格涨跌、可用性翻转,含新旧值和日期)。适用于电商与 DTC 市场研究、价格监控与动态定价模型训练、产品目录丰富与匹配基准、从可用性和价格变化事件中提取需求信号。数据收集遵循合规原则:仅使用公开、未认证的 Shopify 端点,限制速率,不包含产品描述 HTML 或图片文件(仅 `image_count`),无个人数据,每行均标注来源。已知限制包括 `country_guess` 为推断值、商店偏向中小型独立 DTC 商店、价格历史深度取决于快照频率。本样本采用 CC BY-NC 4.0 许可证(非商业评估),完整数据集需商业许可。
This dataset is a free sample of product catalog and price history from Shopify independent stores (DTC stores), built by scraping the public, unauthenticated `products.json` endpoint of Shopify stores. The sample covers 386 stores and 533,479 SKU rows (snapshot dated 2026-08-01), while the full dataset contains 4,100+ stores and 6.18M SKUs, with weekly snapshot updates and generated price change and availability change events. The dataset includes two configurations: `catalog` (each row represents information of a product variant in each snapshot, primary key is `store_domain, variant_id, fetched_at`, with 21 fields such as `store_domain`, `country_guess`, `product_id`, `title`, `product_type`, `vendor`, `tags`, `variant_id`, `sku`, `price`, `compare_at_price`, `available`, `image_count`, `published_at`, `fetched_at`, `niche`, etc.) and `price_changes` (derived events: new listings, price increases/decreases, availability flips, with old and new values and dates). It is suitable for e-commerce and DTC market research, price monitoring and dynamic pricing model training, product catalog enrichment and matching benchmarks, and extracting demand signals from availability and price change events. Data collection follows compliance principles: only public, unauthenticated Shopify endpoints are used, rate limited, no product description HTML or image files (only `image_count`), no personal data, and each row is source-annotated. Known limitations include `country_guess` being an inferred value, store bias towards small and medium-sized independent DTC stores, and price history depth depending on snapshot frequency. This sample is licensed under CC BY-NC 4.0 (non-commercial evaluation), and the full dataset requires a commercial license.
数据集概述
shopify-products-catalog-sample 是一个由 DataForge(Zalize)发布的免费样本数据集,内容为独立 DTC(直接面向消费者)Shopify 商店的产品目录及价格历史数据。数据来源于公开、无需登录的 products.json 端点,覆盖 386 家商店、533,479 个 SKU 行(2026-08-01 快照)。完整数据集可扩展至 4,100+ 商店、6.18M SKU,并以周为单位刷新快照,同时生成价格和可用性变更事件。
配置文件
| 配置名 | 文件 | 说明 |
|---|---|---|
catalog |
catalog_sample_500.csv |
500 个产品变体行(跨商店分层随机样本),21 个字段。 |
price_changes |
price_changes_sample.csv |
快照间派生的价格/可用性变更事件样本。 |
数据模式
- catalog:每个产品变体每个快照一行,主键为
(store_domain, variant_id, fetched_at)。字段包括store_domain、country_guess、product_id、title、product_type、vendor、tags、variant_id、sku、price、compare_at_price、available、image_count、published_at、fetched_at及niche分类(12 种基于关键词的利基类别,如 apparel、food_beverage 等)。 - price_changes:派生的变更事件,包括新列表、价格上涨/下跌、可用性翻转,附有旧/新值和日期。
潜在用途
- DTC 电商市场研究及利基/供应商格局分析。
- 价格监控和动态定价模型训练。
- 产品目录增强或匹配基准测试。
- 利用可用性和价格变更事件生成需求信号。
数据来源与合规性
- 仅使用公开、未认证的 Shopify
products.json/meta.json端点,遵守速率限制,使用可识别用户代理,无不正当规避手段。 - 不重新分发产品描述 HTML 或图片文件(仅提供
image_count),不包含个人数据。 - 每行数据包含
store_domain和fetched_at以提供溯源,并提供数据删除请求通道:https://data.zalize.com/data-removal
已知局限
country_guess基于商店货币/元数据推断,US_OR_GLOBAL标记无国家信号的美元商店(本样本中约 99%)。- 商店集合偏向小型/中型独立 DTC 商店,不包含大型平台。
- 价格历史深度随快照频率增长,本样本反映初始快照状态。
许可与引用
- 样本许可:CC BY-NC 4.0(非商业评估),完整数据集采用分级商业许可,详情见 https://data.zalize.com/datasets/shopify-products-price-history-dataset
- 引用要求:需标注 "DataForge (data.zalize.com)" 并链接至 https://data.zalize.com,完整指南见 https://data.zalize.com/citation
使用示例(Python)
python from datasets import load_dataset
ds = load_dataset("zalizedata/shopify-products-catalog-sample", "catalog", split="train") print(ds[0])
可用配置:catalog 和 price_changes。