
budecosystem/superglue_rte
收藏官方服务:
资源简介:
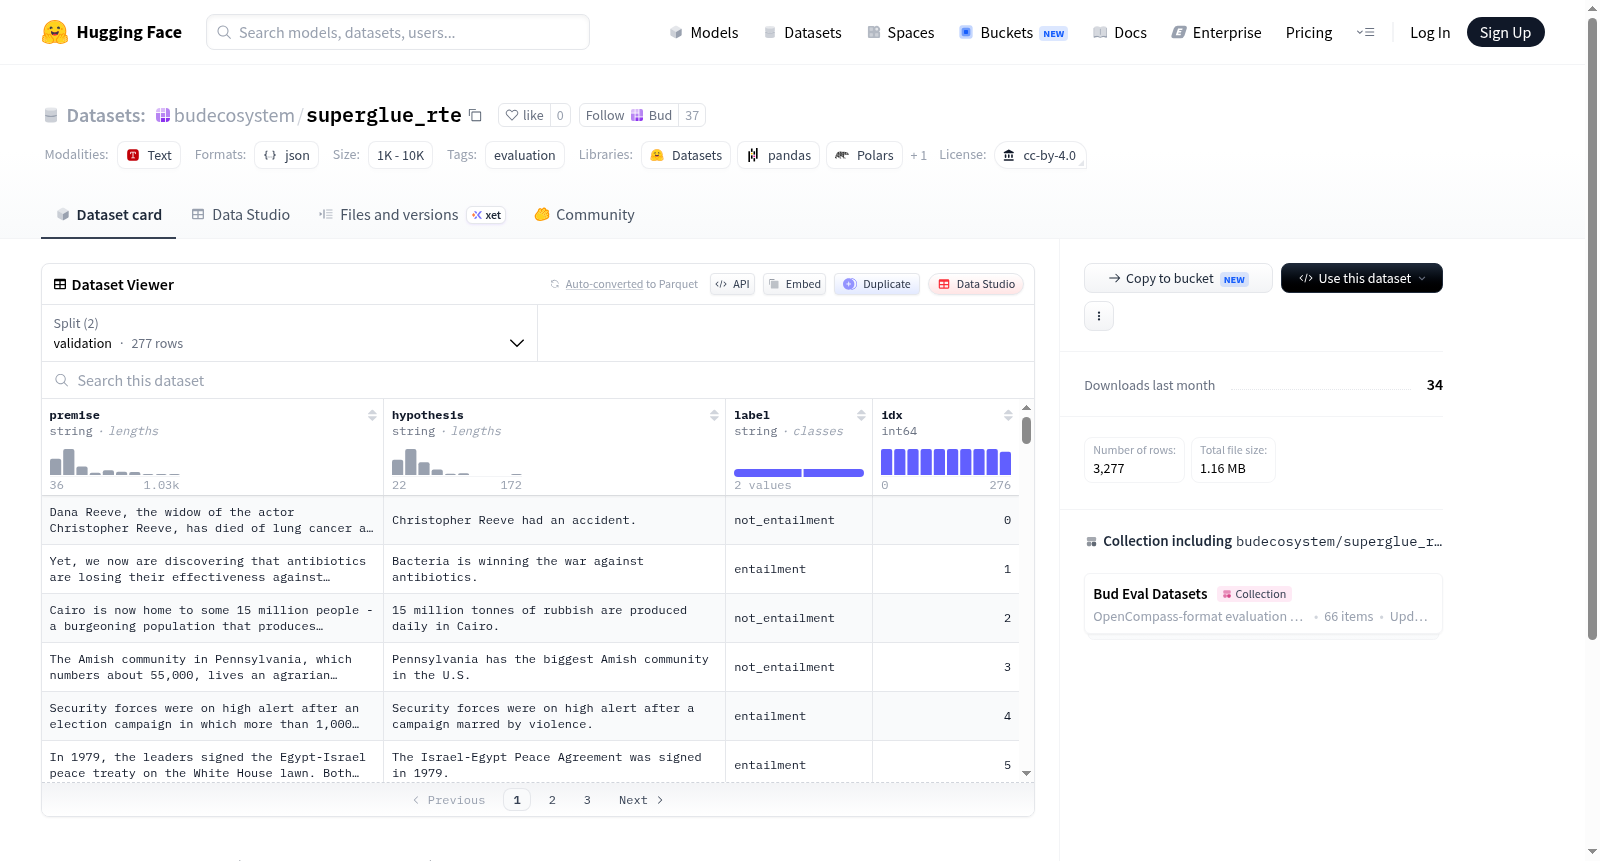
RTE评估数据集(OpenCompass格式)是Bud Ecosystem的评估镜像,专门用于自然语言处理评估任务。该数据集以OpenCompass原生评估数据形式提供,源自OpenCompass数据分发,并严格遵循CC-BY-4.0许可证。数据布局在SuperGLUE/RTE/目录下,完全符合OpenCompass数据集加载器的期望,旨在支持对模型在RTE(Recognizing Textual Entailment,文本蕴含识别)任务上的性能评估。所有权利归原始作者所有。
RTE evaluation data (OpenCompass format) is a Bud Ecosystem eval mirror, providing OpenCompass-native eval data for RTE. It is sourced from the OpenCompass data distribution, licensed under CC-BY-4.0, with all rights remaining with the original authors. The data is laid out at SuperGLUE/RTE/ exactly as expected by the OpenCompass dataset loader, designed for evaluating model performance on the Recognizing Textual Entailment task.
提供机构:
budecosystem搜集汇总
数据集介绍
构建方式
superglue_rte数据集源自SuperGLUE基准任务中的识别文本蕴含(Recognizing Textual Entailment, RTE)任务,旨在评估模型对文本间逻辑关系的理解能力。该数据集采用了OpenCompass兼容的格式进行重构,确保数据读取与评估流程的标准化。原始数据经整理后存放于‘SuperGLUE/RTE/’目录下,严格遵循OpenCompass数据加载器的预期结构,从而形成一套易于集成至评估流水线的评测数据。其构建过程强调对原始标注数据完整性的保留,所有版权归属于原始作者,且遵循CC-BY-4.0许可协议。
特点
该数据集最显著的特点在于其作为OpenCompass原生评测数据的定位,实现了与主流评测框架的高度兼容性。它专门面向RTE任务设计,聚焦于二分类的文本蕴含判断,要求模型识别前提与假设之间的蕴含、矛盾或中立关系。数据格式与OpenCompass的加载规范无缝对接,研究者可直接将其嵌入已有的评估脚本,无需额外格式转换。此外,CC-BY-4.0许可确保了数据的开放共享性,使其成为学术界与工业界进行语言理解模型性能评估的标准工具之一。
使用方法
使用superglue_rte数据集时,研究者可直接将其加载至基于OpenCompass的评估流程中。具体而言,数据集路径应指向‘SuperGLUE/RTE/’目录,OpenCompass的数据加载器将自动识别并解析其中的样本。每个样本包含前提与假设文本对及其对应的蕴含标签,模型需输出预测结果并与标注进行比对,以计算准确率等标准指标。建议结合OpenCompass提供的官方评估脚本进行批量推理,同时可根据任务需求调整批处理大小以优化性能。该数据集无需预处理,可直接用于零样本或少样本评估,亦可作为微调验证集。
背景与挑战
背景概述
自然语言推理(NLI)是自然语言处理领域的核心任务之一,旨在判断两个句子之间的逻辑关系。RTE(Recognizing Textual Entailment)作为文本蕴含识别的经典基准,最初源于PASCAL RTE挑战,后纳入SuperGLUE评测体系,成为评估模型语义理解能力的重要指标。该数据集由SuperGLUE团队于2019年构建,整合了来自新闻、百科等多源文本的蕴含关系标注,聚焦于模型在复杂语义推理中的表现。RTE的发布推动了预训练语言模型在少样本学习和跨任务泛化能力上的研究,其简洁的二元分类任务(蕴含/非蕴含)为评估模型深层语义对齐提供了标准化测试平台,对自然语言理解领域产生了深远影响。
当前挑战
RTE所解决的领域问题在于文本蕴含推理的跨领域泛化能力,模型需从有限标注样本中捕捉多样化的语义推理模式,如因果、因果反转、否定消歧等,这对统计学习算法的鲁棒性提出了严峻挑战。数据集构建过程中,标注一致性难以保证,因蕴含关系常依赖上下文常识与逻辑推理,不同标注者可能对同一对句子的逻辑关系产生分歧,导致标签噪声。此外,SuperGLUE格式的标准化集成要求数据以特定目录结构存储,需确保与OpenCompass等评估框架的无缝对接,从而增加了数据预处理与兼容性验证的复杂性。
常用场景
经典使用场景
RTE(Recognizing Textual Entailment)数据集源自SuperGLUE基准评测,专注于文本蕴含识别任务,即判断两个句子之间是否存在蕴含、矛盾或中立关系。作为自然语言理解中的核心挑战,该数据集常被用于评估模型对语义关系和逻辑推理能力的掌握程度,是检验预训练语言模型在细粒度文本理解上表现的关键试金石。研究者和工程师通常利用RTE来测试模型是否能够捕捉到句子间微妙的语义差异,从而推动更鲁棒的文本理解系统的发展。
衍生相关工作
RTE数据集衍生了一系列标志性研究成果,如基于它发展出的MultiNLI和SNLI等更大规模的蕴含数据集,它们共同构建了自然语言推理的研究基石。经典工作包括将Transformer架构应用于蕴含任务的BERT模型,其通过预训练加微调范式在RTE上取得了突破性进展;后续的RoBERTa、ALBERT等模型进一步优化了推理能力。此外,对抗性样本生成、跨语言蕴含推理以及可解释性推理路径挖掘等方向,也均以RTE为重要参考,持续推动着该领域的前沿探索。
数据集最近研究
最新研究方向
在自然语言推理领域,RTE(Recognizing Textual Entailment)作为SuperGLUE基准的核心子任务,持续驱动着模型语义理解能力的纵深突破。近期研究聚焦于将RTE数据集与OpenCompass等评估框架深度融合,通过标准化的评价数据格式与CC-BY-4.0开放许可,支持大规模语言模型在零样本或微调场景下的蕴含关系判别能力评测。该方向与热点事件如大模型推理鲁棒性挑战、多任务统一评估范式紧密关联,其意义在于为跨模型对比提供公正的测量标尺,同时揭示现有模型在细粒度语义边界上的局限,进而推动面向逻辑一致性与知识融合的下一代推理架构创新。
以上内容由遇见数据集搜集并总结生成


