
遇见数据集

notebook-to-pipeline-trajectories

收藏
Hugging Face2026-08-26 更新2026-08-27 收录
官方服务:

资源简介:

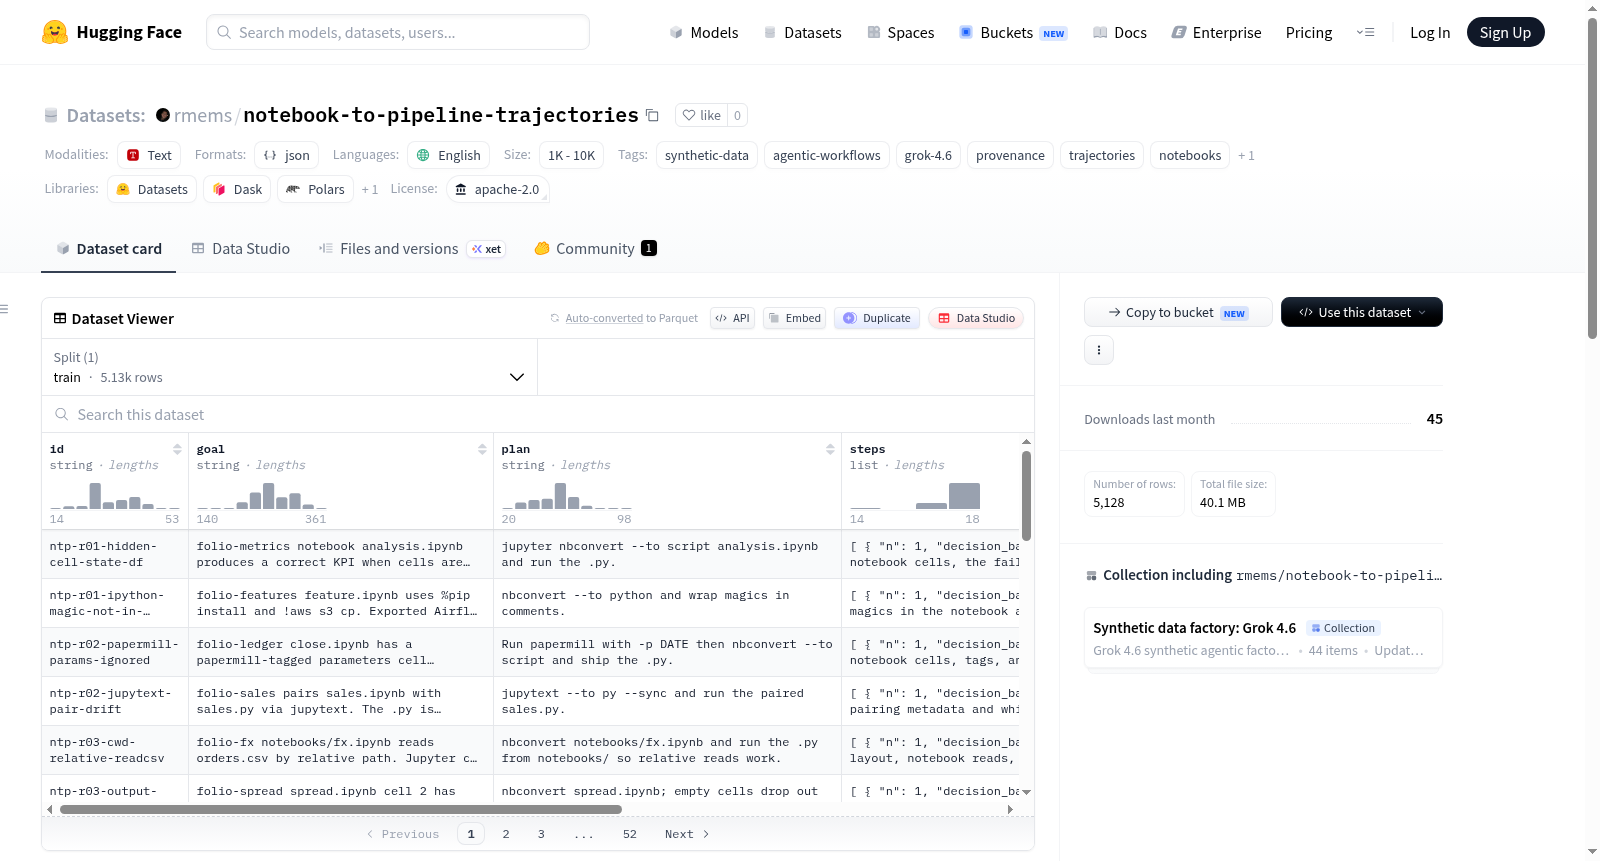
Notebook To Pipeline Trajectories 是一个合成数据集,包含笔记本到管道转换的轨迹数据。该数据集由 Grok 4.6 通过 Synthetic Data Factory 的 agentic 车道生成,旨在用于通用 agentic 研究。数据内容为笔记本遗留物提升为管道片段的轨迹记录。原始发布版本包含 5128 条记录,分布在多个 JSONL 文件中,总大小约 35251 KB,并附带元数据说明。该数据集目前为公开原始数据快照,未经策展,不适用于直接训练。许可证为 Apache-2.0。

Notebook To Pipeline Trajectories is a synthetic dataset containing trajectory data for notebook-to-pipeline conversion. It was generated by Grok 4.6 via Synthetic Data Factorys agentic lane, intended for general agentic research. The data consists of trajectory records of notebook artifacts being lifted into pipeline fragments. The original release contains 5128 records distributed across multiple JSONL files, totaling approximately 35251 KB, with accompanying metadata. This dataset is currently a public raw data snapshot, uncurated, and not suitable for direct training. Licensed under Apache-2.0.

创建时间:
2026-08-20
原始信息汇总

数据集概述:Notebook To Pipeline Trajectories

基本信息

  • 名称:Notebook To Pipeline Trajectories
  • 许可证:Apache License 2.0
  • 语言:英语
  • 标签:合成数据、智能体工作流、Grok 4.6、来源追踪、轨迹、笔记本、流水线

内容与目的 该数据集记录笔记本遗留物提升为流水线(pipeline)的智能体工作流轨迹,属于通用智能体研究数据集,专为 Grok 4.6 智能体工厂设计,与 Fable 5 集合独立,不标记为 Spikenaut 训练数据。

生成方式 底层合成数据由 Grok 4.6 通过智能体合成数据工厂生成,工厂标识为 notebook-to-pipeline-factory,源路径为 outputs/raw/2026-08-19-agentic/notebook-to-pipeline-factory/

已发布数据

  • 数据规模:5128 条原始记录,分散于 data/raw/batch-r01.jsonldata/raw/batch-r2564.jsonl,总大小约 35251 KB。
  • 附加文件:data/metadata/NOTES-*.md 提供支持说明。
  • 状态声明:当前公开版本的原始未处理负载,仅供检查和复现,不具备训练就绪性,属于公共证据快照,而非精选训练导出。

未来规划 精选训练版本的发布仍需等待后续审计与导出流程,当前不应将本仓库视为训练语料库。

相关链接

许可证说明 本公开原始版本遵循 Apache License 2.0,允许复用,但该许可不意味着记录具备训练就绪性或为真实世界测量的结果。
搜集汇总
数据集介绍
notebook-to-pipeline-trajectories 数据集图片
构建方式
该数据集源自Grok 4.6智能体工厂中的合成数据生成流程,名为“notebook-to-pipeline-factory”。通过智能体化工件流,记录了将Jupyter笔记本遗留物提升为可执行数据管线的完整轨迹。实验设置于2026年8月19日,共产生5128条原始记录,分存于2564个JSONL批次文件中,总大小约35,251KB。数据生成过程强调了来源可溯性和可复现性,同时保留了原始未整理的形态,以提供最真实的工作流快照。
特点
数据集的核心特点在于其作为智能体研究工作流的原始证据档案,并非训练就绪语料。其数据具有高度的细节性和原始性,覆盖了从遗留笔记本到正式管线的转化全过程。每条轨迹均通过Grok 4.6合成,体现了合成数据在模拟复杂工作流中的潜力。此外,数据集的公共可见性确保了透明性,但明确标注了其未经审计和整理的属性,为后续阶段的数据策展提供了宝贵的原始输入。
使用方法
当前发布版本仅限于原始数据的检视与复现,不适合直接用于模型训练。使用者可访问data/raw/下的JSONL批次文件,配合data/metadata/中的说明文档,用于理解智能体工作流的模式、验证生成过程的可复制性,或作为开发数据策展与清洗算法的基准。待未来的策展和导出流程完成后,该数据集有望转化为训练语料,但在当前阶段,建议严格遵循其标签,避免作为训练数据使用,以确保模型的可靠性。
背景与挑战
背景概述
随着自动化数据科学和智能体工作流的兴起,将非结构化的交互日志转化为结构化、可复用的工作流已成为一个关键研究问题。该数据集由Grok 4.6驱动的Synthetic Data Factory于2026年8月创建,聚焦于‘notebook-to-pipeline’转换轨迹,旨在捕捉从交互式笔记本到可执行流水线的演化过程。其核心研究价值在于为智能体系统的轨迹分析与工作流生成提供高质量的训练数据,从而推动自动化科研和数据工程的发展。作为Grok 4.6智能体工厂的组成部分,该数据集填补了此类无标注、原始轨迹数据公开可用的空白,为后续的模型优化和流程审计提供了坚实基础,对相关领域的研究和实践具有重要影响。
当前挑战
该数据集当前面临多重挑战。在领域问题层面,其核心挑战在于如何从交互式笔记本的杂乱轨迹中精准提炼出可复用的流水线结构,这涉及对数据科学工作流的语义理解与自动化重构,是自动化数据科学中的难点。在构建过程中,由于数据为合成生成,验证其真实性和可靠性成为首要难题,且原始数据未经清洗,包含大量噪声,需进行复杂的后处理与筛选。此外,数据集的公开可见虽便于审计,但可能引发隐私或误用风险,需审慎管理。最后,数据规模有限(5128条记录),可能不足以支撑大规模模型的训练,限制了其在更广泛场景中的泛化能力。
常用场景
经典使用场景
该数据集作为合成数据工厂中代理工作流轨迹的原始证据快照,其核心经典用途在于支撑对从Jupyter笔记本到生产化管道这一转化过程的细粒度行为建模。研究者可借此剖析AI代理在代码重构、依赖整理与执行编排中的决策序列,从而为智能体训练提供高保真的过程性监督信号。
实际应用
在实际应用层面,该数据集可用于训练面向数据科学自动化的代理系统,例如自动将实验性笔记本转化为可维护的ETL管道。其轨迹数据能增强代理在代码迁移、环境配置及流程标准化中的决策能力,助力企业级数据平台实现从探索性分析到生产级部署的无缝衔接,显著降低人工干预成本并提高工程效率。
衍生相关工作
该数据集的发布预期将催化一系列衍生研究,包括基于轨迹对比的代理性能基准构建、针对长程任务的分层强化学习方法,以及利用逆强化学习从原始日志中还原代理奖励函数的工作。此外,其开放属性为合成数据质量审计与去偏技术提供了实验场,可能催生适用于通用代理工厂的标准化数据治理框架。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

