
GATE-engine/happy-whale-dolphin-classification
收藏官方服务:
资源简介:
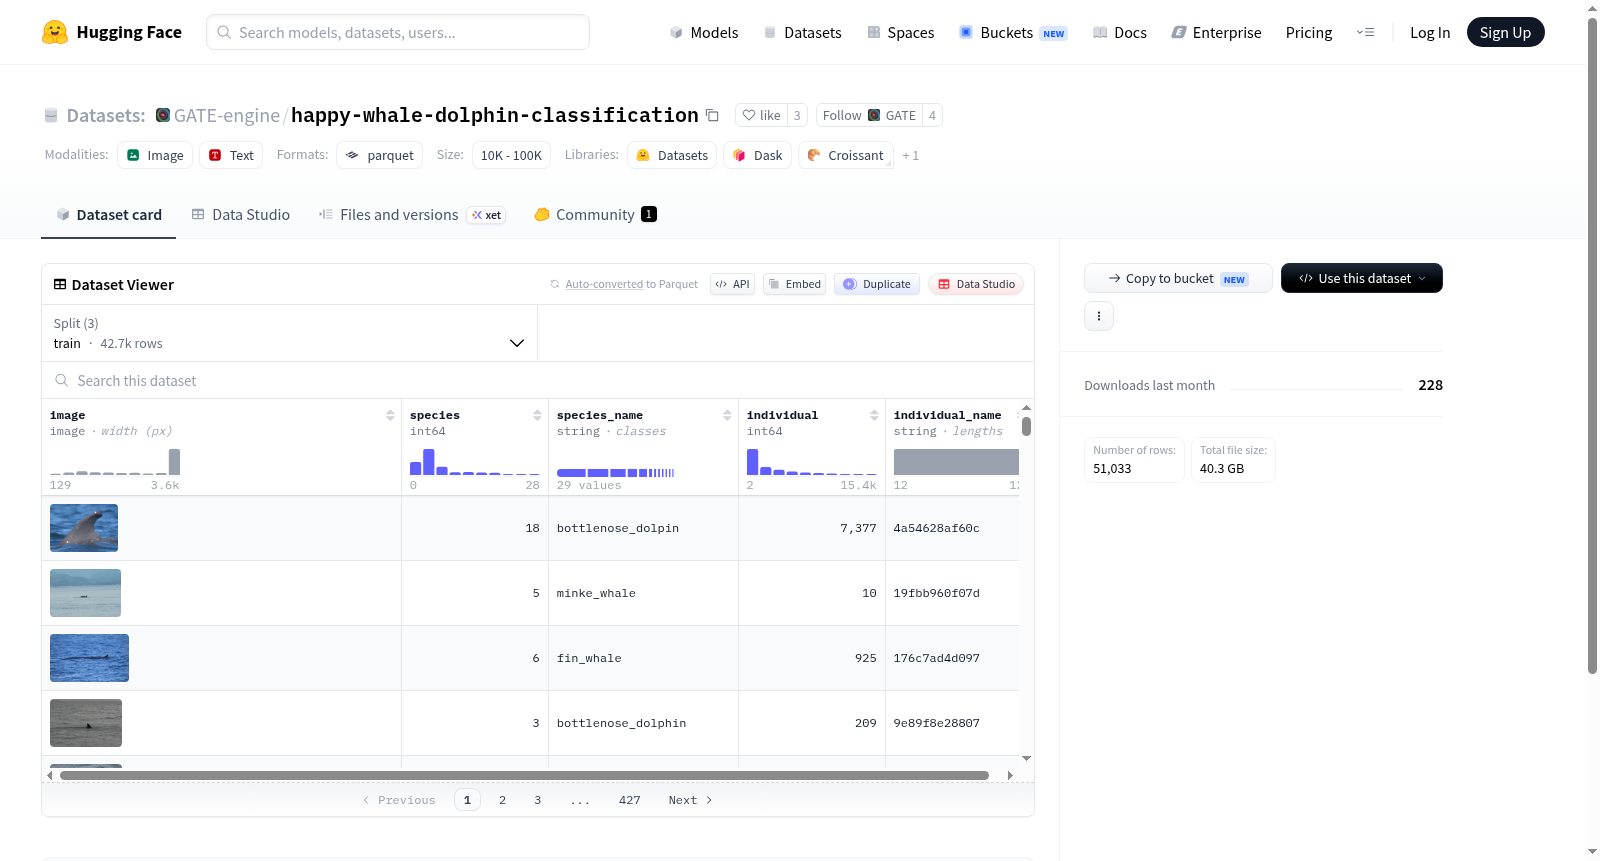
该数据集包含图像、物种、物种名称、个体和个体名称等特征。数据集分为训练集、验证集和测试集,分别包含42678、2088和6267个样本。数据集的下载大小为40331515587字节,总大小为43632213339.878字节。
该数据集包含图像、物种、物种名称、个体和个体名称等特征。数据集分为训练集、验证集和测试集,分别包含42678、2088和6267个样本。数据集的下载大小为40331515587字节,总大小为43632213339.878字节。
提供机构:
GATE-engine原始信息汇总
数据集概述
数据集特征
- image: 图像数据,数据类型为image。
- species: 物种标识,数据类型为int64。
- species_name: 物种名称,数据类型为string。
- individual: 个体标识,数据类型为int64。
- individual_name: 个体名称,数据类型为string。
数据集划分
- train: 训练集,包含42678个样本,数据大小为36526488580.02字节。
- val: 验证集,包含2088个样本,数据大小为1726794221.752字节。
- test: 测试集,包含6267个样本,数据大小为5378930538.106字节。
数据集大小
- 下载大小: 40331515587字节
- 数据集大小: 43632213339.878字节
配置信息
- config_name: default
- data_files:
- train: 路径为
data/train-* - val: 路径为
data/val-* - test: 路径为
data/test-*
- train: 路径为
- data_files:
搜集汇总
数据集介绍
构建方式
在海洋生态保护与人工智能交叉领域,精准识别鲸豚类个体对种群监测至关重要。GATE-engine/happy-whale-dolphin-classification数据集基于大规模野外拍摄的鲸豚影像构建,涵盖训练集42678张、验证集2088张及测试集6267张图像。数据经过严格标注,每张图片关联物种与个体身份信息,其中物种通过整数编码和名称双重标识,个体同样以编号与名称对应,形成层次化的分类体系。数据集以图像格式存储,采用分片方式组织文件,便于高效加载与分布式处理。
使用方法
研究者可通过Hugging Face Datasets库直接加载该数据集,指定split参数选择train、val或test子集。数据以字典形式返回,包含image(PIL图像对象)、species(物种编码)、species_name(物种名称)、individual(个体编码)及individual_name(个体名称)字段。典型应用流程包括:利用torchvision.transforms对图像进行标准化与增强,将物种与个体编码作为分类目标,构建多任务学习框架。测试集无标注,适合用于竞赛提交或模型推理评估,验证集则可用于超参数调优与早停策略。
背景与挑战
背景概述
海洋生物多样性保护与智能监测的交叉领域,正日益依赖计算机视觉技术对鲸豚类动物进行非侵入性识别。在此背景下,由GATE-engine团队构建的Happy Whale and Dolphin Classification数据集应运而生,旨在推动基于个体特征(如背鳍形状、体表疤痕)的细粒度物种与个体分类研究。该数据集于近年发布,整合了超过5万张标注图像,涵盖训练、验证与测试三个子集,分别包含42678、2088和6267个样本。其核心研究问题在于如何从自然环境中拍摄的鲸豚图像中,精准区分不同物种(如座头鲸、宽吻海豚)乃至同一物种内的个体身份,从而为海洋生态学中的种群动态监测、迁徙行为分析提供自动化工具。该数据集的出现,显著提升了计算机视觉在海洋生物识别领域的基准测试能力,并促进了跨学科合作。
当前挑战
当前该数据集面临的核心挑战集中在领域问题与构建过程两个层面。在领域问题方面,细粒度个体识别需克服类间相似性(如不同鲸豚物种的形态趋同)与类内变异性(如同一动物因姿态、光照、年龄变化导致的视觉差异),这对模型的判别能力提出了极高要求;同时,野外图像常存在遮挡、模糊及复杂背景干扰,进一步加剧了分类难度。在构建过程中,数据标注面临主观性难题——不同专家对个体身份的判定可能不一致,且缺乏统一的命名规范;此外,数据分布不均衡(部分物种样本稀少)与长尾效应,使得模型泛化能力受限。这些挑战共同构成了当前该数据集应用与算法优化的主要瓶颈。
常用场景
经典使用场景
该数据集汇集了数万张鲸鱼与海豚的野外影像,覆盖多个物种及个体身份标签,为海洋哺乳动物的视觉识别研究提供了高质量的训练基准。在计算机视觉与生态学交叉领域,研究者常将其用于细粒度图像分类任务的模型开发,通过比对背鳍、斑纹等生物特征,实现对不同物种乃至个体的精准区分。其丰富的类别标签与平衡的数据划分,使之成为验证卷积神经网络与注意力机制在非刚性生物形态识别中鲁棒性的经典测试平台。
解决学术问题
在学术研究中,该数据集主要解决了海洋生物自动监测中的个体识别难题,传统依赖人工标记的方法效率低下且难以规模化。基于该数据集,研究者能够训练深度学习模型从图像中自动提取判别性特征,从而支持对鲸豚类种群的长期追踪与行为分析。这一突破不仅提升了生态调查的时空覆盖范围,还推动了计算机视觉技术在野生动物保护领域的理论创新,为后续多模态融合与少样本学习研究奠定了数据基础。
实际应用
实际应用中,该数据集支撑了非侵入式海洋生态监测系统的构建,通过部署在无人机或水下摄像设备上的识别模型,实时记录鲸豚个体的出现频率与迁徙路径。保护组织可据此评估人类活动对栖息地的影响,制定精准的干预措施。此外,该技术还被延伸至旅游观光场景,帮助游客快速了解所遇鲸豚的物种与身份,增强科普教育的互动性与趣味性。
数据集最近研究
最新研究方向
在海洋生态保护与计算机视觉交叉领域,Happy Whale and Dolphin Classification数据集正成为推动鲸豚类个体识别与群体监测研究的关键资源。当前前沿方向聚焦于利用深度学习模型对海量水下图像进行细粒度物种分类与个体重识别,结合迁移学习与对比学习范式,提升在复杂水下光照、姿态变化及遮挡条件下的鲁棒性。该数据集的应用紧密关联着全球海洋哺乳动物保护热点,如濒危物种的种群动态评估、迁徙路线追踪及人类活动影响量化,为构建非侵入式自动化监测体系奠定基础,其多分类标签与个体身份标注特性显著推动了野生动物视觉识别技术从实验室走向真实生态场景的落地进程。
以上内容由遇见数据集搜集并总结生成


