
traffic-prediction-refined-splits
收藏官方服务:
资源简介:
该数据集名为“交通预测数据集(精炼与处理版)”,旨在用于道路交通流量预测任务。其核心数据来源于4个不同的道路交叉口。数据集经过了精心的预处理和特征工程流水线构建,以确保数据质量并避免数据泄露。具体处理步骤包括:严格按时间顺序划分数据集(70%训练集、15%验证集、15%测试集,且在特征转换前完成划分)、生成丰富的时序特征(如1小时、2小时、3小时、24小时的滞后值,6小时和24小时的移动平均值,以及小时、星期几、月份的周期性正弦/余弦编码),并仅基于训练集数据进行标准化缩放。数据集中包含14个已计算好的特征,例如‘hour_sin’、‘hour_cos’、‘dow_sin’、‘dow_cos’、‘month_sin’、‘month_cos’、‘is_weekend’、‘veh_lag_1’、‘veh_lag_2’、‘veh_lag_3’、‘veh_lag_24’、‘veh_ma_6’、‘veh_ma_24’、‘veh_diff_1’。数据组织形式适用于时间序列模型,特别是图神经网络(GNN),其预期的输入张量格式为(批次大小, 4个路口, 24个时间步, 14个特征)。
创建时间:
2026-06-08
原始信息汇总
数据集概览
- 名称:Traffic Prediction Dataset (Refined & Processed)
- 来源:4个不同路口的道路交通数据
- 处理目标:通过严谨的特征工程流水线,避免数据泄漏
数据处理流程
- 时间划分:严格按时间顺序划分,70%训练集、15%验证集、15%测试集,在特征变换前完成拆分
- 特征工程:
- 滞后特征:1小时、2小时、3小时、24小时
- 移动平均:6小时、24小时
- 正弦/余弦编码:小时、星期几、月份
- 其他特征:是否周末、差分特征
- 缩放:仅基于训练集拟合StandardScaler
可用特征列表
| 特征名称 | 说明 |
|---|---|
hour_sin |
小时的正弦编码 |
hour_cos |
小时的余弦编码 |
dow_sin |
星期几的正弦编码 |
dow_cos |
星期几的余弦编码 |
month_sin |
月份的正弦编码 |
month_cos |
月份的余弦编码 |
is_weekend |
是否周末 |
veh_lag_1 |
1小时滞后车流量 |
veh_lag_2 |
2小时滞后车流量 |
veh_lag_3 |
3小时滞后车流量 |
veh_lag_24 |
24小时滞后车流量 |
veh_ma_6 |
6小时移动平均车流量 |
veh_ma_24 |
24小时移动平均车流量 |
veh_diff_1 |
差分特征 |
图神经网络适用格式
- 输入张量维度:
(Batch, 4, 24, 14)- Batch:批次大小
- 4:路口数量
- 24:时间步长(24小时)
- 14:特征数量
搜集汇总
数据集介绍
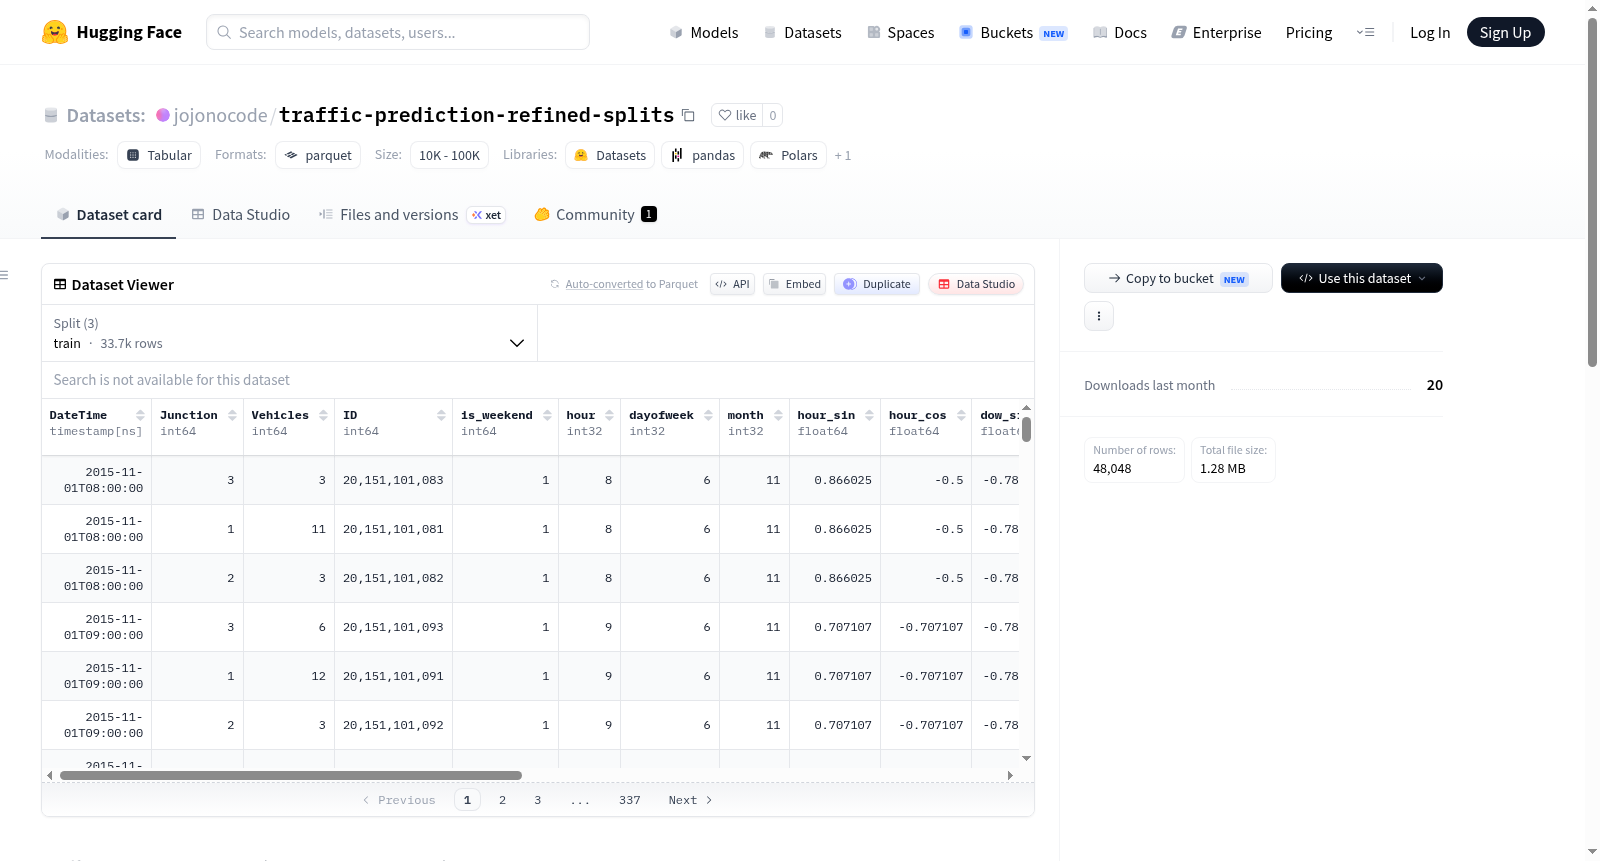
构建方式
本数据集聚焦于城市交通流预测任务,源自4个不同路段的实时交通监测数据。为确保模型评估的公正性与可重复性,构建过程中严格遵循时间序列数据的细粒度划分原则,以70%、15%与15%的比例将原始时序数据依次切分为训练集、验证集与测试集,且所有变换操作均在分割完成后执行。在特征工程环节,系统性地引入了多阶滞后特征(如1小时、2小时、3小时及24小时滞后)、滑动平均特征(6小时与24小时窗口)以及三角函数编码(小时、星期、月份的正余弦分量)。此外,还纳入了周末标识与一阶差分特征。标准化处理则采用StandardScaler,其参数仅从训练集拟合,从而完全规避了数据泄露风险。
使用方法
本数据集专为交通流量预测的图神经网络模型设计。使用时需将其加载为四维张量格式,即(Batch, 4, 24, 14),其中四个维度分别对应批次样本数、4个路段节点、长度为24的历史时间步以及14维特征向量。各节点内部时间步的排列严格按照原始时序顺序,模型可据此捕捉节点间的空间关联与时间演变规律。在具体实践中,可直接调用HuggingFace Datasets库读取数据,随后通过滑动窗口方式构造输入-输出对,以历史24个时间步的特征预测未来交通流量。推荐结合时空图卷积网络或门控循环单元等架构进行训练,并依据验证集调整超参数后,在测试集上评估最终预测性能。
背景与挑战
背景概述
交通流量预测作为智能交通系统的核心任务之一,对于缓解城市拥堵、优化出行规划具有重要价值。traffic-prediction-refined-splits数据集由研究团队精心构建,旨在为图神经网络(GNN)等深度学习方法提供高质量的基准数据。该数据集汇集了来自4个不同路口的实时交通流量记录,并通过严格的特征工程管道进行预处理。其核心研究问题在于如何在确保时序数据完整性的前提下,有效利用历史交通模式(如滞后特征、移动平均、周期性编码)提升预测精度。自发布以来,该数据集凭借其严谨的划分策略(70%训练、15%验证、15%测试)和防数据泄露的设计,为交通预测领域的模型评估提供了可靠的标准化平台,显著推动了相关算法的发展。
当前挑战
该数据集所解决的领域挑战聚焦于交通流量的多步预测问题,尤其需要在时空依赖关系复杂的场景下捕捉交通模式的动态变化。传统方法常因忽略时序顺序或引入未来信息而导致模型泛化能力不足。构建过程中的主要挑战包括:一是严格实施时间顺序划分以防止数据泄露,要求所有特征(如滞后项、移动平均)的生成必须在分割后进行;二是特征工程需兼具物理意义与统计有效性,例如通过正弦/余弦编码处理周期变量,并谨慎设计滞后阶数;三是标准化处理(StandardScaler)仅基于训练集拟合,以避免测试集信息污染。这些设计确保了数据集既能忠实反映真实预测场景,又为模型鲁棒性验证提供了严苛的测试环境。
常用场景
经典使用场景
traffic-prediction-refined-splits数据集专为交通流预测任务而精心构建,尤其适用于时空序列建模领域。该数据集整合了四条不同道路交叉口的交通流量记录,并经过严格的特征工程处理,包括时间特征编码(如小时、星期、月份的正余弦变换)、滞后特征与移动平均特征的提取。其经典使用场景是基于图神经网络(GNN)或长短期记忆网络(LSTM)等深度学习模型,预测未来多个时间步的交通流量,输入格式规整为批次、交叉口、时间步和特征的张量结构,便于研究者直接开展高精度交通流预测实验。
解决学术问题
该数据集旨在解决交通预测中普遍存在的数据泄露与时间依赖性建模两大核心学术难题。通过采用严格的时间顺序划分策略(70%训练、15%验证、15%测试),确保所有特征工程完全基于训练集完成,避免了传统随机划分导致的过估计问题。同时,数据集提供了丰富的时滞与滑动窗口特征,使模型能够有效捕捉交通流的短期波动与长期周期性规律。这一设计为验证时空预测模型的泛化能力与鲁棒性提供了可靠基准,推动了交通流理论中非线性与动态性研究的深入发展。
实际应用
在实际应用层面,该数据集支撑着智能交通系统中多个关键场景的落地。基于其生成的预测模型可实时输出未来数小时各交叉口的拥堵概率与车流量变化趋势,从而为交通管理部门提供动态信号配时优化、匝道控制与路径诱导的决策依据。此外,该数据集还能赋能物流配送调度、网约车供需匹配以及城市应急响应预案的制定,显著提升城市交通网络运行效率与道路资源利用率,降低出行延误与碳排放。
数据集最近研究
最新研究方向
近年来,在智能交通系统领域,基于图神经网络(GNN)的交通预测研究正逐渐聚焦于构建更具鲁棒性与可解释性的时空模型。该数据集通过严格的时间分割与精密的特征工程,如滞后特征、移动平均及周期性编码,有效规避数据泄露,为多路口联合预测提供了高保真训练基准。其设计理念与前沿的热点事件——如城市大脑建设与车路协同技术落地——高度契合,推动了从单点短时预测向多维度、多尺度时空依赖建模的跨越。该数据集的意义在于为可复现的交通流研究树立了新标准,助力模型在真实路网复杂度下的泛化能力验证,进而支撑智能交管与出行规划的智能化升级。
以上内容由遇见数据集搜集并总结生成


