
遇见数据集

StarEmbed/ZTF_40k

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

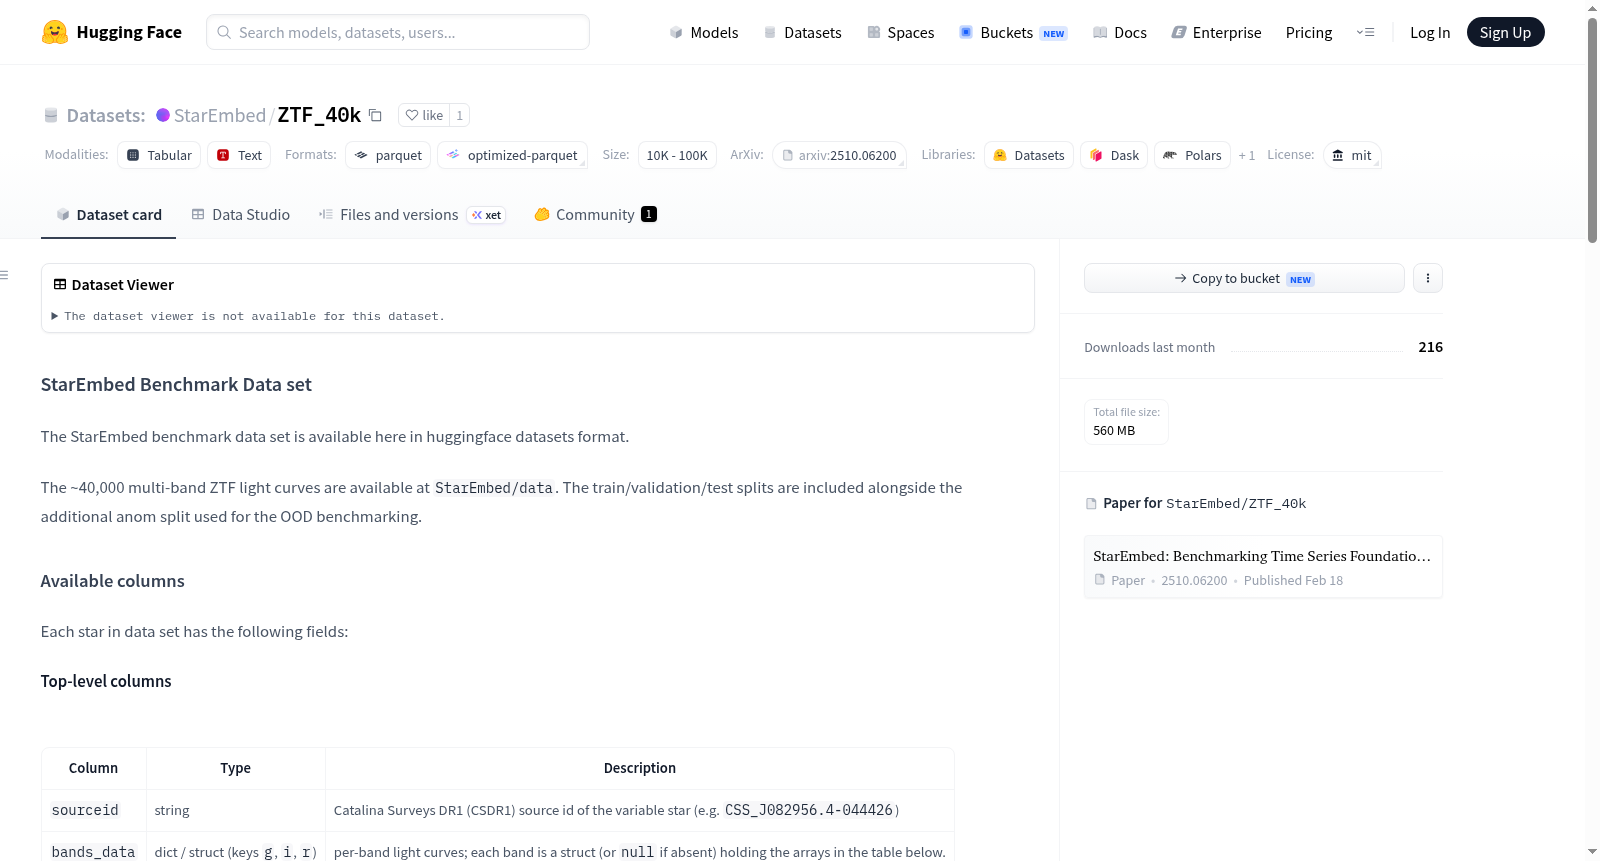
StarEmbed基准数据集是一个天文时间序列数据集,包含约40,000个多波段ZTF(Zwicky Transient Facility)光变曲线,用于变星观测研究。数据集中每个变星记录包括:sourceid(源标识符)、bands_data(包含g、i、r波段的字典结构,每个波段存储光变曲线的目标亮度、误差、时间间隔、观测时间和观测数量)、period(变星周期,以天为单位)、class_str(变星类别标签,如EW、EA、RRab等)、ra(赤经)和dec(赤纬)。数据集分为训练集、验证集、测试集和异常集(anom),其中异常集包含分布外类别,用于异常检测基准测试。数据基于ZTF观测和Catalina Surveys Periodic Variable Star Catalog整理,适用于时间序列基础模型和天文AI研究。

The StarEmbed benchmark dataset is an astronomical time series dataset containing approximately 40,000 multi-band ZTF (Zwicky Transient Facility) light curves for variable star observation research. Each variable star record includes: sourceid (source identifier), bands_data (a dictionary structure with g, i, r bands, each storing the light curves target magnitude, error, time gaps, observation times, and observation count), period (variable star period in days), class_str (variable star class label, such as EW, EA, RRab, etc.), ra (right ascension), and dec (declination). The dataset is split into train, validation, test, and anom sets, with the anom set containing out-of-distribution classes for anomaly detection benchmarking. It is curated from ZTF observations and the Catalina Surveys Periodic Variable Star Catalog, suitable for time series foundation models and astronomical AI research.
提供机构:
StarEmbed
搜集汇总
数据集介绍
StarEmbed/ZTF_40k 数据集图片
构建方式
ZTF_40k数据集源自Zwicky瞬态设施(ZTF)的观测数据,并依托Catalina巡天周期变星星表进行精心筛选与标注。该数据集整合了约四万条多波段光变曲线,覆盖g、r、i三个通道。每条光变曲线均经过标准化处理,包含目标星等(target)、星等误差(past_feat_dynamic_real)、观测时间间隔(feat_dynamic_real)以及儒略日(mjd)等关键特征序列。数据被划分为训练集(29047条)、验证集(4150条)、测试集(8301条)及异常检测集(1087条),其中训练、验证、测试集涵盖七类已知变星,异常集则包含十类分布外变星类别,为分布外检测提供独立基准。
特点
ZTF_40k数据集的一大特色在于其多波段、多类型的时间序列结构,每条记录均保存完整的原始光变曲线,长度随观测次数不同而变化,保留了天文观测的动态完整性。数据集不仅包含传统监督学习所需的天体归类标签(class_str),还提供视向坐标(ra/dec)和精确周期(period)等辅助信息。尤为突出的是,其内建的异常检测分割(anom split)采用与训练集完全不相交的变星类别,为评估时序基础模型的分布外泛化能力提供了严格的基准,使其在恒星分类与异常检测研究中具有独特价值。
使用方法
研究者可通过HuggingFace Datasets库直接加载ZTF_40k数据集,使用默认配置即可自动获取训练、验证、测试及异常四个分割的数据。每个样本以字典形式呈现,包含sourceid、bands_data等字段,其中bands_data是包含g、r、i三个通道的嵌套结构,每个通道下存储长度可变的浮点数列表。该数据集可直接用于多变量时间序列分类或回归任务,尤其是针对变星光变曲线的建模。建议对目标星等序列进行归一化处理,并将时间间隔特征作为协变量输入模型。由于数据格式标准化,可无缝集成至PyTorch或TensorFlow框架中,便于构建循环神经网络或Transformer架构的时序预测和分类模型。
背景与挑战
背景概述
ZTF_40k数据集由Weijian Li、Hong-Yu Chen等研究人员于2025年创建,被ICML 2026主会议录用,旨在为天文学中的变星光变曲线分析提供标准化基准。该数据集源自Zwicky Transient Facility(ZTF)的观测数据与Catalina Surveys周期变星星表,包含约40,000条多波段光变曲线,覆盖七个分布内变星类别(如EA、RRab、LPV等),并提供训练、验证、测试及专用于异常检测的拆分。其核心研究问题在于推动时间序列基础模型在天文时序数据上的评估与泛化能力,对天文信息学与机器学习交叉领域具有重要影响力,为后续变星分类与异常检测研究奠定了数据基础。
当前挑战
该数据集应对的领域挑战包括天文时序数据的多波段非均匀采样与观测噪声,以及变星类别的高度不平衡性,传统分类器难以有效处理此类复杂分布。在构建过程中,研究者需从ZTF海量观测中筛选高质量光变曲线,精确对齐多波段数据并统一时间跨度,同时保证异常检测拆分中类别与新类的严格分离,以避免数据泄露。此外,光变曲线长度差异大、缺失波段处理、周期测量误差等难题,要求构建过程兼顾数据完整性及模型评估的公平性,对数据预处理与基准设计提出了严苛要求。
常用场景
经典使用场景
ZTF_40k数据集汇聚了约四万条来自Zwicky瞬变设施(ZTF)的多波段光变曲线数据,涵盖g、r、i三个波段。该数据集最经典的用途在于为时间序列基础模型在天文学观测数据上的性能评估提供了一个标准化、高质量的基准。研究人员常将其作为训练和验证的基石,用于开发能够从非均匀采样、存在噪声的星体光变曲线中自动提取特征的深度学习模型,进而实现对天琴座RR型星、大陵五型双星等七类经典周期变星的精确分类。
衍生相关工作
ZTF_40k数据集的发布催生了一系列开创性的后续工作。以其为基准,研究者开发了名为‘StarEmbed’的时间序列基础模型,该工作已被ICML 2026主会议及AI4Physics研讨会接收,专门用于学习变星光变曲线的通用嵌入表示。此外,该数据集促进了基于自监督学习的大规模时序预训练范式在天文学中的落地,涌现出多种针对稀疏、不规则采样数据的神经网络架构改进方案。同时,围绕该数据集构建的异常检测基准,也为研究分布外(OOD)样本识别领域提供了宝贵的天文领域真实案例,推动了对时域天文学中未知信号发现方法的系统探索。
数据集最近研究
最新研究方向
ZTF_40k数据集的诞生标志着时序基础模型在天文变星光变曲线分析领域迈入标准化基准测试的新阶段。该数据集汇聚了约四万条来自Zwicky瞬变设施的g、r、i多波段光变曲线,并精心划分了训练、验证、测试及异常检测子集,为评估模型在分布内分类与分布外异常检测任务中的泛化能力提供了坚实的数据基石。结合2025年ICML主会收录的StarEmbed框架,研究前沿正聚焦于利用预训练时序基础模型捕获周期性变星(如EW型双星、RR Lyrae脉动星)的复杂时域特征,并在低质量、不规则采样数据上验证其鲁棒性。异常分割合集中包含的Beta_Lyrae、Blazhko等稀有类型,更是直接挑战模型对天体物理瞬变现象的敏锐感知,这一基准将驱动人工智能在天文大数据时代从特征工程向深度表示学习的范式跃迁。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

