agkphysics/AudioSet
收藏资源简介:
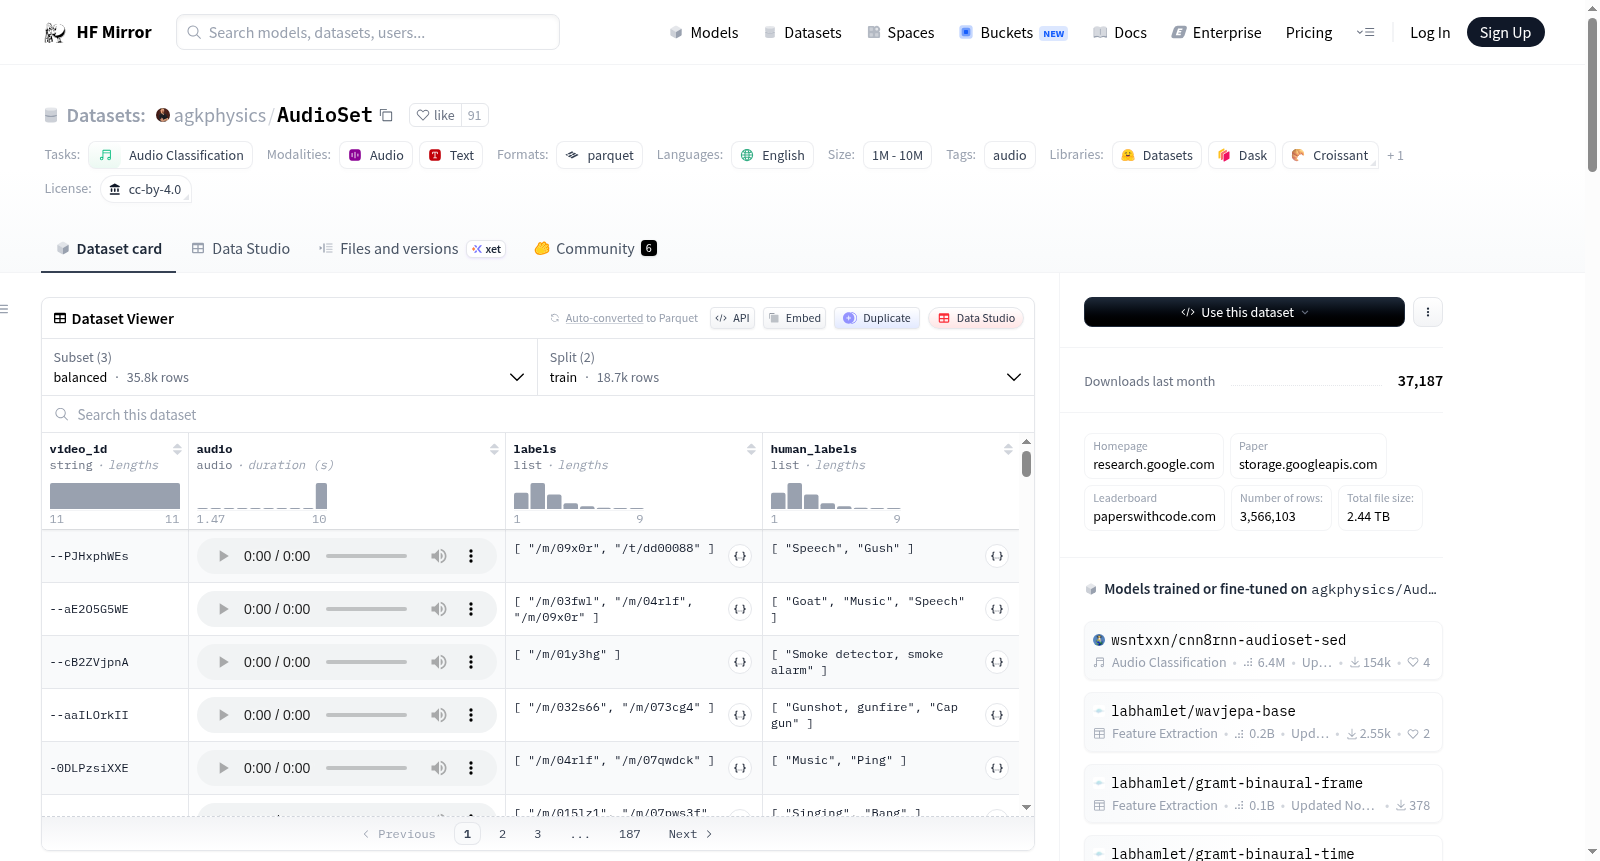
AudioSet是一个包含来自YouTube的10秒音频片段的数据集,这些片段根据AudioSet本体论标注了一个或多个声音类别。数据集支持音频分类任务,分为平衡和不平衡两种配置,分别包含不同数量的训练和测试实例。数据字段包括视频ID、音频数据、标签和人类可读标签。数据集的语言为英语,许可证为CC-BY-4.0。
AudioSet是一个包含来自YouTube的10秒音频片段的数据集,这些片段根据AudioSet本体论标注了一个或多个声音类别。数据集支持音频分类任务,分为平衡和不平衡两种配置,分别包含不同数量的训练和测试实例。数据字段包括视频ID、音频数据、标签和人类可读标签。数据集的语言为英语,许可证为CC-BY-4.0。
数据集概述
数据集名称: AudioSet
任务类别: 音频分类
数据集大小:
- 10K<n<100K
- 1M<n<10M
源数据: 原始数据
许可证: CC-BY-4.0
数据集结构
数据实例
- 字段:
video_id: 字符串,YouTube视频ID。audio: 音频数据,包含路径、数组和采样率。labels: 字符串序列,音频分类标签。human_labels: 字符串序列,人类可读的标签。
数据分割
-
平衡配置:
- 训练集: 18685个实例
- 测试集: 17142个实例
-
不平衡配置:
- 训练集: 1738788个实例
- 测试集: 17142个实例
数据集创建
源语言生产者: 标签来自AudioSet本体,音频剪辑来自YouTube。
许可证信息: AudioSet数据根据CC-BY-4.0许可。
引用信息
bibtex @inproceedings{jort_audioset_2017, title = {Audio Set: An ontology and human-labeled dataset for audio events}, author = {Jort F. Gemmeke and Daniel P. W. Ellis and Dylan Freedman and Aren Jansen and Wade Lawrence and R. Channing Moore and Manoj Plakal and Marvin Ritter}, year = {2017}, booktitle = {Proc. IEEE ICASSP 2017}, address = {New Orleans, LA} }