
NADI_2026_ADI20_micro
收藏官方服务:
资源简介:
ADI-20 Micro是一个用于阿拉伯语方言识别任务的数据集,是ADI-20/ADI-17数据集的精简版本,专为NADI 2026共享任务设计(但鼓励参赛者使用完整ADI-20进行提交)。该数据集包含来自原始ADI-17的音频数据,以及ADI-20中新增的方言数据,每个方言均提供10小时的音频样本。数据集覆盖20种阿拉伯语方言,包括现代标准阿拉伯语(MSA)以及巴林(BAH)、突尼斯(TUN)、阿尔及利亚(ALG)、埃及(EGY)、伊拉克(IRA)、约旦(JOR)、沙特阿拉伯(KSA)、科威特(KUW)、黎巴嫩(LEB)、利比亚(LIB)、毛里塔尼亚(MAU)、摩洛哥(MOR)、阿曼(OMA)、巴勒斯坦(PAL)、卡塔尔(QAT)、苏丹(SUD)、叙利亚(SYR)、阿联酋(UAE)、也门(YEM)等地区方言。数据以音频文件形式提供,每个样本包含音频数据及其对应的方言标签。数据集分为训练集(67,015个样本)和验证集(10,806个样本),总下载大小约为21.8 GB,适用于训练和评估阿拉伯语方言自动识别模型。
创建时间:
2026-06-17
原始信息汇总
数据集概述
数据集名称:ADI-20 Micro
许可证:MIT
语言:阿拉伯语
用途:用于阿拉伯语方言识别模型的训练。
数据集来源
- 基于 ADI-17 和 ADI-20 数据集构建。
- ADI-17来源:ArabicSpeech/ADI17
- ADI-20来源:ArabicSpeech/ADI20
- 相关论文:
数据集内容
- 从完整的ADI-17/ADI-20数据集中选取,每个方言包含 10小时 音频数据。
- 覆盖以下 20种 阿拉伯语方言:
MSA, BAH, TUN, ALG, EGY, IRA, JOR, KSA, KUW, LEB, LIB, MAU, MOR, OMA, PAL, QAT, SUD, SYR, UAE, YEM
数据划分与规模
- 训练集(train):67,015个样本,约18.9 GB
- 验证集(validation):10,806个样本,约2.9 GB
- 总下载大小:约21.8 GB
- 数据集总大小:约21.8 GB
数据特征
audio:音频数据(dtype: audio)dialect:方言标签(dtype: string)
配置与文件结构
- 配置名称:
default - 数据文件路径:
- 训练集:
data/train-* - 验证集:
data/validation-*
- 训练集:
搜集汇总
数据集介绍
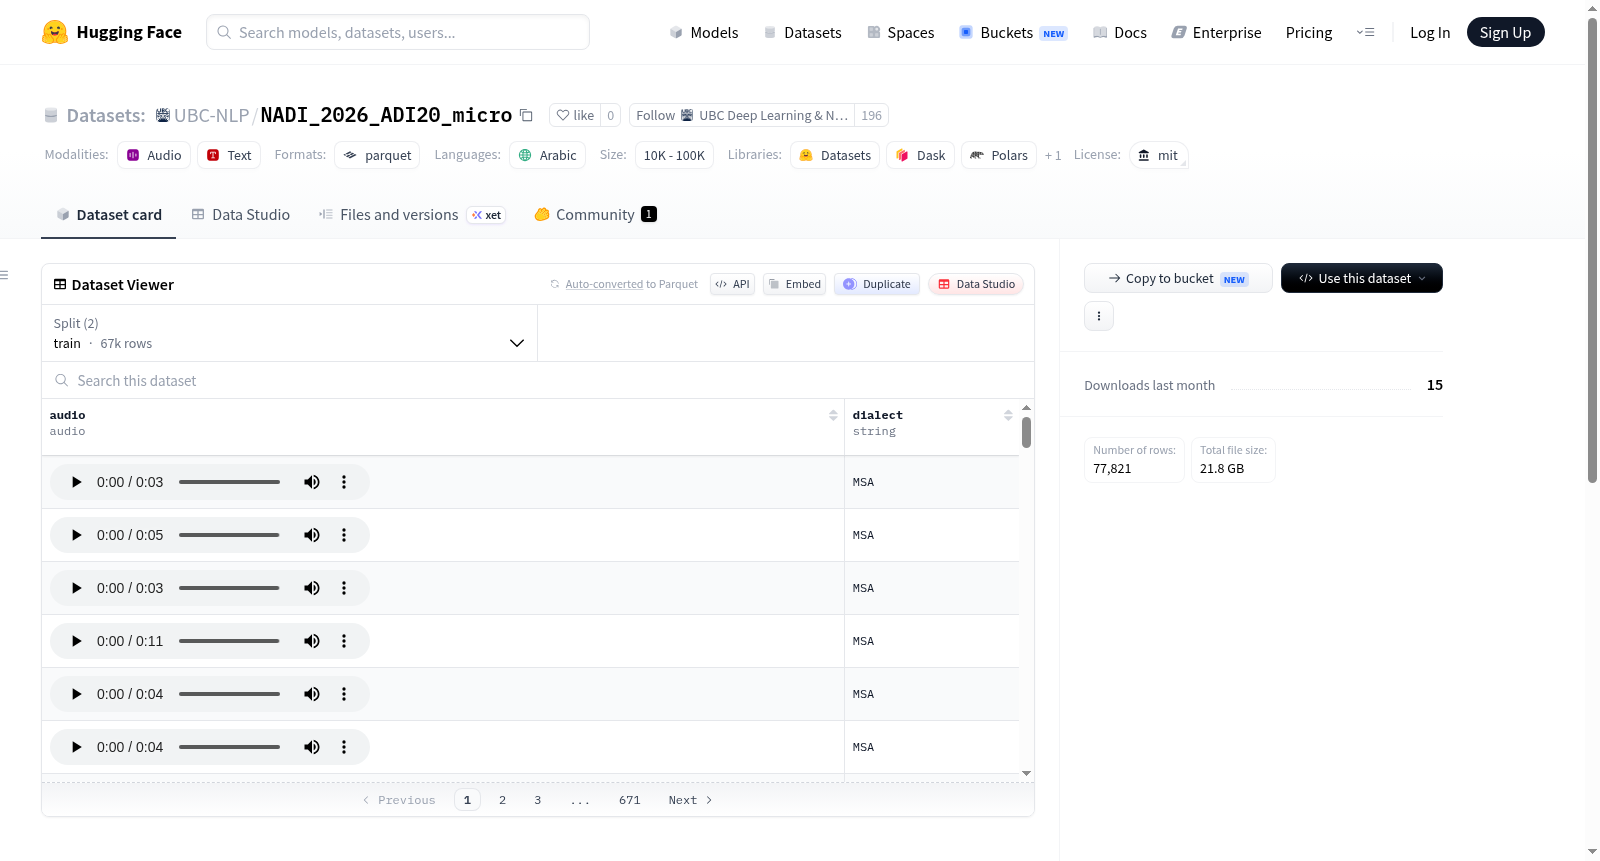
构建方式
该数据集源自NADI 2026共享任务,为ADI-20/ADI-17阿拉伯方言识别数据集的微型版本。在构建上,从原始的ADI-17中为每种方言抽取10小时音频,同时为ADI-20新增的方言同样各提供10小时数据,从而形成约10.8小时的训练集和验证集,共计77,821条语音样本。数据集按方言类别进行标注,涵盖20种阿拉伯方言,确保样本的均衡性与代表性。
特点
NADI_2026_ADI20_micro数据集以精简规模著称,却完整保留了ADI-20的方言多样性,包括现代标准阿拉伯语及巴林、突尼斯、阿尔及利亚等19种地域方言。每个方言类别均配备约10小时的音频素材,有助于模型在小样本条件下实现稳健的方言鉴别。数据集以音频和方言标签构成,格式统一,便于直接用于监督学习任务。
使用方法
该数据集专为阿拉伯方言识别模型的训练与评估而设计。用户可直接利用HuggingFace Datasets库加载默认配置,获取划分好的训练集与验证集。数据以音频文件及其对应的方言标签形式提供,适用于端到端的语音分类框架。研究者可结合预训练语音模型或传统声学特征进行微调,以实现对20种方言的高效识别与分类。
背景与挑战
背景概述
阿拉伯语作为全球使用广泛的语言之一,其多样化的方言体系为自然语言处理研究带来了独特挑战。NADI_2026_ADI20_micro数据集由ArabicSpeech团队于2025年创建,聚焦于阿拉伯语方言识别(ADI)任务,旨在推动多方言语音处理技术的发展。该数据集是ADI-20的简化版本,源自ADI-17并扩展了新增方言,覆盖20种方言类别,包括现代标准阿拉伯语及巴林、突尼斯、阿尔及利亚等19种地域方言。核心研究问题在于如何通过有限标注数据实现高精度方言分类,为低资源语音技术提供基准。该数据集在NADI 2026共享任务中扮演关键角色,对促进跨方言语音模型的可泛化性和研究公平性具有重要影响力,其发布为阿拉伯语社区提供了标准化训练资源。
当前挑战
该数据集所解决的领域问题聚焦于阿拉伯语方言识别的核心挑战:20种方言间高度相似性导致的分类模糊性,尤其在短音频片段中区分如黎凡特与海湾方言等近缘语系。构建过程中遭遇多重技术壁垒,包括从原始ADI-17和ADI-20数据源提取每方言精确10小时音频片段时的数据完整性维护,以及新方言(如毛里塔尼亚、也门等)低资源场景下的标注一致性问题。此外,平衡方言间数据量以消除采样偏差,同时压缩大规模语音文件至可靠存储格式,也增加了预处理复杂度。这些挑战不仅考验模型对细粒度声学特征的敏感度,也凸显了在多方言异质性条件下保证训练集代表性所付出的系统性努力。
常用场景
经典使用场景
NADI_2026_ADI20_micro数据集源自AD I-20项目,旨在为阿拉伯语方言识别任务提供精细化的语音资源。该数据集从原始AD I-17和AD I-20中精选每个方言类别十小时的语音数据,覆盖二十种阿拉伯方言,包括现代标准阿拉伯语及众多地域性变体。其经典应用场景集中于构建高精度、多类别方言分类系统,研究者可基于此音频集合训练端到端或基于特征的识别模型,以区分诸如埃及、沙特、摩洛哥等方言间的细微差异。由于数据规模适中且分布均衡,该版本特别适用于算法原型开发与迁移学习基线建立,为方言语言学与语音处理交叉领域的探索提供了标准化的训练与验证基础。
衍生相关工作
围绕此数据集已衍生出诸多经典研究,包括基于AD I-17与AD I-20的基线模型(如ECAPA-TDNN与wav2vec 2.0微调框架)以及NADI共享任务中的优胜系统。后续工作进一步探索了跨方言域适应技术,通过对比学习增强模型在未见方言上的泛化能力。另有学者利用该语料库构建语音文本联合表示学习范式,在阿拉伯语情感识别与方言到标准语的语音转换任务上取得了突破。此外,方言识别与说话人验证的多任务融合模型亦受其启发,推动了阿拉伯语语音计算从单一判别向多维度理解演进,为未来阿拉伯语语音大模型奠定了数据与算法基石。
数据集最近研究
最新研究方向
NADI_2026_ADI20_micro数据集是阿拉伯语方言识别领域的最新前沿成果,作为NADI 2026共享任务的核心数据支撑,该数据集在ADI-17基础上扩展至20种方言变体,每个方言均提供10小时均衡音频样本,显著提升了低资源方言的覆盖度与模型泛化能力。当前研究热点聚焦于利用该数据集探索端到端深度学习方法在细粒度方言分类中的鲁棒性,尤其结合自监督预训练模型(如wav2vec 2.0)与迁移学习策略,以应对阿拉伯语语内方言差异大、口语化严重的挑战。该数据集的发布不仅推动了多方言语音识别技术的实用化进程,也为阿拉伯语自然语言处理在智能客服、舆情监测等热点应用场景中的地域适应性提供了关键训练基准,具有重要的学术与产业价值。
以上内容由遇见数据集搜集并总结生成


