
maximedb/sick_nl
收藏官方服务:
资源简介:
SICK-NL数据集是SICK数据集的荷兰语翻译版本,经过自动翻译和手动校正,旨在促进荷兰语自然语言处理的研究。数据集包含句子对、语义相关性和蕴含标签等信息,分为训练集、验证集和测试集。具体字段包括句子对ID、句子A、句子B、蕴含标签、语义相关性评分、句子A和B的原始句子、句子A和B的来源数据集等。数据集创建过程保证了翻译的自然性和标签的准确性。
SICK-NL数据集是SICK数据集的荷兰语翻译版本,经过自动翻译和手动校正,旨在促进荷兰语自然语言处理的研究。数据集包含句子对、语义相关性和蕴含标签等信息,分为训练集、验证集和测试集。具体字段包括句子对ID、句子A、句子B、蕴含标签、语义相关性评分、句子A和B的原始句子、句子A和B的来源数据集等。数据集创建过程保证了翻译的自然性和标签的准确性。
提供机构:
maximedb原始信息汇总
数据集概述
数据集名称
- 名称: SICK-NL
数据集特征
- 特征列表:
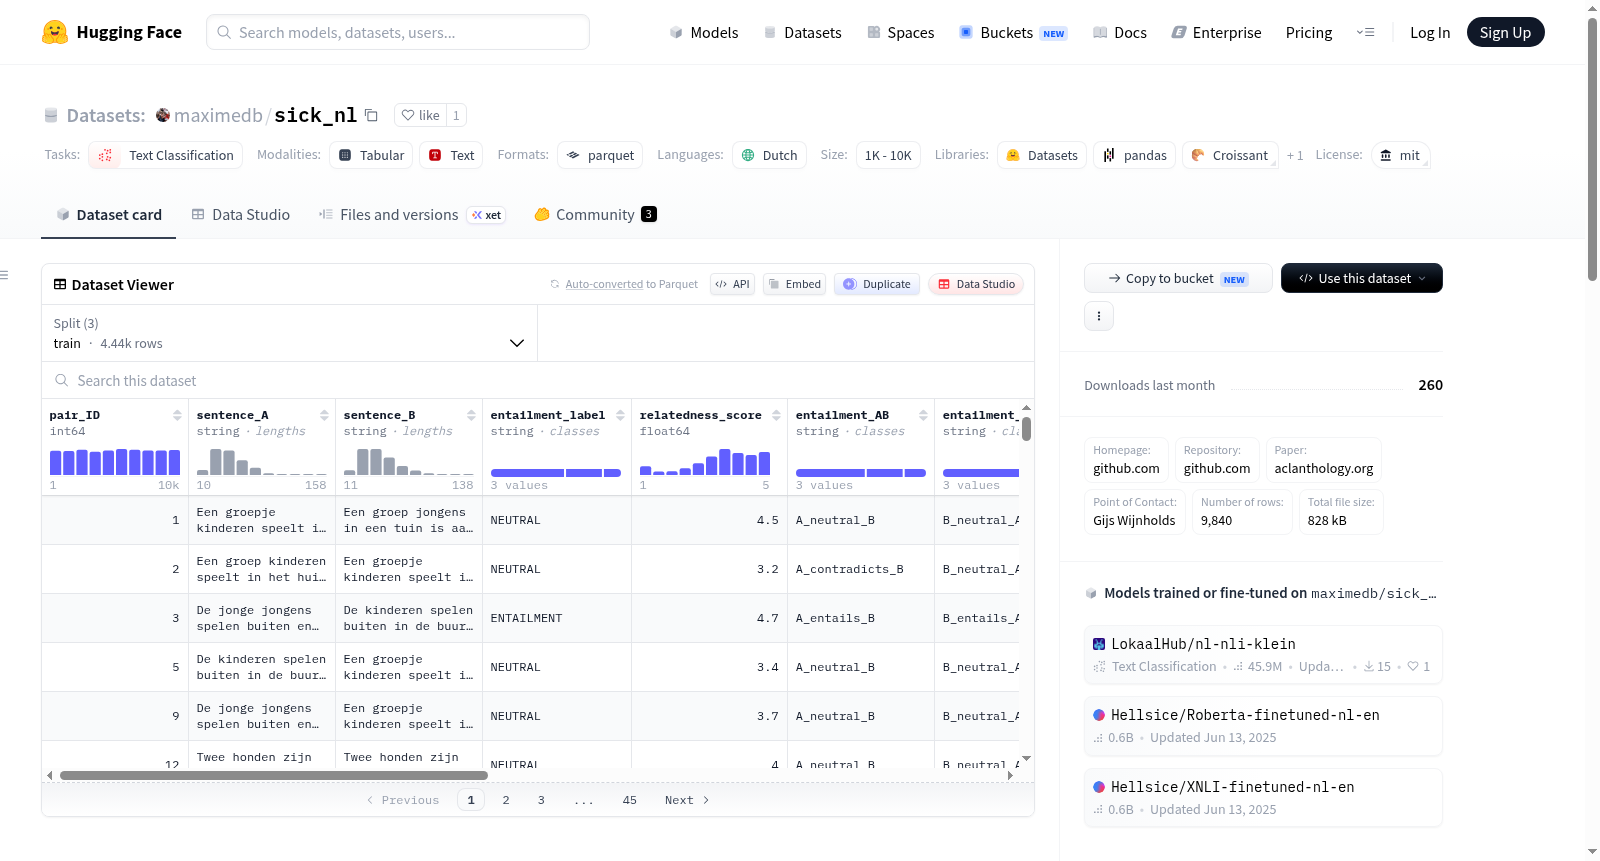
- pair_ID: 句子对ID,数据类型为int64
- sentence_A: 句子A,数据类型为string
- sentence_B: 句子B,数据类型为string
- entailment_label: 蕴含标签,数据类型为string
- relatedness_score: 相关性得分,数据类型为float64
- entailment_AB: A到B的蕴含关系,数据类型为string
- entailment_BA: B到A的蕴含关系,数据类型为string
- sentence_A_original: 句子A的原始形式,数据类型为string
- sentence_B_original: 句子B的原始形式,数据类型为string
- sentence_A_dataset: 句子A的来源数据集,数据类型为string
- sentence_B_dataset: 句子B的来源数据集,数据类型为string
- SemEval_set: SemEval集合,数据类型为string
- label: 文本蕴含黄金标签,数据类型为int64
- label_seq2seq: 序列到序列标签,数据类型为string
数据集结构
- 数据分割:
- train: 训练集,包含4439个样本,占用1359887字节
- validation: 验证集,包含495个样本,占用153417字节
- test: 测试集,包含4906个样本,占用1496660字节
数据集大小
- 下载大小: 822658字节
- 数据集大小: 3009964字节
许可信息
- 许可证: MIT
任务类别
- 任务: 文本分类
语言
- 语言: 荷兰语
大小类别
- 大小: 1K<n<10K
搜集汇总
数据集介绍
构建方式
在自然语言推理(NLI)领域,高质量的非英语数据集对于推动多语言研究至关重要。SICK-NL数据集正是为此而生,它源自经典的英文SICK数据集(Marelli et al., 2014),经过自动翻译与人工校正的双重流程构建而成。具体而言,研究团队首先将原始英文句子对批量翻译为荷兰语,随后由母语者逐句核查并修正翻译中的语义偏差与语法错误。这一过程不仅保留了原始数据中蕴含的语义关联度评分与蕴含标签,还确保了翻译后句子的自然性与准确性。由于数据集中的句子对ID与原版完全一致,因此SICK-NL在微观句级层面与原数据集实现了完美对齐。
特点
SICK-NL数据集面向荷兰语文本蕴含与语义关联度任务,其核心特征在于规模适中且标注信息丰富。数据集共包含约9840个句子对,划分为训练集(4439例)、验证集(495例)与测试集(4906例)。每个样本均提供文本蕴含标签(蕴含、中立、矛盾)、语义关联度评分(1-5连续尺度)以及双向蕴含关系标注(AB与BA顺序),为多角度语义分析提供了坚实基础。此外,数据字段还保留了原始句子的来源信息(FLICKR或SEMEVAL),便于研究者追溯数据生成背景。其MIT开源许可协议进一步降低了使用门槛。
使用方法
SICK-NL数据集主要适用于荷兰语文本分类任务,特别是自然语言推理与语义相似度计算。使用者可直接加载Hugging Face上的maximedb/sick_nl仓库,通过标准的数据集API获取预划分的训练、验证与测试分片。在模型训练中,推荐利用label字段(整数编码)进行蕴含分类,或使用relatedness_score字段进行回归任务。由于数据保留了原始英文句子的ID与来源,研究者亦可将其与原版SICK数据集进行跨语言对比实验。对于需要序列到序列生成的任务,label_seq2seq字段提供了文本形式的标签表示,便于直接作为生成目标使用。
背景与挑战
背景概述
自然语言推理(NLI)是自然语言处理领域的核心任务之一,旨在判断两个句子之间的语义关系——蕴含、矛盾或中性。尽管英文NLI数据集如SICK(Marelli et al., 2014)已广泛推动研究进展,但低资源语言如荷兰语的同类资源长期匮乏。SICK-NL数据集由Gijs Wijnholds与Michael Moortgat于2021年在EACL会议上提出,旨在填补这一空白。该数据集基于英文SICK数据集,通过自动翻译与人工校正构建,保留了原始句对ID、关联性评分及蕴含标签,确保与英文版本在句子级别的完全对齐。其核心研究问题聚焦于为荷兰语NLI任务提供高质量、规模适中的基准数据,涵盖约9800个句对,划分为训练、验证与测试集。SICK-NL的发布显著推动了荷兰语自然语言理解的研究,成为评估多语言NLI模型性能的重要工具,并促进了低资源语言NLI数据构建方法的探索。
当前挑战
SICK-NL数据集面临的核心挑战在于多维度语义关系的精确建模。首先,领域问题层面,荷兰语NLI任务需处理语言特异性歧义与句法结构差异,例如荷兰语中可分离动词与语序灵活性可能导致蕴含关系判断的复杂性。其次,构建过程中,自动翻译阶段产生的语义漂移与人工校正的标注一致性构成显著困难,尤其是保持原始英文SICK数据集的关联性评分与蕴含标签在翻译后的自然性。此外,数据集规模有限(约1万句对),可能限制深度学习模型的泛化能力,尤其在处理长尾语义现象时。最后,跨语言对齐的准确性需持续验证,以确保荷兰语句对与英文原版在语义等价性上的稳健对应,这对多语言NLI系统的公平评估提出更高要求。
常用场景
经典使用场景
SICK-NL数据集是面向荷兰语自然语言推理(NLI)与语义相关度评估的经典基准资源,其设计灵感源自英文SICK数据集,经自动翻译与人工校正后构建而成。该数据集包含近万个句子对,每个句子对均标注了蕴含关系(蕴含、中立或矛盾)以及语义相关度分数(1-5连续刻度)。在荷兰语NLP研究中,它被广泛用于训练和评估模型在细粒度语义理解上的表现,尤其适合检验跨语言迁移学习与多语言预训练模型在低资源语言上的泛化能力。研究者常将SICK-NL作为标准测试集,对比不同架构(如基于Transformer的编码器)在荷兰语蕴含判断任务上的准确率与相关性预测的皮尔逊相关系数。
解决学术问题
SICK-NL数据集的问世有效填补了荷兰语自然语言理解领域缺乏高质量、标准化评估基准的空白。在学术研究中,它系统性地解决了两个关键问题:一是为荷兰语NLI任务提供了人工验证的黄金标注数据,使得研究者能够客观衡量模型在语义推断上的真实表现,从而推动荷兰语语义计算从理论走向实证;二是通过保留与英文SICK数据集完全对齐的句子ID,支持跨语言对比分析,助力探索语义表示的语言无关性。该数据集促进了多语言NLP评估体系的完善,并成为验证荷兰语预训练语言模型(如BERTje、RobBERT)语义理解能力的核心工具,对低资源语言NLP研究具有里程碑式的意义。
衍生相关工作
SICK-NL数据集的发布催生了一系列荷兰语NLP领域的经典工作。Wijnholds与Moortgat(2021)在原始论文中即利用该数据集评估了多语言BERT(mBERT)与荷兰语专用BERT(BERTje)在NLI任务上的表现,揭示了跨语言模型在低资源语言上的性能瓶颈。后续研究者基于SICK-NL扩展了荷兰语语义评估体系,例如整合至Dutch GLUE基准中,用于系统评测预训练模型的多种语言理解能力。此外,该数据集还被用于训练荷兰语语义相似度模型,并作为对抗性攻击测试的靶标,以检验模型对细微语义变化的鲁棒性。这些衍生工作共同推动了荷兰语NLP从基础资源建设迈向更深层次的语义分析研究。
以上内容由遇见数据集搜集并总结生成


