kawaii-emoji-kaomoji
收藏资源简介:
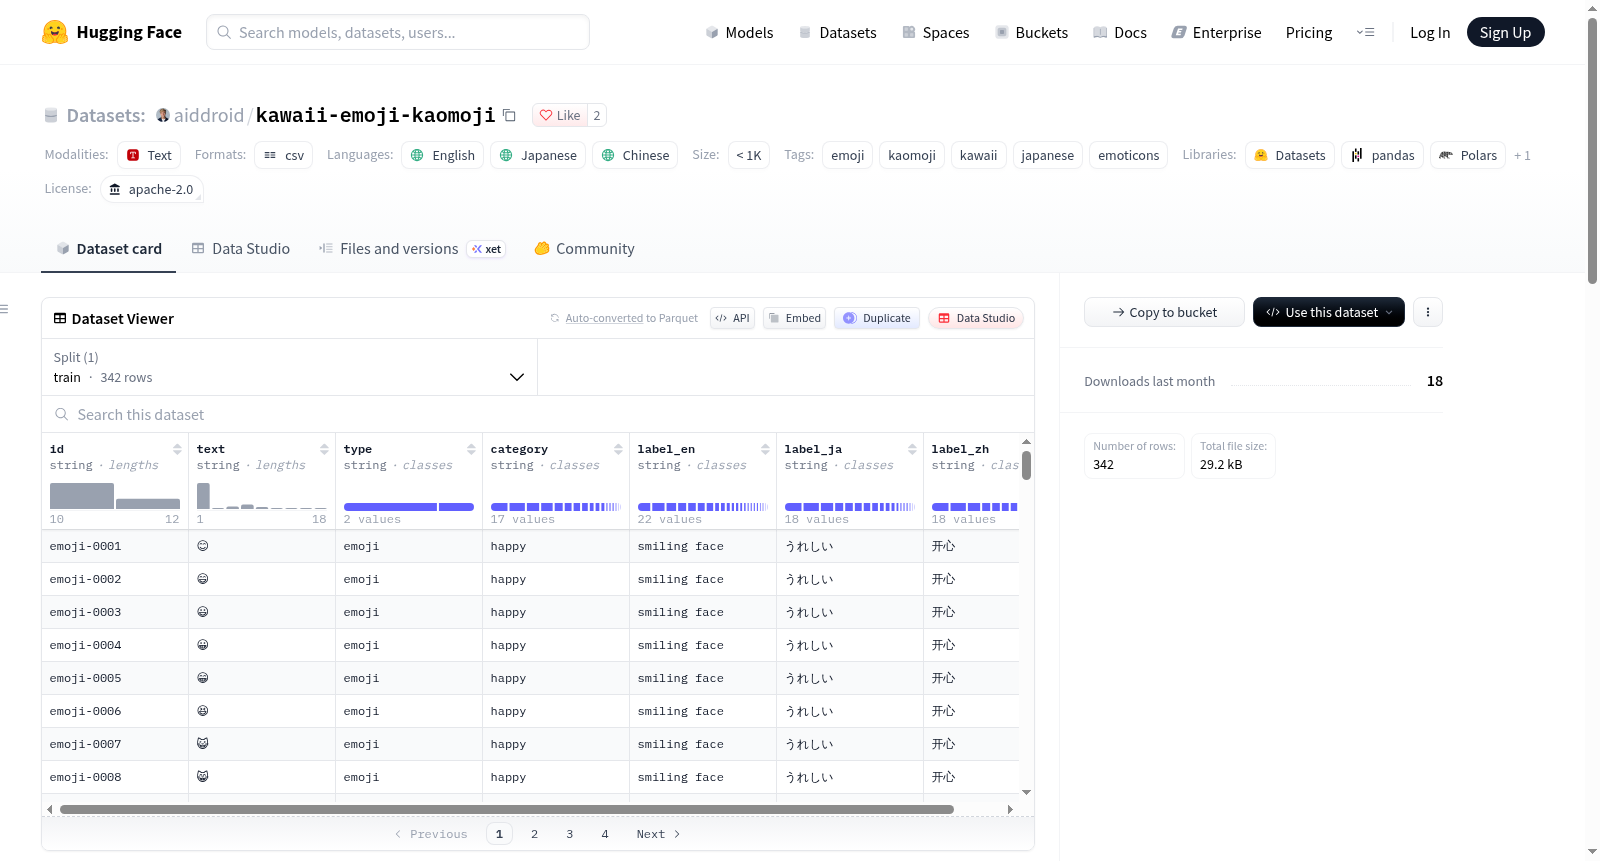
Kawaii Emoji and Kaomoji Dataset 是一个小型、独立策划的可爱 emoji 与日式文本颜文字(kaomoji)集合,面向浏览、搜索和创意项目等用途。数据集包含 342 条条目:246 个 emoji 和 96 个 kaomoji,标签以英语、日语和简体中文提供。数据以 data/train.csv 形式发布,默认配置为 default,split 为 train;该 train split 只是加载整个集合的打包约定,并非训练/测试基准。每一行对应一个 Unicode emoji 序列或 kaomoji。字段包括:id(数据集标识符,例如 emoji-0001 或 kaomoji-0001)、text(可显示或复制的 emoji 或 kaomoji)、type(emoji 或 kaomoji)、category(广义英文类别,如 happy、love、animals)、label_en(简短英文组描述)、label_ja(日文类别标签)、label_zh(简体中文类别标签)。标签描述的是组别而非每个条目的精确含义;一个符号可能适合多个类别,但每个条目仅按编辑选定的一个类别列出,解释会随语境和文化而变化。数据集可通过 Hugging Face Datasets 加载,或下载 UTF-8 CSV 使用;处理 text 列时应保留 Unicode 序列,包括 variation selectors 和 zero-width joiners;渲染可能因设备和字体不同而异。该数据集是独立编辑选编的常见 Unicode emoji 与文本 kaomoji,并非从 KawaiiEmoji 复制或抓取。README 还提到 KawaiiEmoji 网站可作为探索和复制更多表达的便捷方式,该网站是含 emoji、kaomoji 和 ASCII art 类别的日语集合,但数据本身并非取自该网站。标签为人工分配,不是使用统计;该集合不声称衡量流行度或代表全部日本用法。Kaomoji 是非正式表达,存在广泛共享的变体,个体解释可能不同。数据集的原始选择、排列和标签采用 Apache License 2.0;设备或字体显示的 emoji 字形设计由其各自供应商提供,可能受单独权利约束;本数据集包含文本序列,而非图像文件。元数据表明语言为 en、ja、zh,规模类别为 n<1K,标签包括 emoji、kaomoji、kawaii、japanese、emoticons。适用于浏览、搜索、复制、探索日常消息与 SNS 表达以及创意项目。
Kawaii Emoji and Kaomoji Dataset is a small, independently curated collection of cute emoji and Japanese text kaomoji, intended for browsing, search, and creative projects. It contains 342 entries: 246 emoji and 96 kaomoji, with labels provided in English, Japanese, and Simplified Chinese. The data is released as data/train.csv under the default configuration and train split; this train split is a packaging convention for loading the entire collection, not a training/testing benchmark. Each row corresponds to one Unicode emoji sequence or kaomoji. Fields include id (dataset identifier, such as emoji-0001 or kaomoji-0001), text (the displayable or copyable emoji or kaomoji), type (emoji or kaomoji), category (broad English category, such as happy, love, animals), label_en (short English group description), label_ja (Japanese category label), and label_zh (Simplified Chinese category label). Labels describe groups rather than the exact meaning of each entry; a symbol may fit multiple categories, but each entry is listed under only one editor-selected category, and interpretation varies with context and culture. The dataset can be loaded via Hugging Face Datasets or downloaded as a UTF-8 CSV; when processing the text column, Unicode sequences should be preserved, including variation selectors and zero-width joiners; rendering may differ by device and font. It is an independently edited selection of common Unicode emoji and text kaomoji, not copied or scraped from KawaiiEmoji. The README also mentions the KawaiiEmoji website as a convenient way to explore and copy more expressions; that website is a Japanese collection with emoji, kaomoji, and ASCII art categories, but the data itself is not taken from it. Labels are manually assigned, not usage statistics; the collection does not claim to measure popularity or represent all Japanese usage. Kaomoji are informal expressions with widely shared variants, and individual interpretations may differ. The original selection, arrangement, and labels are under Apache License 2.0; emoji glyph designs displayed by devices or fonts are provided by their respective vendors and may be subject to separate rights; this dataset contains text sequences, not image files. Metadata indicates languages en, ja, zh, size category n<1K, and tags including emoji, kaomoji, kawaii, japanese, emoticons. It is suitable for browsing, search, copying, exploring everyday messaging and SNS expression, and creative projects.
Kawaii Emoji and Kaomoji Dataset 🎀
基本信息
- 数据集页面:
https://huggingface.co/datasets/aiddroid/kawaii-emoji-kaomoji - 许可证:Apache-2.0 / Apache License 2.0,
https://www.apache.org/licenses/LICENSE-2.0 - 语言:en、ja、zh
- 大小类别:n<1K
- 条目数:342 条
- emoji:246 条
- kaomoji:96 条
- 标签:emoji、kaomoji、kawaii、japanese、emoticons
- 配置:default
- 训练集数据文件绝对地址:
https://huggingface.co/datasets/aiddroid/kawaii-emoji-kaomoji/blob/main/data/train.csv
数据集说明
- 小型、独立策划的可爱 emoji 和日式文本表情(kaomoji)集合。
- 用于浏览、搜索和创意项目。
- 标签以英语、日语和简体中文提供。
- README 提及外部资源:KawaiiEmoji — 可愛い絵文字と顔文字,
https://kawaiiemoji.com/。
数据内容
- 每一行是一个 Unicode emoji 序列或 kaomoji。
trainsplit 是加载整个集合的打包约定,不是训练/测试基准。
| 字段 | 描述 |
|---|---|
id |
数据集标识符,例如 emoji-0001 或 kaomoji-0001 |
text |
要显示或复制的 emoji 或 kaomoji |
type |
emoji 或 kaomoji |
category |
宽泛英文类别,例如 happy、love 或 animals |
label_en |
简短英文分组描述 |
label_ja |
日语类别标签 |
label_zh |
简体中文类别标签 |
- 标签描述分组,而非每个条目的确切含义。
- 一个符号可能适合多个类别;每个条目只列在一个编辑选择的类别下。
- 解释可能因语境和文化而异。
使用方式
- 使用 Hugging Face Datasets 加载:
python from datasets import load_dataset
dataset = load_dataset("aiddroid/kawaii-emoji-kaomoji", split="train") print(dataset[0])
kaomoji = dataset.filter(lambda row: row["type"] == "kaomoji") print(kaomoji[0]["text"])
- 或下载训练集 CSV,并以 UTF-8 CSV 在电子表格或编程语言中打开。
- 处理
text列时保留 Unicode 序列,包括变体选择符和零宽连接符。 - 渲染可能因设备和字体而异。
策展与限制
- 独立汇编的编辑选择,包含熟悉的 Unicode emoji 和基于文本的 kaomoji。
- 并非从 KawaiiEmoji 复制或抓取。
- 标签为手动分配,不是使用统计。
- 不声称衡量流行度或代表所有日语用法。
- Kaomoji 是非正式表达,有广泛共享的变体,个人解释可能不同。
许可
- 数据集原始选择、编排和标签根据 Apache License 2.0 提供。
- 设备或字体显示的 emoji 字形设计由各自供应商提供,可能受单独权利约束。
- 数据集包含文本序列,不是图像文件。