
nlu-metaphor
收藏官方服务:
资源简介:
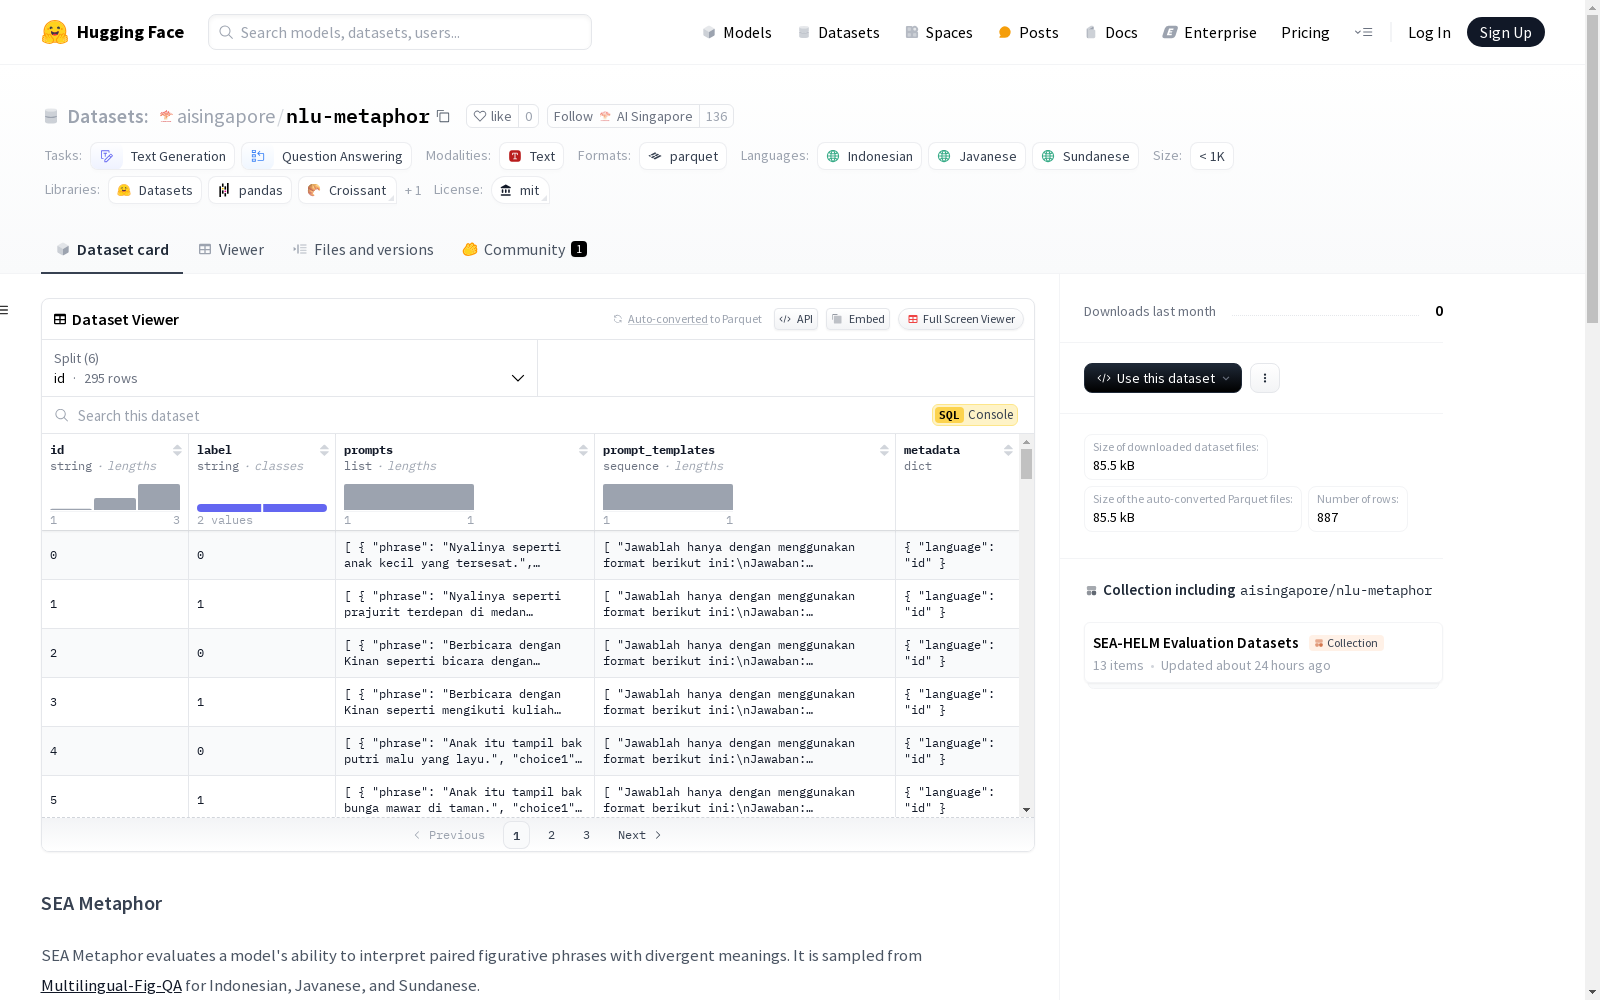
SEA Metaphor数据集用于评估模型解释具有不同含义的配对比喻短语的能力。该数据集从Multilingual-Fig-QA中采样,涵盖印度尼西亚语、爪哇语和巽他语。数据集包含不同语言的多个分割,包括少样本示例。每个分割的统计信息包括示例数量和不同模型的标记数量。数据集支持的任务包括文本生成和问答,并且是SEA-HELM排行榜的一部分。
The SEA Metaphor dataset is designed to evaluate models' ability to interpret paired metaphorical phrases with distinct meanings. Sampled from Multilingual-Fig-QA, this dataset covers Indonesian, Javanese, and Sundanese languages. It includes multiple splits across different languages, with few-shot examples provided. Statistics for each split include the number of examples and the token counts of various models. Supported tasks of the dataset include text generation and question answering, and it is part of the SEA-HELM leaderboard.
提供机构:
AI Singapore创建时间:
2024-12-11
搜集汇总
数据集介绍
构建方式
SEA Metaphor数据集的构建基于[Multilingual-Fig-QA](https://aclanthology.org/2023.findings-acl.525),专门用于评估模型对具有不同含义的成对比喻性短语的理解能力。该数据集从印尼语、爪哇语和巽他语中抽取样本,通过精心设计的提示模板和选项,确保每个语言的比喻性短语能够被有效评估。此外,数据集还包含了少样本示例,以支持模型在有限数据情况下的表现评估。
特点
SEA Metaphor数据集的显著特点在于其多语言性和比喻性短语的多样性。该数据集涵盖了印尼语、爪哇语和巽他语,每种语言都有其独特的比喻表达方式。此外,数据集中的提示模板和选项设计精巧,能够有效测试模型对比喻性短语的理解能力。数据集还提供了少样本示例,使得模型在有限数据情况下的表现也能得到评估。
使用方法
SEA Metaphor数据集主要用于评估和优化大型语言模型(LLMs)在比喻性语言理解方面的能力。用户可以通过加载数据集中的不同语言子集(如印尼语、爪哇语和巽他语),并使用其中的提示模板和选项进行模型训练和测试。此外,数据集中的少样本示例可以用于评估模型在有限数据情况下的表现,从而为模型的微调和优化提供依据。
背景与挑战
背景概述
SEA Metaphor数据集由AI Singapore主导开发,旨在评估大型语言模型在解释具有不同含义的成对比喻性短语方面的能力。该数据集源自Multilingual-Fig-QA项目,涵盖了印度尼西亚语、爪哇语和巽他语三种语言。其核心研究问题聚焦于多语言和文化背景下比喻语言的理解,这对于提升自然语言处理模型在跨文化交流中的表现具有重要意义。SEA Metaphor不仅为研究者提供了一个标准化的评估工具,还通过SEA-HELM排行榜推动了相关领域的技术进步。
当前挑战
SEA Metaphor数据集面临的挑战主要集中在多语言和文化背景下的比喻语言理解。首先,不同语言和文化中的比喻表达方式差异显著,构建一个能够准确反映这些差异的数据集极具挑战性。其次,数据集的构建过程中需要确保样本的代表性和多样性,以避免偏见和过拟合问题。此外,如何有效地评估模型在处理比喻语言时的表现,也是一个亟待解决的技术难题。
常用场景
经典使用场景
SEA Metaphor数据集主要用于评估大型语言模型(LLMs)在解释具有不同含义的成对比喻性短语方面的能力。该数据集通过提供多种语言(如印尼语、爪哇语和巽他语)的比喻性短语及其对应的解释,帮助模型学习并识别这些短语的隐含意义,从而提升模型在多语言环境下的语言理解和生成能力。
解决学术问题
SEA Metaphor数据集解决了多语言环境下比喻语言理解的关键学术问题。通过提供多种语言的比喻性短语及其解释,该数据集有助于研究者开发和评估能够跨语言理解和生成比喻性语言的模型,从而推动多语言自然语言处理(NLP)领域的发展,特别是在跨文化语言理解方面的研究。
衍生相关工作
基于SEA Metaphor数据集,研究者们已经开展了一系列相关工作,包括多语言比喻语言理解的模型开发、跨文化语言理解的评估方法研究,以及在多语言聊天机器人中的应用。这些工作不仅推动了多语言NLP技术的发展,也为跨文化交流和教育领域的应用提供了新的技术支持。
以上内容由遇见数据集搜集并总结生成


