open-models-benchmark-results
收藏资源简介:
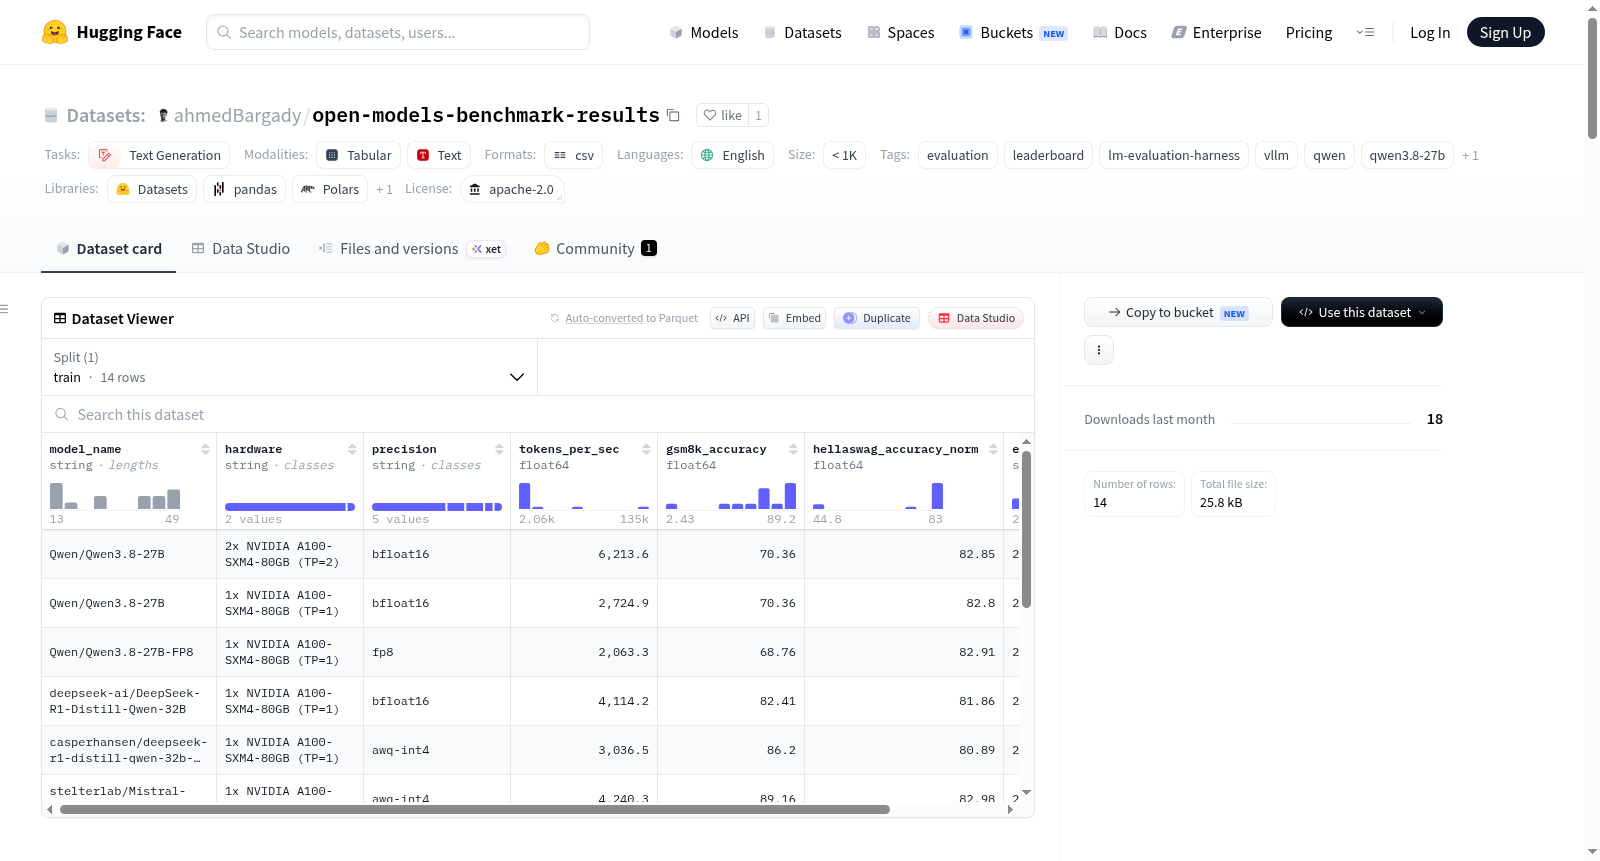
该数据集是一个本地LLM评估排行榜,由@ahmedBargady维护。数据集的目的是系统性地评估和比较开源基础模型在本地集群环境下的性能,涵盖数学推理、常识推理和推理吞吐量三个维度。所有评估均在标准化的硬件配置上进行:2x NVIDIA A100-SXM4-80GB GPU(总计160GB显存),使用vLLM(v0.27.1)推理引擎和EleutherAI lm-evaluation-harness评估框架。数据集存储为CSV格式(`data/train.csv`),包含以下字段:模型名称、硬件/执行配置(如单GPU或双GPU张量并行)、精度(bfloat16、FP8、AWQ-int4等)、输入速度(tokens/s)、GSM8K严格精确匹配得分、HellaSwag长度归一化准确率得分以及评估日期。当前数据集包含13个模型/配置的评估结果,涵盖Qwen3.8-27B、DeepSeek-R1-Distill-Qwen-32B、Mistral-Small-24B-Instruct-2501等模型及其量化变体。该数据集适用于模型性能比较、量化与硬件配置的权衡分析,以及复现本地LLM评估。
This dataset is a local LLM evaluation leaderboard maintained by @ahmedBargady. The purpose of the dataset is to systematically evaluate and compare the performance of open-source base models in a local cluster environment, covering three dimensions: mathematical reasoning, commonsense reasoning, and inference throughput. All evaluations are conducted on standardized hardware configuration: 2x NVIDIA A100-SXM4-80GB GPU (total 160GB VRAM), using vLLM (v0.27.1) inference engine and EleutherAI lm-evaluation-harness framework. The dataset is stored in CSV format (`data/train.csv`), containing the following fields: model name, hardware/execution configuration (e.g., single GPU or dual GPU tensor parallelism), precision (bfloat16, FP8, AWQ-int4, etc.), input speed (tokens/s), GSM8K strict exact match score, HellaSwag length-normalized accuracy score, and evaluation date. The current dataset includes evaluation results for 13 model/configurations, covering models such as Qwen3.8-27B, DeepSeek-R1-Distill-Qwen-32B, Mistral-Small-24B-Instruct-2501, and their quantized variants. This dataset is suitable for model performance comparison, trade-off analysis between quantization and hardware configuration, and reproducing local LLM evaluations.
⚡ 本地 LLM 评估排行榜数据集
数据集概览
这是由 @ahmedBargady 维护的公开基准测试排行榜,记录了开源权重基础模型在本地 NVIDIA A100 GPU 上的评估指标、准确率得分、吞吐量遥测数据及量化权衡分析。数据集采用 Apache 2.0 许可证,主要面向英文文本生成任务的模型评估。
硬件与系统配置
| 配置项 | 详情 |
|---|---|
| 维护者 | @ahmedBargady |
| GPU 设置 | 2x NVIDIA A100-SXM4-80GB |
| 总显存 | 160 GB |
| 推理引擎 | vLLM (v0.27.1) / CUDA 13.2 |
| 评估框架 | EleutherAI lm-evaluation-harness |
评估指标说明
本数据集从三个主要维度评估模型性能:
-
GSM8K — 数学与多步推理能力,采用严格精确匹配(Strict Exact Match)评估。包含 8,500 道小学水平的数学应用题,测试模型的多步推理、算术计算和思维链逻辑能力。
-
85.0%:卓越的数学与多步推理能力
- 70.0% - 85.0%:较强的通用推理能力
- < 60.0%:在多步算术或格式约束方面表现不足
-
-
HellaSwag — 常识推理与自然语言推断能力,采用长度归一化准确率(Acc Norm)评估。测试模型对现实场景(体育活动、烹饪、日常人际互动等)最合理续写选项的选择能力。
-
82.0%:最先进的常识理解与物理世界上下文对齐能力
- 75.0% - 82.0%:良好的语言理解与上下文补全能力
- ~25.0%:随机猜测基线(4 选 1 多项选择)
-
-
输入速度(tok/s) — 预填充吞吐量与推理遥测数据,衡量批处理评估期间 vLLM 下的每秒处理 token 数。更高的输入吞吐量意味着更快的提示处理速度和更低的首次 token 延迟。
- TP=2(双 A100):可达 6,200+ tok/s,利用 NVLink 张量并行
- TP=1(单 A100):根据模型架构和量化精度在 2,000 - 4,200 tok/s 之间变化
排行榜数据摘要
| 模型 | 硬件/执行 | 精度 | 输入速度 (tok/s) | GSM8K | HellaSwag | 日期 |
|---|---|---|---|---|---|---|
| Qwen/Qwen3.8-27B | 2x A100 (TP=2) | bfloat16 | 6,213.6 | 70.36% | 82.85% | 2026-08-22 |
| Qwen/Qwen3.8-27B | 1x A100 (TP=1) | bfloat16 | 2,724.9 | 70.36% | 82.80% | 2026-08-22 |
| Qwen/Qwen3.8-27B-FP8 | 1x A100 (TP=1) | fp8 | 2,063.3 | 68.76% | 82.91% | 2026-08-22 |
| deepseek-ai/DeepSeek-R1-Distill-Qwen-32B | 1x A100 (TP=1) | bfloat16 | 4,114.2 | 82.41% | 81.86% | 2026-08-22 |
| casperhansen/deepseek-r1-distill-qwen-32b-awq | 1x A100 (TP=1) | awq-int4 | 3,036.5 | 86.20% | 80.89% | 2026-08-23 |
| stelterlab/Mistral-Small-24B-Instruct-2501-AWQ | 1x A100 (TP=1) | awq-int4 | 4,240.3 | 89.16% | 82.98% | 2026-08-23 |
| orcarouter/Qwen3.8-27B-Uncensored-FP8 | 1x A100 (TP=1) | fp8 | 2,890.7 | 73.16% | 82.91% | 2026-08-23 |
| RedHatAI/DeepSeek-R1-Distill-Qwen-32B-FP8-dynamic | 1x A100 (TP=1) | fp8-dynamic | 3,571.9 | 81.73% | 81.86% | 2026-08-23 |
| ornith-ai/Ornith-1.5-35B-A3B | 1x A100 (TP=1) | bfloat16 | 5,982.0 | 50.27% | 81.02% | 2026-08-23 |
| mlasli/Qwen3.8-27B-Heretic-Uncensored-BF16 | 1x A100 (TP=1) | bfloat16 | 3,895.0 | 58.76% | 82.45% | 2026-08-23 |
| Qwen/Qwen3-8B | 1x A100 (TP=1) | bfloat16 | 16,348.7 | 87.57% | 74.89% | 2026-08-23 |
| Qwen/Qwen3-0.6B | 1x A100 (TP=1) | bfloat16 | 134,702.1 | 42.00% | 47.22% | 2026-08-23 |
| deepseek-ai/DeepSeek-R1-Distill-Qwen-1.5B | 1x A100 (TP=1) | bfloat16 | 63,708.2 | 70.36% | 44.80% | 2026-08-23 |
| nvidia/Qwen3.6-35B-A3B-NVFP4 | 1x A100 (TP=1) | nvfp4 | 7,782.5 | 2.43% | 83.02% | 2026-08-23 |
关键发现与权衡分析
-
量化影响(FP8 vs BF16):
- GSM8K 数学推理:完整
bfloat16为 70.36%,而FP8量化版本为 68.76%(仅下降约 1.6%,但显存占用降低 50%) - HellaSwag 常识 NLI:两个模型表现几乎一致(82.80% vs 82.91%)
- GSM8K 数学推理:完整
-
张量并行扩展(2x A100 vs 1x A100):
- 通过张量并行扩展到 2 块 A100 GPU,预填充吞吐量从 2,724.9 tok/s 提升至 6,213.6 tok/s(加速 2.28 倍)
仓库文件结构
data/train.csv:驱动 Hugging Face 原生数据集查看器的结构化 CSV 表格数据leaderboard.csv:基准测试摘要指标的主副本hf_bench_results.json:包含每个样本的提示日志、似然值和模型配置的原始输出 JSONREADME.md:数据集卡片文档