cladsu/COSER-2024
收藏资源简介:
该数据集是西班牙农村口语和声音语料库(COSER)的一部分,包含了230份经过专家手动注释和分段的访谈转录。这些访谈来自西班牙农村地区,参与者平均年龄为74岁,通常接受过较少的教育且地理流动性较低。访谈内容涵盖了各种方言和口语表达,转录中包含了多种标记,如笑声、哭泣、其他语言的使用等。数据集还详细描述了转录中的各种注释方法,如语音标记、同时说话、交叉对话等。
该数据集是西班牙农村口语和声音语料库(COSER)的一部分,包含了230份经过专家手动注释和分段的访谈转录。这些访谈来自西班牙农村地区,参与者平均年龄为74岁,通常接受过较少的教育且地理流动性较低。访谈内容涵盖了各种方言和口语表达,转录中包含了多种标记,如笑声、哭泣、其他语言的使用等。数据集还详细描述了转录中的各种注释方法,如语音标记、同时说话、交叉对话等。
数据集卡片 for Dataset Name
数据集详情
数据集描述
El Corpus Oral y Sonoro del Español Rural - COSER (http://www.corpusrural.es/) 包含1,772次半结构化访谈(共1,910小时录音),时间跨度从1990年到2022年。受访者来自农村地区,平均年龄为74岁,通常接受的教育较少且地理流动性较低。受访者中男女比例均衡,其中47.8%为男性,52.2%为女性。目前,该语料库已记录了西班牙领土(半岛和两个群岛)的1,415个飞地。
在此语料库中,我们收集了230次半结构化访谈,这些访谈经过手动注释、审查和分段。
数据集结构
语音发射
- Risa ([RISA]): 用于标记单个人的笑声,无论是采访者还是受访者。
- Risas ([RISAS]): 用于标记多人的笑声。
- Risa en habla ([Rndo: ]): 受访者在讲述时笑。可以先标记,然后写入相应片段,或先选择片段再点击此工具。
- Llanto en habla ([Llndo: ]): 受访者在讲述时哭泣。使用方法与“risa en habla”相同。
- Otra lengua ([L-Otra: ]): 用于标记受访者使用非西班牙语语言的片段。选择标记后,写入原始语言片段,或选择片段后点击该标记。在这种情况下,不应进行西班牙语的等效转换。
- Exclamaciones ([EXCL]): 建议不使用此标记。例如,如果受访者说“ay”或“ah”等感叹词,最好用感叹号转录:“¡Ay!”,“¡Ah!”。
- Asentimiento ([Asent]): 用于表示口头语言中用于同意的任何发射。如果受访者或采访者说“uhum”,“aham”,“hum”等,不转录,而是使用此标记。如果说是“sí”,则不使用此标记,而是转录。每次使用此标记时,都应加上句点(“.”),因为它算作任何干预:“I1: Mi hijo no vive aquí, por eso ya no hago matanza” / “E1: [Asent]. ¿Y desde cuándo?”。
- Tos ([TOS]).
- Carraspeo ([CARRASP]).
- Chasquido ([CHASQ]).
- Onomatopeya ([ONOMAT]): 用于标记拟声词。在这种情况下,拟声词不包含在标记内:转录拟声词,然后在其后加上此标记。例如:“[…] y de repente, el libro hizo pum, [ONOMAT] y se cayó”。
- Respiración ([RESPIR]).
- Otras ([OTRAS-EM]): 用于表示受访者用于思考接下来要说什么的任何发射。在口头语言中,我们经常这样做:“Y mi hijo, pues, e…/a…/mm, estudió medicina”等。这不转录,而是使用此标记:“Y mi hijo, pues [OTRAS-EM] estudió medicina”。不要将“e”或“a”延长与感叹词“eh”和“ah”混淆,因为后者确实需要转录,而不需要标记:“Mi hijo estudió medicina, eh”。
同时说话 (HS:E/I:)
通常情况下,受访者和采访者会“重叠”,同时说话。对于这些情况,我们使用此标记。它指示谁打断了主要话语(无论是受访者还是采访者)。
交叉对话 (HCruz)
有时,新的成员会出现在对话中。例如,一次采访有一个受访者和两个采访者。他们正在交谈,突然,受访者的亲属出现,受访者不再与采访者交谈,而是与他交谈。这就是交叉对话。为了标记这一点,我们需要选择构成交叉对话的每个干预,并点击该图标。我们也可以插入“交叉对话”标记,并在其中写入每个片段。
去歧义
任何可能因方言发音而混淆的单词都应去歧义。方言变体首先转录,然后是标准形式,根据约定(x=y),(方言形式=标准形式)。当方言形式涉及缩减时,可以使用(0=y)。例如,canta(0=r)lo,但应注意,如果缩减形式涉及重音变化,则不正确。例如,cárce(0=l) o cantá(0=r)lo,不是正确的等效,因为编辑后的结果将是cárce o cantálo。
数据集来源
230次审查的访谈可以从COSER网站(https://corpusrural.fe.uam.es/coser/descargas.php)下载,点击2022年5月版本的链接。文件为XML格式,区分两个父节点:头部和访谈。在头部,我们有关于访谈的数据:省、飞地、访谈日期、访谈持续时间、受访者数据(无姓名)、采访者姓名、进行转录的人员以及访谈中讨论的主题。
在访谈部分,我们有轮次,其属性为id(标记轮次编号)和mp3(轮次持续时间)。轮次的第一个子节点始终是该轮次说话人的引用,可以是受访者(I)或采访者(E)。轮次的其余子节点是单词(w)、标点符号(punct)、专有名词(NP - 匿名)、语言标记,如发射、不可理解或“lit”(可能是谚语、流行语、诗句等的再现)。
数据收集和处理
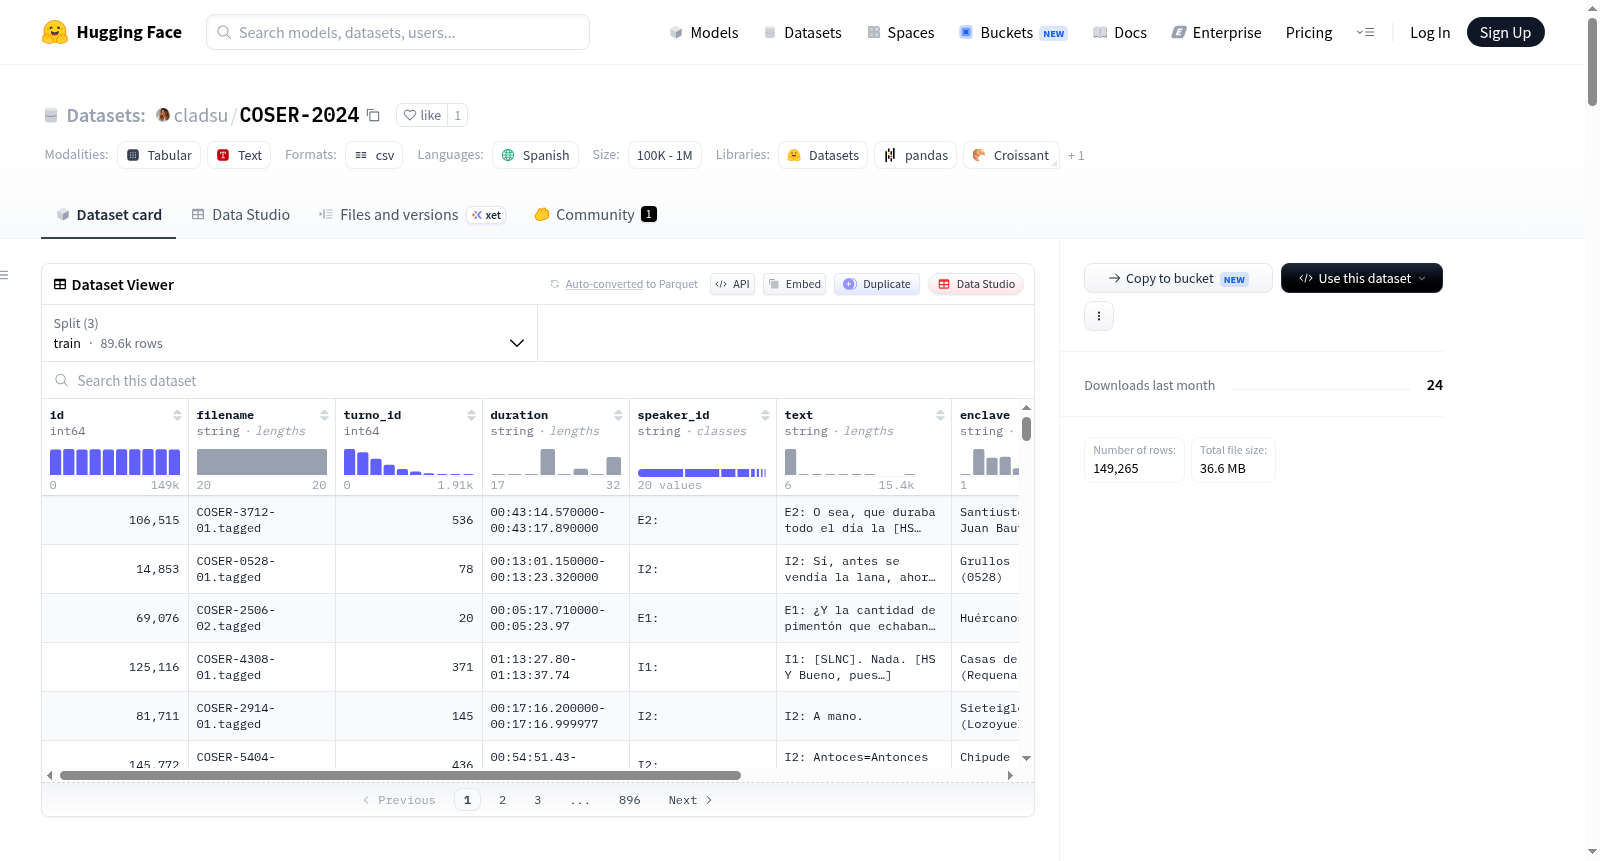
为了生成可操作和可访问的数据库以进行NLP任务,从XML格式的文件中转换为csv格式,以收集所有信息。为此,使用了xml.etree、pandas、BeautifulSoup4和RegEx库。使用xml.etree访问文件路径并解析以访问数据。然后,使用BeautifulSoup读取xml文件内容以提取轮次属性和每个轮次中的文本。使用pandas生成一个数据框,在其中添加数据。
由于文本显示特殊字符和换行符、制表符或不适当的空间;已清理文件,访问csv并应用相应的正则表达式以获得可访问的数据集。