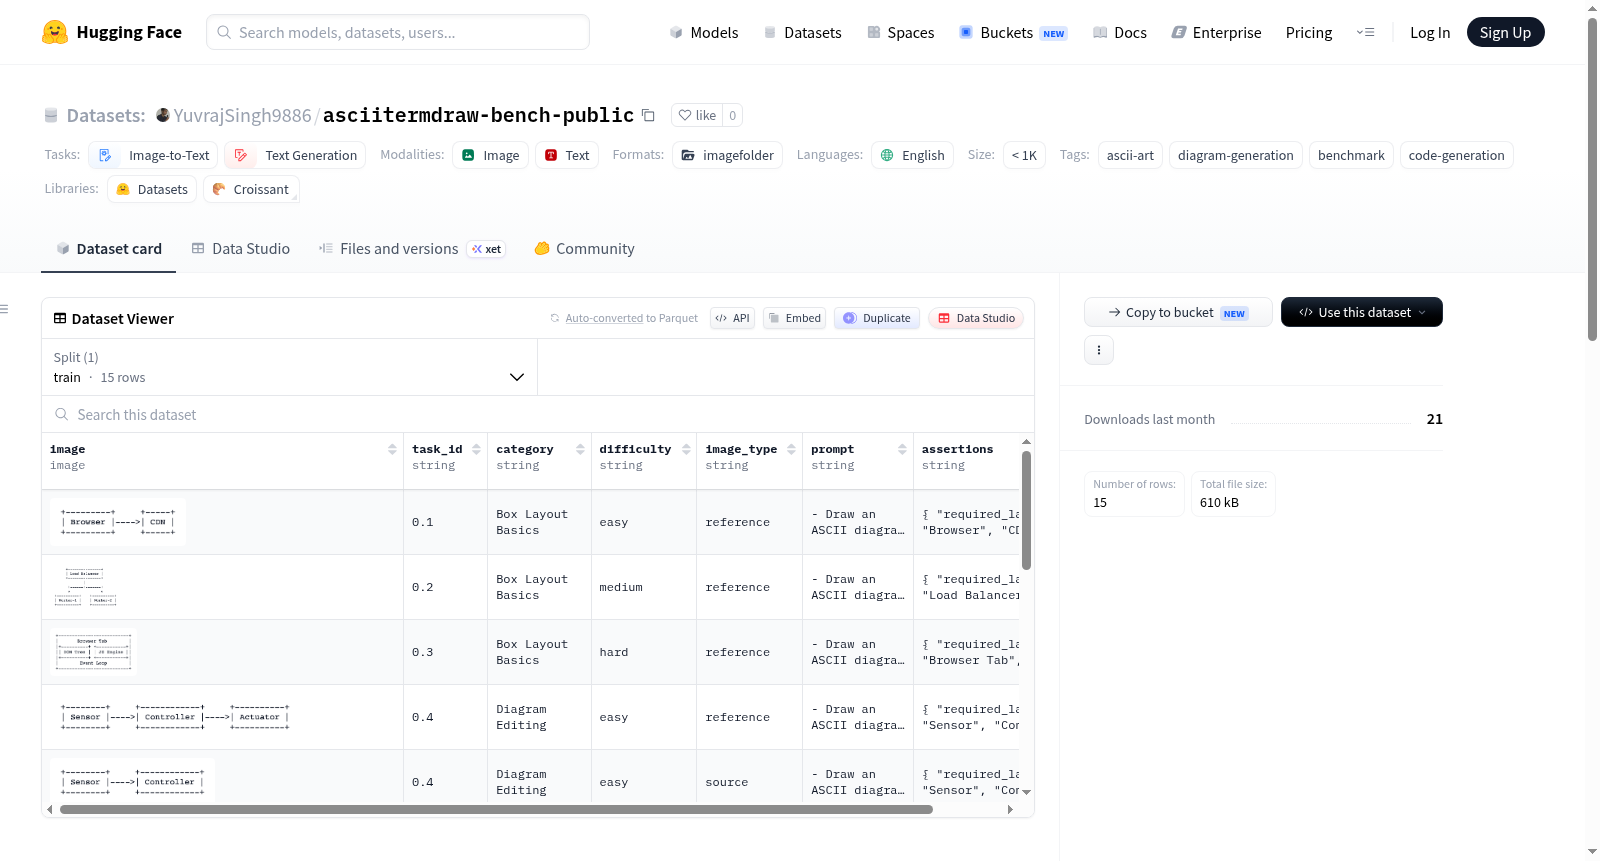
asciitermdraw-bench-public
收藏资源简介:
ASCIITermDraw-Bench Public Examples 是 ASCIITermDraw-Bench 基准测试的公共示例数据集,旨在评估语言模型生成和编辑结构化 ASCII 图表的能力。该数据集包含 12 个手动编写的示例任务,覆盖四个主要类别:基础方框布局与 ASCII 布局、网络与系统拓扑图、图像条件编辑任务(输入源图,输出编辑后的图)以及软件架构草图。每个类别包含易、中、难三个难度级别。每个任务由多个文件构成:prompt.txt(发送给测试模型的指令)、assertions.json(真实结构要求,如标签、实体数量、边和边标签)、reference.ascii(标准 ASCII 图表)、reference.png(reference.ascii 的渲染图像),对于图表编辑任务还包括 source.ascii 和 source.png(编辑前的图表),以及 vlm_judge_prompt.txt(发送给 LLM 评判的精确提示模板)。数据集以文件形式组织,目录结构为 <类别>/<难度>/<任务ID>/,任务 ID 为 0.1 至 0.12,与基准测试工具脚本兼容,可用于演示和运行评分流程,但不参与官方评分。数据规模为 12 个任务,包含文本(ASCII、指令)、JSON 和图像(PNG)模态。适用任务包括图像到文本和文本生成,特别是 ASCII 图表生成与编辑的基准测试。数据集许可证尚未明确,需视为保留所有权利。
ASCIITermDraw-Bench Public Examples is a public example dataset for the ASCIITermDraw-Bench benchmark, designed to evaluate the ability of language models to generate and edit structured ASCII diagrams. It contains 12 manually crafted example tasks covering four main categories: Basic Box Layout and ASCII Layout, Network and System Topology Diagrams, Image-Conditioned Editing Tasks (input source diagram, output edited diagram), and Software Architecture Sketches. Each category includes three difficulty levels: easy, medium, and hard. Each task consists of multiple files: prompt.txt (instructions sent to the tested model), assertions.json (ground truth structural requirements such as labels, entity counts, edges, and edge labels), reference.ascii (standard ASCII diagram), reference.png (rendered image of reference.ascii), and for diagram editing tasks, source.ascii and source.png (pre-edited diagrams), as well as vlm_judge_prompt.txt (precise prompt template for LLM evaluation). The dataset is organized in a file-based structure with a directory format of <category>/<difficulty>/<taskID>/, where task IDs range from 0.1 to 0.12, compatible with benchmark tool scripts for demonstration and scoring processes, but not used in official scoring. The data scale is 12 tasks, incorporating modalities such as text (ASCII, instructions), JSON, and images (PNG). Applicable tasks include image-to-text and text generation, specifically benchmark testing for ASCII diagram generation and editing. The dataset license is not explicitly defined and should be treated as all rights reserved.
数据集概述
ASCIITermDraw-Bench Public Examples 是一个用于评估语言模型生成和编辑结构化 ASCII 图表能力的基准测试数据集。该数据集包含 12 个公开的示例任务,是完整基准测试(80 个私有任务)的独立子集。这些示例任务与完整基准测试采用完全相同的格式,旨在让用户了解任务样式并运行评分流程,而无需访问私有任务集。
任务类别
数据集包含四个类别,每个类别包含三个难度等级(easy、medium、hard)的任务:
- box-layout-basics:方框绘制与 ASCII 布局基础。
- network-topology-diagrams:网络、系统和集群拓扑图。
- diagram-editing:图像条件下的编辑任务(输入源图,输出编辑后的图)。
- software-architecture-diagrams:典型的软件架构草图。
数据格式与文件结构
每个任务的文件结构如下:
<category>/<difficulty>/<task_id>/ prompt.txt # 发送给被测试模型的指令 assertions.json # 结构真实性的基本要求(标签、实体数量、边、边标签) reference.ascii # 黄金标准的 ASCII 图表 reference.png # reference.ascii 渲染成的图片 source.ascii/.png # 仅 diagram-editing 任务:编辑前的图表 vlm_judge_prompt.txt # 发送给 LLM 评判器的确切提示模板
任务 ID 为 0.1 到 0.12,与基准测试工具的布局一致,可直接作为 --tasks 目标用于该仓库的生成/评判脚本。
任务规模与用途
- 总任务数:12 个公开示例任务。
- 任务用途:这些任务不属于基准测试的官方评分,仅作为文档和演示数据。
- 完整基准测试:包含 80 个私有任务,用于实际评分,未公开发布。
语言与标签
- 语言:英文(en)。
- 任务类型:image-to-text、text-generation。
- 标签:ascii-art、diagram-generation、benchmark、code-generation。
许可证
当前源仓库尚未添加许可证,在仓库所有者添加明确许可证之前,应视为保留所有权利(all-rights-reserved)。
相关资源