
遇见数据集

UngLong/openm3chest-labels-v2

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

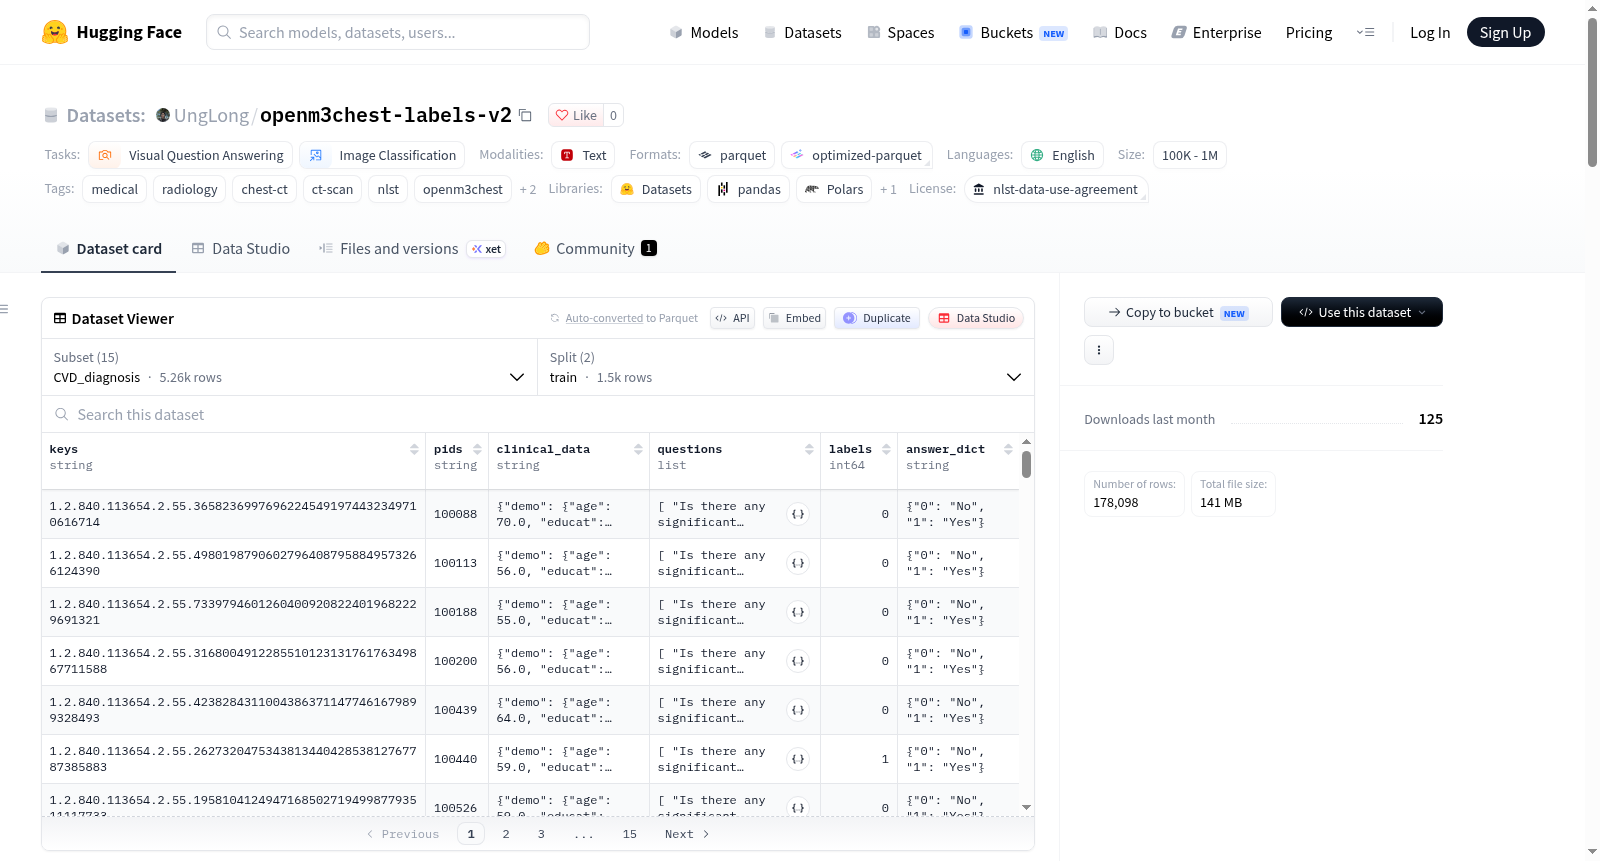
OpenM3Chest Labels v2是一个用于医疗人工智能的数据集,专门设计用于对MedGemma 1.5-4B-IT模型进行LoRA微调。该数据集基于OpenM3Chest项目,源自美国国家肺癌筛查试验(NLST),包含胸部CT扫描图像的标签子集,并覆盖多个医疗任务领域:放射学(如胸部异常检测、结节存在、位置、衰减、边缘和大小分类)、心脏病学(如心血管疾病诊断和死亡率预测)以及肿瘤学(如肺癌风险预测)。数据集提供分层采样,训练集针对二进制任务保持约50/50的平衡,并覆盖所有分类类别;测试集则使用完整的原始测试集以进行准确评估。每个配置(如chest_abn_54、CVD_diagnosis、lung_cancer_risk)对应一个特定任务,包含训练和测试分割,记录字段包括键(SeriesInstanceUID)、患者ID、临床数据(JSON格式)、问题列表、标签(整数或字符串)和答案字典(JSON格式)。CT扫描图像以NPY格式存储在另一个仓库中,可通过患者ID和键映射加载。数据集支持顺序推理,特别是在放射学任务中,首先进行筛查,然后根据结节存在结果进行进一步分析。数据来源包括OpenM3Chest和IDC(成像数据共享平台),旨在促进医疗影像和临床数据的多任务学习研究。

OpenM3Chest Labels v2 is a dataset for medical AI, specifically designed for LoRA fine-tuning of the MedGemma 1.5-4B-IT model. It is based on the OpenM3Chest project, derived from the National Lung Screening Trial (NLST), and contains a labeled subset of chest CT scan images covering multiple medical task domains: radiology (e.g., chest abnormality detection, nodule presence, location, attenuation, margin, and size classification), cardiology (e.g., CVD diagnosis and mortality prediction), and oncology (e.g., lung cancer risk prediction). The dataset provides stratified sampling, with the training set maintaining a ~50/50 balance for binary tasks and covering all categorical classes; the test set uses the full original test set for proper evaluation. Each configuration (e.g., chest_abn_54, CVD_diagnosis, lung_cancer_risk) corresponds to a specific task and includes train and test splits, with record fields such as keys (SeriesInstanceUID), patient IDs, clinical data (JSON-serialized), a list of questions, labels (integer or string), and an answer dictionary (JSON-serialized). CT scan images are stored in NPY format in a separate repository and can be loaded via patient ID and key mapping. The dataset supports sequential inference, particularly for radiology tasks, where screening is performed first, followed by further analysis based on nodule presence results. Data sources include OpenM3Chest and the Imaging Data Commons (IDC), aiming to facilitate multi-task learning research in medical imaging and clinical data.
提供机构:
UngLong
搜集汇总
数据集介绍
UngLong/openm3chest-labels-v2 数据集图片
构建方式
该数据集衍生于以NLST胸部CT影像及临床标注为基础的OpenM3Chest项目,其构建遵循分层抽样策略以适配参数高效微调场景。具体而言,影像学任务每项约抽取350例训练样本,心脏病学任务每项抽取1500例,肿瘤学任务抽取2000例,二分类任务保持约50比50的类别比例,多分类任务则确保覆盖全部类别。测试集保留原始完整划分,不作任何过滤,以保障评估的完整性。每条记录涵盖SeriesInstanceUID、患者标识、临床信息、候选问题集、标签及标签到答案文本的映射字典,CT影像则以NPY格式独立存储,通过标识字段与标签记录相互关联。
特点
该数据集在任务架构上覆盖影像学、心脏病学与肿瘤学三大临床维度,囊括胸部异常筛查、结节属性判定、心血管疾病诊断与死亡风险预测以及肺癌风险分层等十五项配置。标签形式灵活,既包含二分类与多分类整数编码,也支持以JSON字符串表达的六年纵向癌症发生序列,兼顾横截面判断与时间维度建模。数据结构融入临床信息与候选问题字段,便于视觉问答与图像分类任务的联合建模。训练集经分层采样而测试集保持原始分布,折射出对模型泛化能力评估的严谨考量。
使用方法
研究者可借助HuggingFace数据集加载接口按配置名称获取所需任务数据,例如载入胸部异常检测或心血管诊断配置后直接读取训练与测试划分。影像文件需经由huggingface_hub下载对应NPY体数据,路径由患者标识与序列标识组合而成,加载后得到三维体积数组。对于肺癌风险任务,须解析标签字符串中的布尔标志与年度序列。影像学推理遵循序贯范式:先执行筛查任务判断结节有无,仅在存在结节时进一步调用位置、衰减、边缘与尺寸等属性判定任务,从而与训练数据的池化设计保持一致。
背景与挑战
背景概述
近年来,多模态医学人工智能在胸部CT影像分析领域持续升温,而公开基准数据的匮乏成为制约可复现研究的关键瓶颈。OpenM3Chest Labels v2 正是在此背景下应运而生,其数据源于美国国家肺癌筛查试验(NLST)这一标志性队列,由研究团队构建为OpenM3Chest生态的标注子集,专为MedGemma 1.5-4B-IT模型的LoRA微调提供分层监督信号。该数据集覆盖放射学、心脏病学与肿瘤学三大临床维度,系统整合了胸部异常、肺结节属性、心血管疾病诊断与死亡风险以及肺癌风险等任务,为视觉问答与影像分类的统一建模提供了规范化平台。
当前挑战
该数据集所面对的挑战具有鲜明的多层面特征。从领域问题来看,胸部CT的视觉问答要求模型在三维容积中精准识别细微病灶,并融合临床文本信息进行风险分层,其难度远超常规二维图像分类,同时肺结节属性评估、心血管事件预测与肺癌时序风险建模均存在显著的类间不平衡与标注主观性。从构建过程来看,NLST来源的影像需严格遵循数据使用协议,患者隐私保护与多中心扫描协议差异带来异质性,标注任务需兼顾放射科、心内科与肿瘤科的专业共识,而分层采样在保证训练集类别均衡的同时,也需维持测试集对真实分布的完整覆盖,这些因素共同构成了数据集构建与后续模型泛化评估的核心挑战。
常用场景
经典使用场景
在医学影像与临床文本联合建模的领域中,胸部CT扫描与结构化临床信息的融合分析长期被视为多模态推理的试金石。OpenM3Chest Labels v2 正是在这一脉络下构建的基准数据集,其经典用法集中于对MedGemma 1.5-4B-IT等医学视觉语言模型进行LoRA微调。通过涵盖放射学、心脏病学与肿瘤学三类任务配置,该数据集支持视觉问答与图像分类两种范式,模型需同时理解CT容积影像、临床数据JSON以及候选问题列表,进而输出二分类或序数分类标签。其任务设计遵循临床筛查逻辑,例如放射学子集采用序贯推理——先判断是否存在结节,再定位、评估衰减、边缘与尺寸,模拟了真实阅片流程,使模型训练更贴近临床决策路径。
实际应用
在实际临床与科研场景中,OpenM3Chest Labels v2 发挥着多重作用。于放射科辅助诊断而言,基于该数据集微调的模型可用于胸部CT的自动化筛查,识别肺结节并评估其位置、衰减、边缘与尺寸,辅助放射科医师优先处理高风险病例。在心脏病学领域,CVD诊断与死亡风险预测配置可支持心血管疾病的早期预警与分层管理。肿瘤学中的肺癌风险配置则提供了六年逐年序贯标签,使模型能够预测个体在未来若干年内的患癌概率,为肺癌筛查计划的个性化制定提供量化参考。此外,该数据集与NLST影像数据及IDC平台对接,为大规模回顾性研究提供了可扩展的数据基础,具备向真实世界临床工作流嵌入的潜力。
衍生相关工作
围绕OpenM3Chest Labels v2 已衍生出若干经典工作。其配套的NPY格式影像库UngLong/openm3chest-npy-v2 为模型训练提供了直接的容积数据接口,催生了以MedGemma为基础的医学视觉语言微调实践。基于该数据集的序贯推理协议,研究者进一步探索了分阶段决策模型在胸部CT筛查中的有效性。在方法学层面,该数据集的分层采样与全量测试集评测设计,为医学多模态基准的构建提供了可借鉴的范式。由NLST与IDC生态延伸,该数据集亦促进了跨机构、跨队列的泛化性研究,推动了对医学视觉语言模型鲁棒性与公平性的系统评估。这些衍生工作共同丰富了胸部CT多模态学习的研究版图。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

