
OpenR1-DeepSeek-R1-Distill-Qwen-7BBlockwiseCompressedReasoniong-Level-2-CompressionRate-0.8
收藏数据链接:
官方服务:
资源简介:
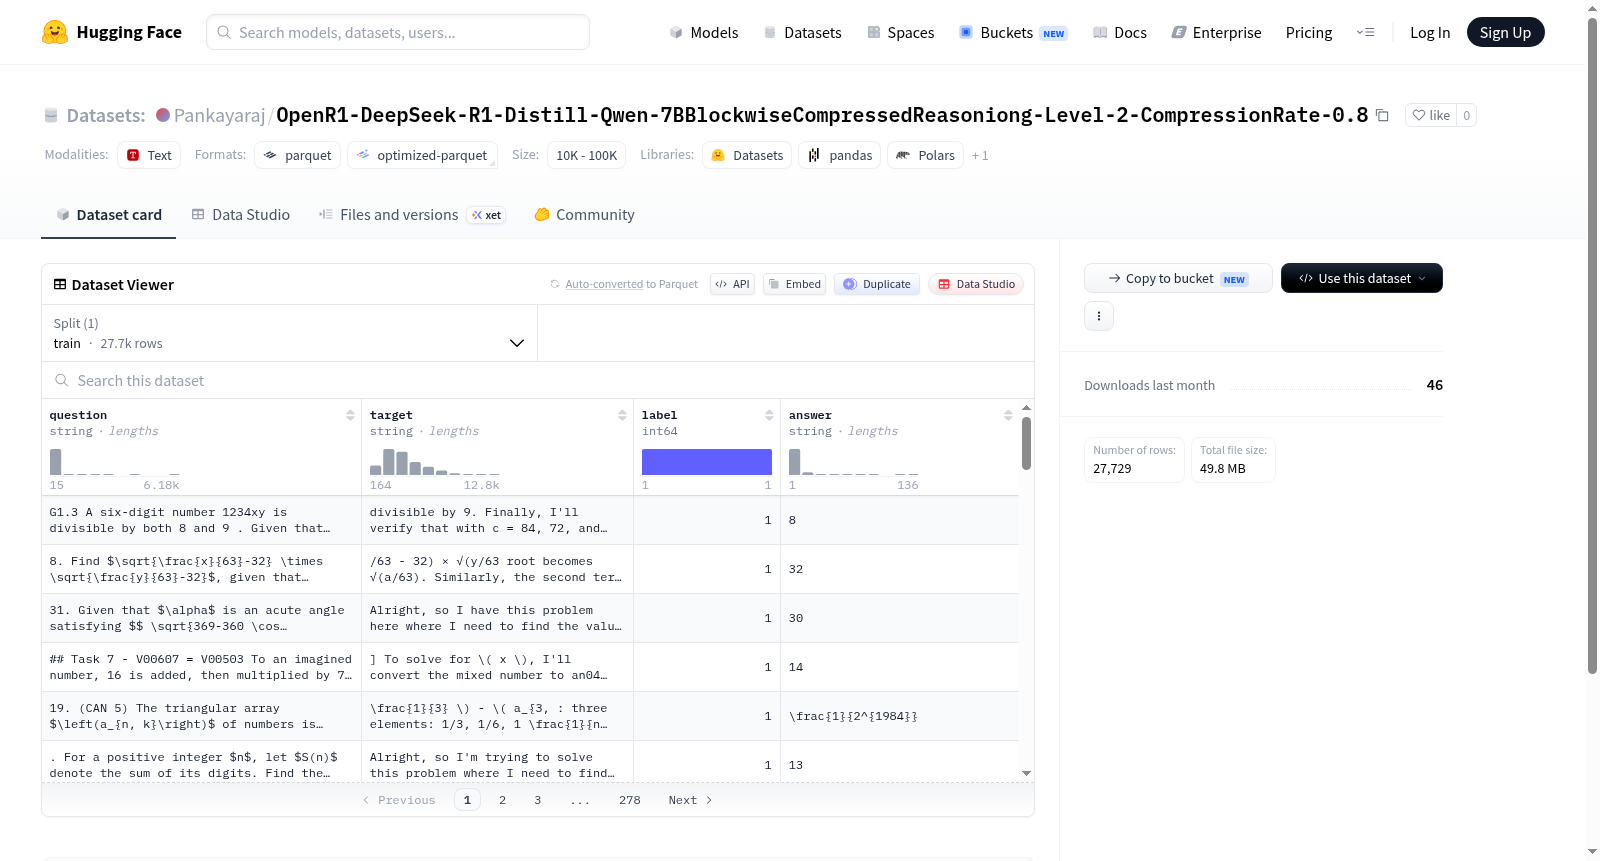
该数据集包含训练集,共27729个样本。每个样本包含四个字段:question(问题,字符串类型)、target(目标,字符串类型)、label(标签,整数类型)、answer(答案,字符串类型)。数据集大小约为103MB。
The dataset contains a training set with 27,729 samples. Each sample includes four fields: question (string type), target (string type), label (integer type), and answer (string type). The dataset size is approximately 103 MB.
创建时间:
2026-08-08
原始信息汇总
数据集概述
该数据集名为 OpenR1-DeepSeek-R1-Distill-Qwen-7BBlockwiseCompressedReasoniong-Level-2-CompressionRate-0.8,托管在 Hugging Face 平台上,主要用于存储经过分块压缩处理的推理相关数据。
数据特征
每条数据包含以下四个字段:
- question:字符串类型,表示问题内容。
- target:字符串类型,表示目标输出或标准答案。
- label:整数类型,用于标注样本类别或标签。
- answer:字符串类型,表示实际生成的答案或推理结果。
数据集划分
该数据集仅包含一个训练集(train),具体信息如下:
- 训练集样本数:27,729 条
- 训练集大小:103,833,019 字节(约 99 MB)
文件与大小
- 下载大小:49,778,073 字节(约 47.5 MB)
- 数据集总大小:103,833,019 字节(约 99 MB)
- 数据文件路径:
data/train-*(支持分片读取)
配置说明
- 默认配置名称:
default - 数据文件格式:支持通过通配符模式加载多个训练分片文件。
搜集汇总
数据集介绍
构建方式
该数据集源于对DeepSeek-R1-Distill-Qwen-7B模型生成推理轨迹的分块压缩处理,通过设定第二级压缩率0.8,在保留关键推理步骤的基础上,将原始长文本压缩为更紧凑的表示。数据构建过程涉及对模型输出的结构化处理,形成包含问题、目标、标签及最终答案的完整样本对。每个样本由四元组构成,其中`question`字段承载原始查询,`target`记录期望输出,`label`提供类别标识,`answer`存储压缩后的推理结果,从而确保数据的高效性与可追溯性。
使用方法
数据集以HuggingFace格式组织,包含`train`分割,可通过`datasets`库直接加载,例如使用`load_dataset`函数指定数据集名称即可读取。每条样本提供`question`、`target`、`label`和`answer`字段,适用于训练模型从问题映射到压缩答案的任务,也可用于评估模型在给定目标下的推理压缩能力。研究者可依据`label`字段进行类别筛选,或结合`question`与`answer`构建生成任务,以支持针对推理链长度与性能权衡的实验设计。
背景与挑战
背景概述
OpenR1-DeepSeek-R1-Distill-Qwen-7BBlockwiseCompressedReasoniong-Level-2-CompressionRate-0.8数据集诞生于大语言模型推理能力压缩与蒸馏研究的前沿领域,由OpenR1团队于近期构建,旨在探索通过块级压缩技术对DeepSeek-R1蒸馏模型进行高效瘦身的同时保持其推理质量。该数据集包含了约2.7万条问答对,每条样本均附有目标答案与标签,为评估压缩后模型在复杂推理任务上的表现提供了标准化基准。其核心研究问题聚焦于如何在显著降低模型存储与计算开销的前提下,保留原始模型的逻辑推理链条,这一方向对推动边缘计算与实时推理应用具有重要的实践意义,也为后续模型压缩研究树立了可复现的参照系。
当前挑战
该数据集所应对的领域挑战在于,大语言模型虽在推理任务上表现卓越,但其庞大的参数规模与计算需求严重制约了其在资源受限场景中的部署。块级压缩虽能有效缩减模型体积,却极易引发推理精度下滑,尤其是对于多步逻辑推导的蒸馏模型,如何在压缩率高达0.8的情况下维持答案的准确性与连贯性,是构建过程中的核心难点。此外,数据集构建需确保压缩前后模型输出的一致性与语义等价性,这要求对训练样本进行精细筛选与对齐,而存储格式的简化(仅保留question、target、label、answer字段)进一步提升了标注与清洗的复杂度,开发者不得不权衡指令多样性、覆盖广度与数据纯度,以确保评测结果能够真实反映压缩模型的泛化能力。
常用场景
经典使用场景
在自然语言处理与推理模型研究的交汇点上,OpenR1-DeepSeek-R1-Distill-Qwen-7BBlockwiseCompressedReasoniong-Level-2-CompressionRate-0.8数据集以其独特的块级压缩推理特征,成为探究模型在有限信息条件下推理能力的经典基准。该数据集包含27,729条训练样本,每条数据由问题、目标、标签及答案构成,特别适用于训练和评估语言模型在压缩文本上的推理表现。研究常见于知识蒸馏场景,通过将高容量教师模型的推理模式压缩至轻量级学生模型,检验参数效率与性能保持的平衡。其经典用法涵盖压缩推理任务的少样本学习、零样本泛化测试,以及针对压缩伪影的鲁棒性分析,为构建信息密集型环境下的智能推理系统提供了标准化的数据支撑。
解决学术问题
该数据集直面信息冗余与推理效率之间的根本矛盾,为学术界长期关注的‘如何在信息不完整时保持推理正确性’这一核心问题提供了可控的实验场域。通过设定0.8的压缩率,它系统性地模拟了现实通信或存储限制下的信息丢失场景,使研究者能够量化压缩程度对推理质量的影响,进而探索面向压缩文本的语义保持与推理稳健性策略。这一设计填补了传统推理数据集多基于完整、冗余文本的空白,推动了高效推理、语义压缩与模型鲁棒性等交叉方向的理论进展。其意义在于,不仅为压缩感知的推理模型评测树立了新标杆,还促进了从过度参数化向轻量化、实用化模型过渡的学术思考。
实际应用
在实际应用层面,该数据集深刻映射了边缘计算、低带宽通信及实时决策等场景下的迫切需求,如移动设备上的智能助手、物联网节点间的协同推理、以及远程电信中的实时语言理解。它助力开发者在保持可接受准确率的同时,显著降低模型推理的内存占用与传输开销,从而在资源受限的硬件上部署高性能语言模型。在工业级对话系统、自动摘要工具及嵌入式知识库查询中,基于该数据集训练的模型能有效应对信息片段化或压缩输入,提升服务响应的及时性与可靠性。此外,其还可用于优化API接口的数据传输协议,减少云端与终端间的数据负荷,是推动高效、经济、普适AI服务落地的重要资源。
数据集最近研究
最新研究方向
该数据集聚焦于大语言模型推理链的压缩与知识蒸馏前沿探索,通过块级压缩技术对DeepSeek-R1-Distill-Qwen-7B的推理过程进行高效精简,压缩率达0.8,在保持任务性能的同时显著降低计算与存储开销。其研究导向直指模型轻量化与边缘部署的迫切需求,为推理成本敏感型应用提供新范式。该数据集包含近2.8万条训练样本,覆盖问题、目标、标签及答案字段,为评估压缩后模型的推理质量与泛化能力提供了标准化基准,推动可解释性与高效推理的融合,对实时智能系统及资源受限环境下的AI落地具有深远影响。
以上内容由遇见数据集搜集并总结生成


