
AI4AI-Bench
收藏资源简介:
AI4AI-Bench是一个由清华大学Navers实验室和Einsia.AI共同构建的基准测试,旨在评估大语言模型智能体在算法设计层面的递归自我改进能力。该基准包含10个冻结的研究仓库,覆盖监督微调、多轮强化学习、策略蒸馏、奖励建模、偏好优化、扩散强化学习、机器遗忘、图扩散、权重平均和一次性剪枝等十种训练算法家族,每个仓库均配备固定的评估指标。数据集创建过程通过冻结每个仓库的原始算法、初始模型和评估逻辑,为智能体提供4小时开发窗口和最多12小时的验证窗口,以分离探索与评估。该基准旨在解决现有基准无法衡量智能体是否真正改进训练算法(而非仅调参或数据工程)的问题,为递归自我改进研究提供标准化测试平台。
AI4AI-Bench is a benchmark jointly constructed by Navers Laboratory of Tsinghua University and Einsia.AI, aiming to evaluate the recursive self-improvement capabilities of Large Language Model (LLM)-powered AI Agents at the algorithm design level. This benchmark comprises 10 frozen research repositories spanning ten training algorithm families: supervised fine-tuning, multi-turn reinforcement learning, policy distillation, reward modeling, preference optimization, diffusion reinforcement learning, machine unlearning, graph diffusion, weight averaging, and one-shot pruning. Each repository is equipped with fixed evaluation metrics. During the dataset construction process, the original algorithms, initial models and evaluation logic of each repository are frozen, providing AI Agents with a 4-hour development window and a maximum 12-hour verification window to separate exploration and evaluation phases. This benchmark addresses the gap that existing benchmarks cannot measure whether AI Agents truly improve training algorithms (rather than merely tuning hyperparameters or performing data engineering), and provides a standardized testbed for recursive self-improvement research.
数据集概述
AI4AI-Bench 是一个用于评估 LLM 智能体在算法设计方面能力的数据集,聚焦于“AI 改进 AI”的递归自我改进场景。其核心问题是:编码智能体能否改进 AI 项目已有的训练方法?
任务设计
- 10 个冻结的研究项目:每个任务对应一个真实的研究代码库(论文作者实际运行的代码),智能体获得代码库和起始模型,并收到一条指令:改进该项目已有的结果。
- 任务覆盖:涵盖监督微调(OpenR1)、多轮智能体 RL(RAGEN)、在线策略蒸馏(OPD)、Bradley-Terry 奖励建模(BTRM)、偏好优化(DPO)、扩散 RL(DDPO)、机器遗忘(NPO)、离散图扩散(DiGress)、权重平均(Model Soup)、一次性剪枝(OWL)等 10 个不同方向,避免单一技巧通吃。
评估机制
- 两阶段分离:智能体在 4 小时内重写代码并进行短实验,随后在一个其无法访问的密封容器中执行完整的训练运行(最长 12 小时),最后通过智能体未见过的测试数据打分。
- 统一 0-1 评分轴:三个固定锚点——0(一无所知)、0.1(原始代码的表现)、1.0(完美解决)。分数表示在 0.1 基础上对剩余差距的闭合程度;无法运行的提交得 0 分。
关键发现
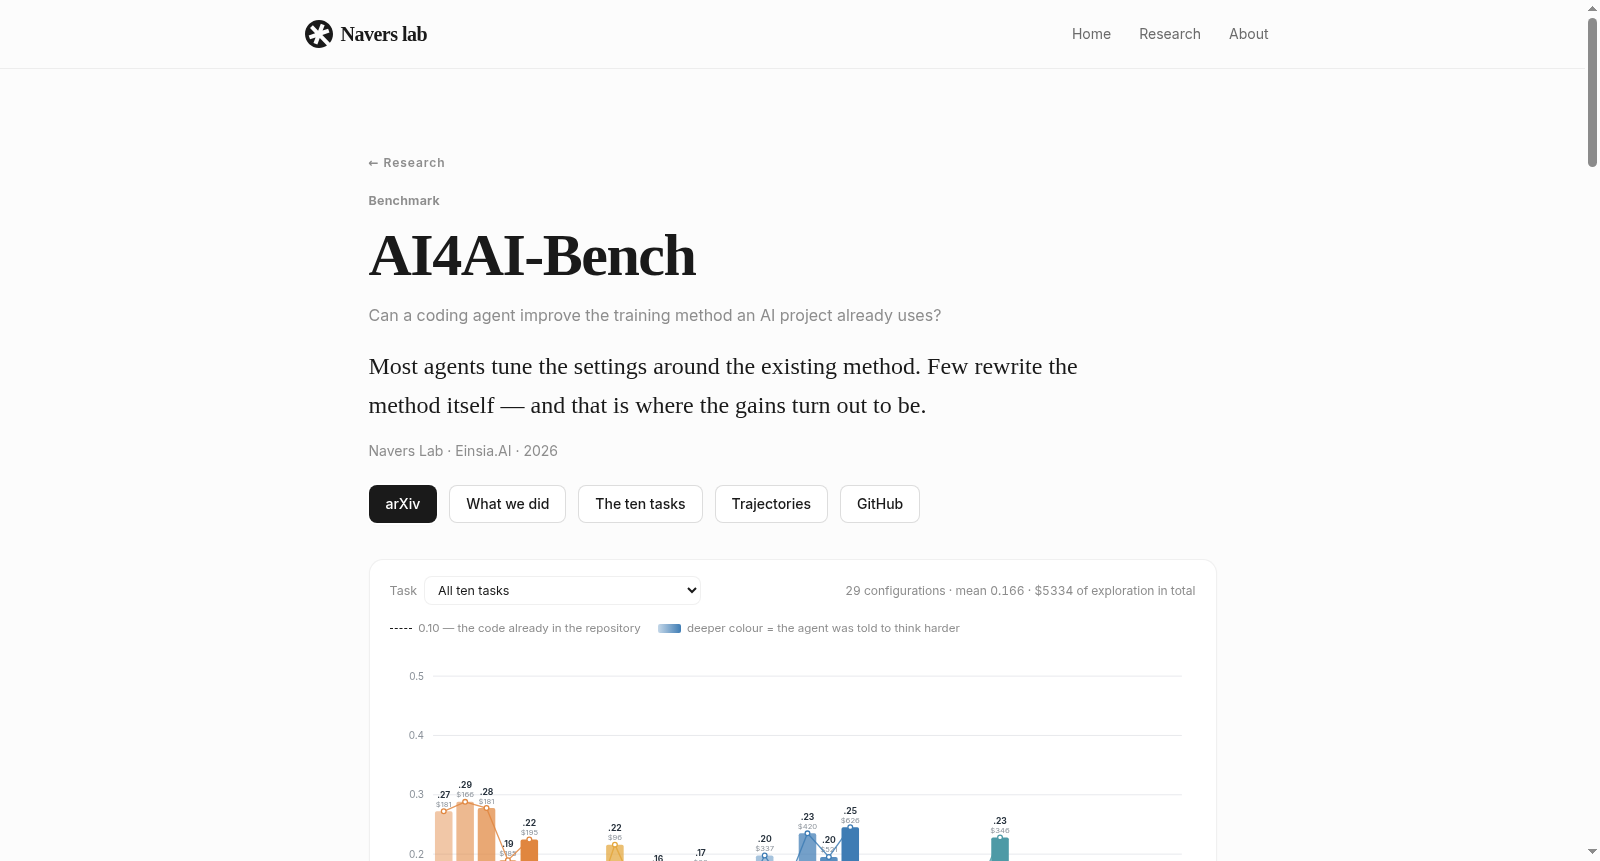
- 总体表现:290 次运行平均得分 0.166,仅略高于仓库自带代码(0.10)。124 次运行中,重写结果比原代码更差。
- 模型对比:Claude Opus 5 领先(平均 0.250),GPT-5.6 Luna 最低(0.117)。总计探索成本 5334 美元,单个配置成本从 4 美元到 626 美元不等,且最贵的并非最好。
- 改动类型分析:263 次有效提交中,54% 仅调整运行参数(学习率、批次大小等),平均得分 0.126;46% 改变了模型学习方式(目标函数、更新规则、数据等),平均得分 0.226——后者得分接近前者的两倍。
- 推理强度影响:提高推理强度使智能体更敢于尝试改变学习方法(比例从 8% 升至 64%),但平均得分仅从 0.094 提升至 0.196,且没有智能体随推理强度提升而持续改进。
引用信息
@article{chi2026ai4ai, title = {AI4AI-Bench: Benchmarking LLM Agents in Algorithmic Design for Recursive Self-Improvement}, author = {Yizhe Chi and Wenyi Li and Deyao Hong and Xiaoqiu Wang and Mingju Gao and Kaisen Yang and Bingxiang He and Youjie Zheng and Calvin Xiao and Qinhuai Na}, journal = {arXiv preprint arXiv:2608.20318}, year = {2026} }
相关链接
- GitHub: https://github.com/(数据集页面未给出具体地址,请参见原始页面)
- arXiv: 数据集页面标注有 arXiv 链接,具体地址请访问原文页面获取
- 1AI4AI-Bench: Benchmarking LLM Agents in Algorithmic Design for Recursive Self-Improvement清华大学·Navers实验室; Einsia.AI · 2026年


