
Gregor/mblip-train
收藏官方服务:
资源简介:
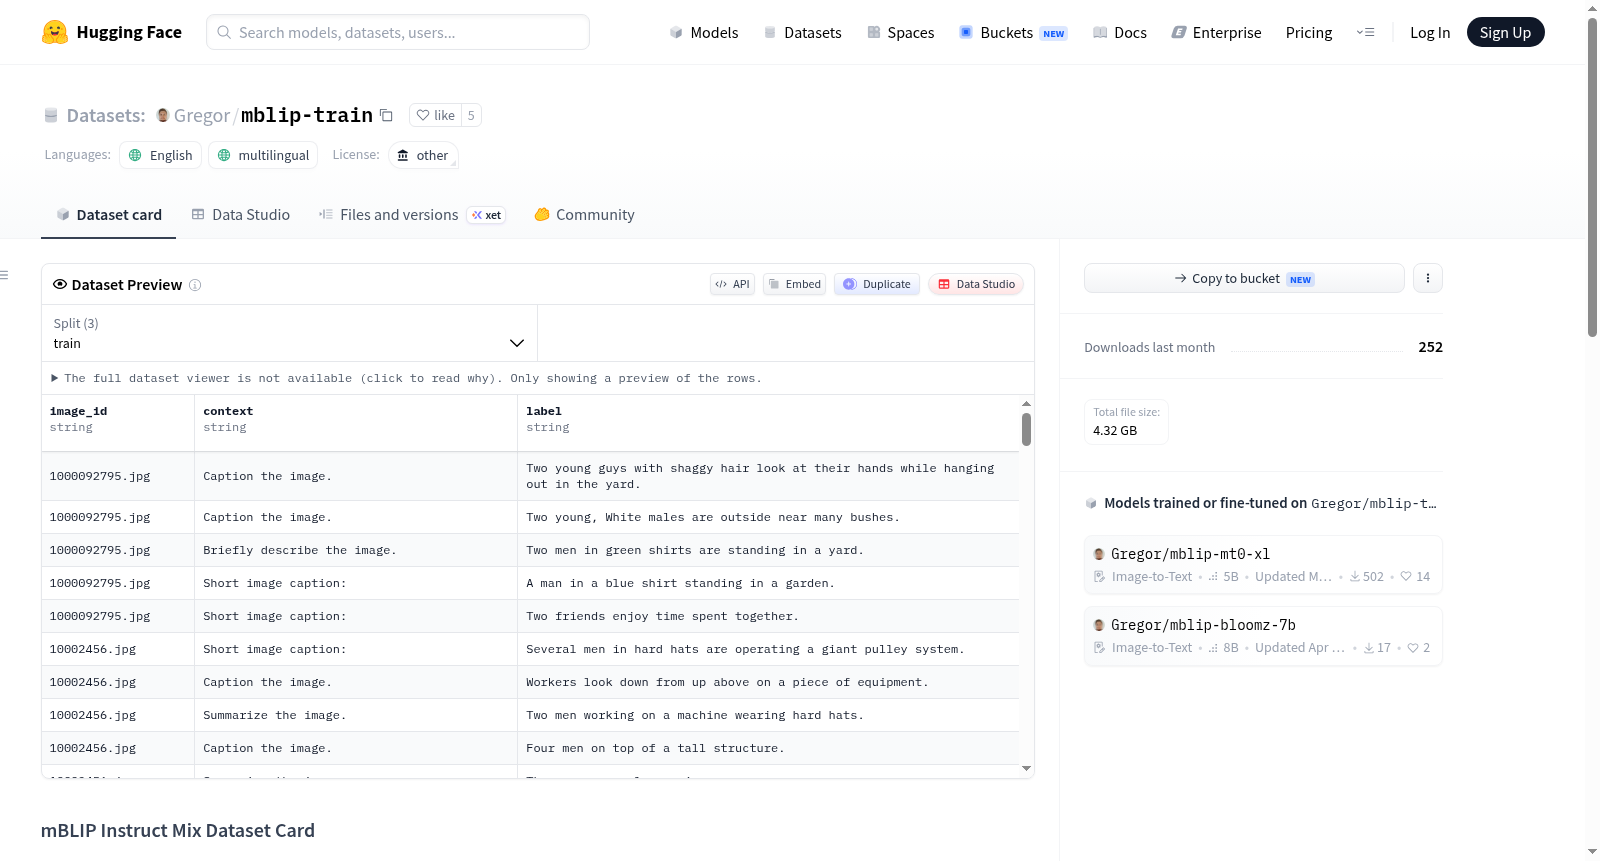
mBLIP Instruct Mix数据集是用于训练mBLIP模型的指令混合数据集,包含95种语言的机器翻译数据,翻译比例与mC4数据集中的语言比例一致。数据集结构包括一个主JSON文件和多个文件夹,分别包含生成混合数据的任务和用于模型评估的任务文件。数据集不包含图像,但提供了图像下载的链接和文件名。许可证要求遵守原始数据集的许可证以及NLLB翻译模型的许可证。数据集的主要用途是研究大型多语言多模态模型和聊天机器人,主要用户是计算机视觉、自然语言处理、机器学习和人工智能领域的研究人员和爱好者。
mBLIP Instruct Mix数据集是用于训练mBLIP模型的指令混合数据集,包含95种语言的机器翻译数据,翻译比例与mC4数据集中的语言比例一致。数据集结构包括一个主JSON文件和多个文件夹,分别包含生成混合数据的任务和用于模型评估的任务文件。数据集不包含图像,但提供了图像下载的链接和文件名。许可证要求遵守原始数据集的许可证以及NLLB翻译模型的许可证。数据集的主要用途是研究大型多语言多模态模型和聊天机器人,主要用户是计算机视觉、自然语言处理、机器学习和人工智能领域的研究人员和爱好者。
提供机构:
Gregor原始信息汇总
mBLIP Instruct Mix Dataset Summary
Dataset Details
Dataset Type
- Purpose: Instruction mix used to train mBLIP.
- Source: https://github.com/gregor-ge/mBLIP
Dataset Date
- Creation Date: May 2023
Dataset Languages
- Original Languages: English
- Translated Languages: 95 languages, including
af, am, ar, az, be, bg, bn, ca, ceb, cs, cy, da, de, el, en, eo, es, et, eu, fa, fi, fil, fr, ga, gd, gl, gu, ha, hi, ht, hu, hy, id, ig, is, it, iw, ja, jv, ka, kk, km, kn, ko, ku, ky, lb, lo, lt, lv, mg, mi, mk, ml, mn, mr, ms, mt, my, ne, nl, no, ny, pa, pl, ps, pt, ro, ru, sd, si, sk, sl, sm, sn, so, sq, sr, st, su, sv, sw, ta, te, tg, th, tr, uk, ur, uz, vi, xh, yi, yo, zh, zu - Translation Method: Machine translation using NLLB
Dataset Structure
- Files:
task_mix_mt.json: Processed, translated, and combined instruction mix data.- Folders: Contain separate tasks used to generate the mix and files for model evaluation.
Images
- Inclusion: No images included.
- External Sources: Images for training and evaluation can be downloaded from public datasets like MSCOCO.
License
- Compliance: Must comply with the licenses of original datasets and NLLB.
- Details: https://github.com/gregor-ge/mBLIP/data/README.md
Intended Use
- Primary Use: Research on large multilingual multimodal models and chatbots.
- Primary Users: Researchers and hobbyists in computer vision, natural language processing, machine learning, and artificial intelligence.
搜集汇总
数据集介绍
构建方式
在视觉与语言多模态研究的广阔领域中,指令微调数据集的构建质量直接影响模型的泛化能力与跨语言表现。Gregor/mblip-train数据集正是为训练mBLIP模型而精心设计的指令混合数据集,其构建方式体现了系统性的多语言扩展策略。该数据集以英文指令数据为原始基础,利用NLLB翻译模型将其自动转化为涵盖95种语言的多语言版本。翻译比例严格依据mC4语料库中各语言的规模进行加权分配,例如德语占mC4语料6%,则数据集中德语样本亦占6%,从而确保了语言分布的生态效度。数据集以JSON格式提供核心文件task_mix_mt.json,并附带各子任务文件夹,但原始图像需从MSCOCO等公开数据集另行获取,以规避版权与存储限制。
特点
该数据集最显著的特点在于其宏大的多语言覆盖范围与比例平衡策略。它囊括了从非洲语言如阿姆哈拉语到亚洲语言如祖鲁语的95种语言,构建了当前视觉指令微调领域少有的跨语言资源。通过基于mC4语料规模的比例翻译,数据集避免了常见多语言资源中因语言样本不均导致的性能偏差,使得模型能在低资源语言上同样获得有效的训练信号。此外,数据集不直接包含图像,仅提供图像引用信息,这种设计既降低了数据分发的存储压力,又保持了与原始视觉数据集的兼容性,为研究者提供了灵活的数据加载路径。
使用方法
使用该数据集时需注意其加载方式的特殊性。由于数据集无法通过datasets.load_dataset()直接调用,用户应首先从HuggingFace仓库下载所需的数据文件,随后采用datasets.load_dataset('json', data_files='文件名')的方式进行加载。核心训练数据来自task_mix_mt.json文件,而子任务文件夹则可用于进一步的模型评估或消融研究。对于图像数据,需根据提供的URL或文件名从MSCOCO等原始数据集下载,并可参考mBLIP代码仓库中的适配脚本完成图像与指令的配对。研究者在使用时还需遵守原始数据集及NLLB翻译模型的各自许可协议,确保合规性。
背景与挑战
背景概述
在大规模多模态预训练模型领域,语言与视觉的跨模态对齐已成为推动人工智能系统理解复杂世界的关键技术。mBLIP指令混合数据集(Gregor/mblip-train)由Gregor Ge于2023年5月创建,旨在支持多语言视觉语言模型mBLIP的训练。该数据集的核心研究问题是如何在高资源语言(如英语)之外,实现多语言环境下的指令跟随与视觉推理能力。通过将原始英文示例机器翻译至95种语言,并依据mC4语料库的语言规模比例进行采样,数据集为探索多语言多模态模型的泛化边界提供了重要基准。其影响力体现在为低资源语言场景下的视觉对话系统研究铺平了道路,促进了多语言人工智能的公平性与包容性发展。
当前挑战
该数据集面临的挑战首先源自多语言多模态领域的根本性难题:不同语言间视觉概念表达的语义鸿沟与文化差异,导致模型在翻译后的指令中难以保持原始任务的精确性。其次,构建过程中需应对95种语言机器翻译的质量不均问题,尤其是低资源语言的翻译错误可能污染训练数据。此外,数据集不包含原始图像,仅提供URL和文件名,这增加了数据复现的复杂性,用户需从多个来源(如MSCOCO)自行下载并处理图像,不同站点的图像可用性与版权合规性构成潜在障碍。最后,原始数据集(如BLIP字幕)的许可条款与NLLB翻译模型的许可证需同时遵守,多许可证的兼容性管理为实际使用增添了法律与技术层面的双重挑战。
常用场景
经典使用场景
Gregor/mblip-train数据集是为训练多语言多模态视觉语言模型mBLIP而构建的指令微调混合数据集。其经典使用场景在于将英文视觉语言指令数据通过机器翻译扩展至95种语言,覆盖从高资源到低资源的广泛语种,从而支持多语言环境下视觉问答、图像描述生成、视觉推理等任务的模型训练。研究者可基于该数据集中的任务混合文件(如task_mix_mt.json)直接加载多语言指令对,结合MSCOCO等公开图像数据,实现对多模态模型的多语言泛化能力进行系统性的微调与评估。该设计特别适用于跨语言视觉语义理解研究,为低资源语言的多模态任务提供了宝贵的训练资源。
解决学术问题
该数据集核心解决了多语言多模态模型训练中指令数据匮乏与语言覆盖不均的学术难题。此前,视觉语言模型多聚焦于英语,缺乏对非英语语言的系统性支持,导致跨语言视觉理解能力薄弱。通过基于mC4语料库规模按比例翻译指令数据,Gregor/mblip-train确保了语言分布的均衡性,使得模型能够同等学习高资源与低资源语言的视觉语义映射。这一策略有效缓解了多语言多模态研究中的数据偏差问题,为探索语言多样性对视觉推理能力的影响提供了实验基础,推动了多语言视觉语言预训练范式的进步。
衍生相关工作
该数据集衍生了一系列重要工作,最直接的是mBLIP模型本身,它首次将BLIP-2的指令微调能力扩展至95种语言,验证了机器翻译在多语言多模态指令学习中的有效性。后续研究借鉴其数据构建方法,如使用NLLB模型进行指令翻译并保持任务格式一致,催生了多语言视觉语言模型的系列改进工作。此外,该数据集被用于评估多语言视觉语境下的零样本迁移能力,相关实验结论为多模态模型的跨语言泛化理论提供了实证支持。其公开的翻译比例策略也影响了后续多语言数据集的构建标准,成为多语言多模态研究领域的重要参考资源。
以上内容由遇见数据集搜集并总结生成


