
遇见数据集

TIGER-Lab/SWE-QA-Pro-SFT-Trajectories

收藏
Hugging Face2026-06-24 更新2026-07-22 收录
官方服务:

资源简介:

SWE-QA-Pro SFT轨迹数据集是一个用于仓库级问答的代理工具使用轨迹集合,专门设计作为SWE-QA-Pro训练方案中的监督微调数据。该数据集包含1000个多轮交互轨迹,每个轨迹展示了代理如何通过只读工具(包括语义搜索、代码库查看和执行只读命令)探索代码库来回答与代码仓库相关的问题,而不是依赖预记忆的知识。这些轨迹由Claude Sonnet 4.5生成,并以hermes工具调用格式存储,适用于微调开源模型。数据集格式为JSONL,每个条目包含工具定义和多轮对话消息,涵盖系统指令、用户问题、代理规划、工具调用、工具响应以及最终答案。

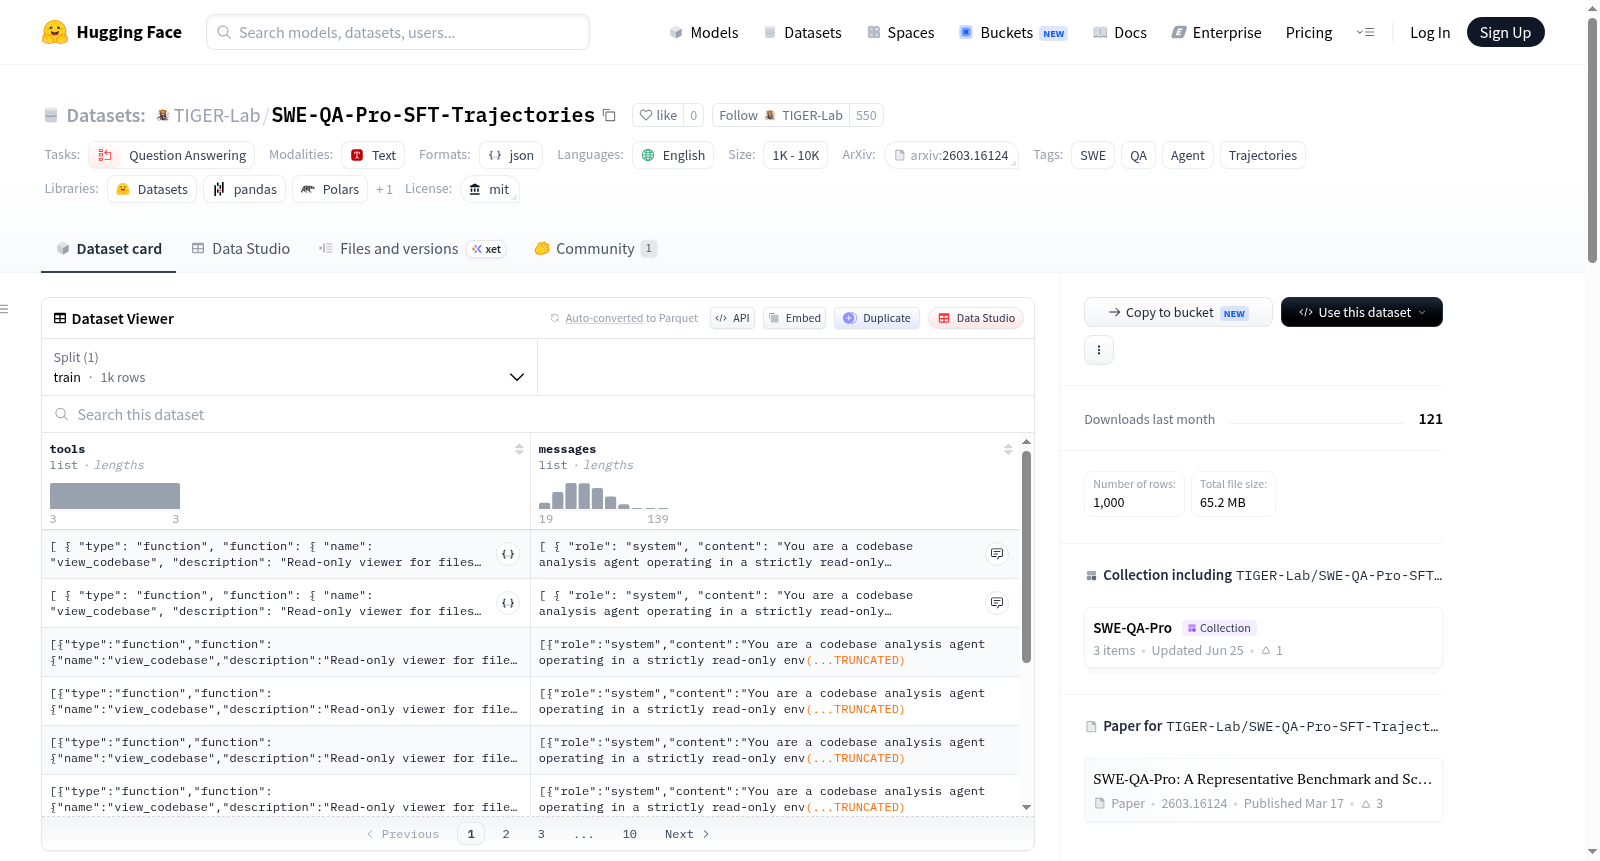
SWE-QA-Pro SFT Trajectories is a set of agentic tool-use trajectories for repository-level question answering, used as the supervised fine-tuning data in the SWE-QA-Pro training recipe. It consists of 1,000 multi-turn trajectories where an agent answers repository-grounded questions by exploring the codebase with read-only tools (semantic_search, view_codebase, execute_readonly_command) rather than relying on memorized knowledge. The trajectories are generated by Claude Sonnet 4.5 and stored in the hermes tool-calling format, ready for fine-tuning open models. The dataset is in JSONL format with each object containing tool definitions and multi-turn conversation messages, including system instructions, user questions, agent planning, tool calls, tool responses, and final answers.
提供机构:
TIGER-Lab
搜集汇总
数据集介绍
TIGER-Lab/SWE-QA-Pro-SFT-Trajectories 数据集图片
构建方式
SWE-QA-Pro-SFT-Trajectories 数据集专为仓库级问答场景下的监督微调(SFT)而构建,旨在训练智能体在只读环境中通过工具调用完成代码库探索与问题解答。数据集中每条样本均为一个多轮交互轨迹,由 Claude Sonnet 4.5 模型生成,并采用 hermes 工具调用格式进行存储。每个轨迹记录了智能体从接收仓库级问题开始,依次调用语义搜索(semantic_search)、代码查看(view_codebase)及只读命令执行(execute_readonly_command)三类工具,逐步获取信息,最终将答案封装于 <finish>…</finish> 标签内的完整过程。该构建方式确保了数据严格基于代码库的静态探索,而非依赖模型记忆,从而提升了微调后模型的泛化能力与可解释性。
特点
该数据集的核心特点在于其面向仓库级代码理解的精细化工具使用轨迹设计。每条轨迹均包含多个轮次的智能体规划与工具调用日志,结构与真实部署场景高度一致,便于模型学习如何在实际代码环境中主动搜索、定位与理解信息。数据集使用 hermes 格式组织,每条记录包含独立的工具定义(tools)与多轮对话消息(messages),其中消息序列依次涵盖系统指令、用户问题、智能体思考过程、工具调用请求、工具返回结果以及最终答案,结构清晰完整。1,000 条轨迹的规模虽小,但质量上乘,特别适合用于对小型或中型开源模型进行高效微调,以提升其在复杂代码库问答任务中的表现。
使用方法
使用该数据集进行微调时,用户可直接通过 Hugging Face Datasets 库加载。调用 load_dataset("TIGER-Lab/SWE-QA-Pro-SFT-Trajectories", split="train") 即可获取训练集,每个样本中的 tools 字段定义了智能体可用的工具函数架构(符合 OpenAI 风格的 schema),messages 字段则为包含多个角色的交互历史列表。研究人员可依据 hermes 工具调用格式解析模型输出并构建损失函数。该数据集作为 SWE-QA-Pro 训练方案的第一阶段监督微调数据,与后续强化学习阶段衔接,用户可参照其官方 GitHub 仓库中的训练脚本(位于 train/SFT/ 目录)进行完整流程复现。
背景与挑战
背景概述
SWE-QA-Pro-SFT-Trajectories数据集由TIGER-AI-Lab于2026年发布,旨在应对仓库级代码理解这一新兴研究领域。随着大语言模型在代码生成与理解任务中的广泛应用,如何使模型具备基于真实代码库进行深度问答的能力成为关键挑战。该数据集通过收集智能体在只读工具(如语义搜索、代码浏览、命令执行)的辅助下,逐步探索代码库并回答问题的多轮轨迹,为监督微调提供了高质量的训练数据。其研究工作依托于Claude Sonnet 4.5生成的1000条轨迹,并以Hermes工具调用格式存储,显著提升了如Qwen3-8B等开放模型的仓库级问答表现。该数据集的提出不仅填补了现有基准在真实代码场景中多步推理能力的评估空白,还为构建更具实用性的代码智能体奠定了数据基础,推动了软件工程与自然语言处理交叉领域的发展。
当前挑战
SWE-QA-Pro-SFT-Trajectories数据集主要面临以下挑战。首先,在领域问题层面,仓库级代码问答要求模型克服传统代码理解方法中依赖静态语义或短文本片段的局限,需实现跨文件、跨目录的上下文推理,准确捕捉代码的结构、依赖关系与隐含逻辑。其次,在构建过程中,如何设计并生成真实且多样化的多轮工具交互轨迹是一大挑战,需确保智能体探索路径的合理性与完整性,同时避免因工具使用不当导致的错误累积。此外,标注高质量轨迹的成本高昂,且需人工或强模型校验以避免虚假推理,这限制了数据集的规模和泛化能力。数据格式的标准化与不同模型间的适配问题也增加了训练与复现的复杂度,亟需更高效、可扩展的生成与验证方案。
常用场景
经典使用场景
在代码理解与问答领域,SWE-QA-Pro-SFT-Trajectories数据集最经典的用途是作为监督微调(SFT)的优质数据源,专门用于训练具备仓库级代码理解能力的智能体模型。该数据集包含由Claude Sonnet 4.5生成的多轮工具调用轨迹,每个样本都记录了智能体在只读环境下使用semantic_search、view_codebase和execute_readonly_command等工具逐步探索代码库、最终回答问题并输出<finish>...</finish>标记的完整过程。研究者通常利用这些轨迹对开源大语言模型(如Qwen3-8B)进行微调,使其学会模拟这种基于工具交互的代码探索和问答行为,从而显著提升模型在仓库级代码理解任务上的推理能力。
实际应用
在实际开发场景中,基于该数据集微调的智能体模型可被部署为自动化代码审查助手或开发者问答系统,直接服务于软件工程团队。例如,当开发者面对一个大型GitHub仓库,想了解某个函数的作用、某段逻辑为何如此设计或某个bug的根因时,模型可以模拟人类开发者的探索流程,依次进行语义搜索、浏览文件和执行命令行查询,最终给出有依据的解答。这种能力尤其适用于开源项目维护、遗留系统文档化、以及新成员快速熟悉陌生代码库的场景,显著降低了人工阅读和理解代码的时间成本。
衍生相关工作
作为SWE-QA-Pro训练方案的核心SFT数据,该数据集直接推动了多个相关研究工作。其所在的SWE-QA-Pro项目提出了从轨迹生成、监督微调到偏好对齐的完整训练流水线,开创了“以探索驱动理解”的代码智能体范式。受其启发,后续工作进一步探索了多智能体协作、更丰富的工具集扩展,以及将类似策略迁移至更大规模的代码库和更复杂的软件工程任务中。该数据集的设计理念——利用高质量轨迹进行行为克隆——已被验证是提升大模型代码推理能力的有效途径,并催生了一系列关于代码智能体训练策略、评价指标和泛化能力的研究方向。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

