
LumberChunker/GutenQA_Propositions
收藏官方服务:
资源简介:
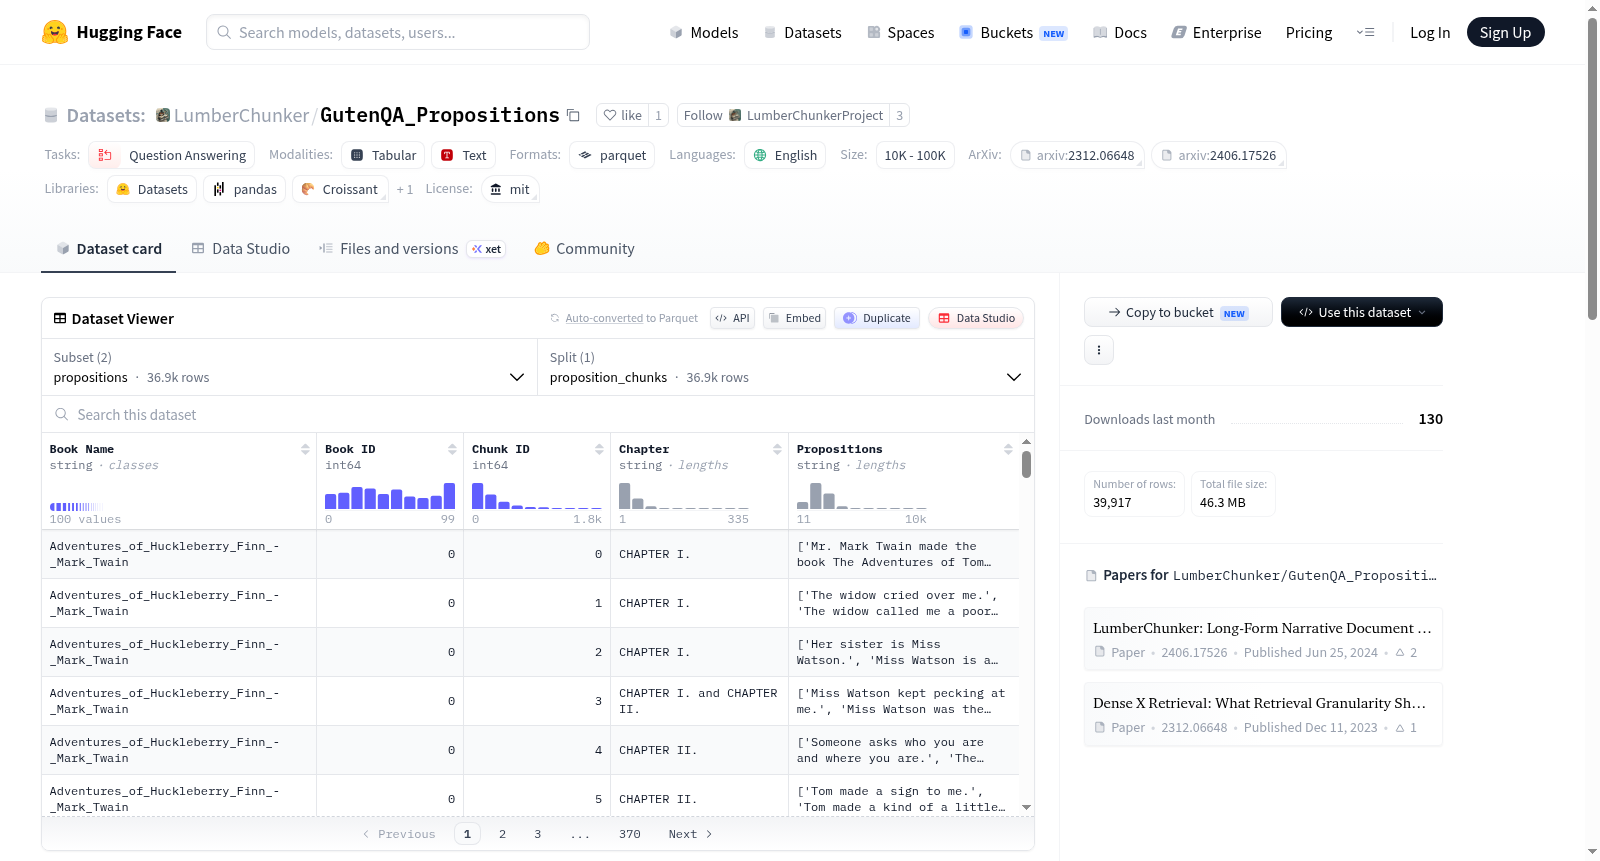
GutenQA-Propositions数据集基于100本公共领域的叙事书籍,这些书籍也用于GutenQA基准测试。该数据集将GutenQA的段落转换为命题,并包含书籍名称、书籍ID、块ID、章节、命题、问题和命题答案等列。数据集的组织方式使其适用于问答任务,特别是针对长文本的问答。
The GutenQA-Propositions dataset is built upon 100 public-domain narrative books, which are also utilized in the GutenQA benchmark. This dataset transforms the passages from the GutenQA benchmark into propositions, and includes columns such as book name, book ID, chunk ID, chapter, proposition, question, and proposition answer. The dataset is structured to support question answering tasks, especially long-document question answering.
提供机构:
LumberChunker原始信息汇总
GutenQA-Propositions 数据集概述
基本信息
- 许可证: MIT
- 任务类别: 问答
- 语言: 英语
数据集配置
- 配置名称: propositions
- 数据文件:
- 分割: proposition_chunks
- 路径: gutenqa_propositions_only.parquet
- 数据文件:
- 配置名称: questions
- 数据文件:
- 分割: proposition_questions
- 路径: gutenqa_propositions_questions.parquet
- 数据文件:
数据集结构
- 列信息:
Book Name: 书籍标题Book ID: 书籍唯一整数标识符Chunk ID: 书籍块的整数标识符,按书籍中的顺序列出Chapter: 块所属的章节名称,如果LumberChunker合并了多个章节的段落,则包含所有相关章节的名称Propositions: 每个行包含对应于GutenQA数据集中(Book ID, Chunk ID)对的命题集合Question: 与特定文本块相关的问题,并非每个块都有相关问题,每本书生成30个问题Proposition Answer: 与该块相关问题的答案命题
数据集来源
- 书籍来源: 数据集包含100本公共领域叙事书籍,源自GutenQA数据集。
- 处理方法: GutenQA数据集中的段落被转换为命题,如Dense X Retrieval: What Retrieval Granularity Should We Use中所述。
搜集汇总
数据集介绍
构建方式
在长篇叙事文本的语义分割研究中,GutenQA_Propositions数据集应运而生。该数据集基于GutenQA基准测试中的100本公有领域叙事书籍构建,通过将原始GutenQA数据集中的文本段落转化为命题(propositions)形式,遵循了Dense X Retrieval工作中提出的细粒度检索思想。每个命题对应一个(Book ID, Chunk ID)组合,使得文本片段被拆解为语义上更为独立和原子化的信息单元。数据集以Parquet格式存储,包含两个配置:propositions配置存储命题本身,questions配置存储对应的问题与答案命题,便于后续检索与问答任务的联合评估。
使用方法
使用GutenQA_Propositions数据集极为便捷,推荐通过Pandas库直接读取Parquet文件。用户可调用pd.read_parquet函数加载远程数据集,例如读取命题配置时指定路径为hf://datasets/LumberChunker/GutenQA_Propositions/gutenqa_propositions_only.parquet。加载后,可利用DataFrame的筛选功能,如按书名过滤特定书籍的命题数据,以便进行针对性的实验分析。数据集同样支持加载问题配置,用于构建问答系统的训练或评估流程。这种轻量级的数据访问方式,降低了使用门槛,便于研究者快速集成到现有工作流中。
背景与挑战
背景概述
在自然语言处理领域,长文本的语义分割与信息检索一直是研究的热点与难点。GutenQA-Propositions数据集由André V. Duarte、João Marques等研究人员于2024年提出,作为LumberChunker论文的基准评估资源之一。该数据集基于100本来自Project Gutenberg的公共领域叙事书籍,将原始GutenQA数据集中的文本片段转化为命题(propositions)形式,借鉴了Dense X Retrieval中关于检索粒度的思想。其核心研究问题在于探索如何通过命题级别的文本表示,提升长文档分割与问答系统的性能。该数据集为评估文档分割算法提供了细粒度的标注,对推动长文本理解与信息检索技术的发展具有重要影响。
当前挑战
当前数据集面临的核心挑战在于命题粒度的平衡问题:过细的命题可能丢失上下文连贯性,过粗则难以精准定位答案。在构建过程中,如何将原始GutenQA中的段落自动且一致地拆分为语义完整的命题,同时避免信息冗余或缺失,是主要技术难点。此外,数据集仅包含每本书30个问题的问答对,覆盖范围有限,难以全面评估模型在不同叙事风格和主题上的泛化能力。最后,命题与问题之间的对齐依赖人工验证,确保标注一致性仍需大量努力,这限制了数据集的规模扩展与应用场景。
常用场景
经典使用场景
GutenQA-Propositions 数据集在长文本叙事文档的语义分割与检索任务中扮演着关键角色。该数据集将GutenQA基准中的段落转化为细粒度的命题(propositions),为评估文档分割算法提供了精细化的标注。其经典使用场景包括作为LumberChunker等分割方法的基线对比,通过命题粒度的问答对来检验分割质量,从而推动叙事文本的语义单元划分研究。
解决学术问题
该数据集主要解决了长文本检索中粒度不匹配的学术难题。传统方法常将整段文本作为检索单元,导致信息冗余或遗漏。GutenQA-Propositions通过命题级别的表示,使模型能精准定位答案所在的最小语义单元,显著提升了密集检索在长篇叙事文本中的准确率。这一设计为“Dense X Retrieval”理论提供了实证支持,推动了检索粒度优化方向的发展。
实际应用
在实际应用中,该数据集可用于构建智能阅读助手、文学知识问答系统及数字图书馆的语义索引服务。例如,基于命题的检索能帮助读者快速定位小说中特定情节或对话的出处,提升文献查阅效率。此外,在长文本摘要生成和内容推荐系统中,命题粒度信息能增强系统对叙事逻辑的把握,从而生成更连贯的摘要或推荐更相关的段落。
数据集最近研究
最新研究方向
在长文本叙事文档的语义分割与检索粒度优化领域,GutenQA-Propositions数据集正引领一项前沿探索。该数据集将经典公共领域叙事文本的段落转化为细粒度命题(propositions),这一方法论源自Dense X Retrieval研究中关于检索粒度选择的深刻洞见。当前研究热点聚焦于如何通过命题级别的文本切分,提升大语言模型在长篇叙事理解任务中的精准度与效率,尤其是在问答系统与信息检索场景下。通过将LumberChunker分割算法与命题化表示相结合,研究者得以突破传统固定长度切分或段落级分割的局限,更精细地捕捉叙事流中的语义边界与关键信息。这一方向不仅关联着长文档自动摘要、故事生成等热点应用,也为构建更鲁棒、可解释的叙事理解基准提供了关键支撑,其影响力正从学术研究向工业级文档处理系统渗透。
以上内容由遇见数据集搜集并总结生成


