
p1atdev/ja-stackoverflow
收藏官方服务:
资源简介:
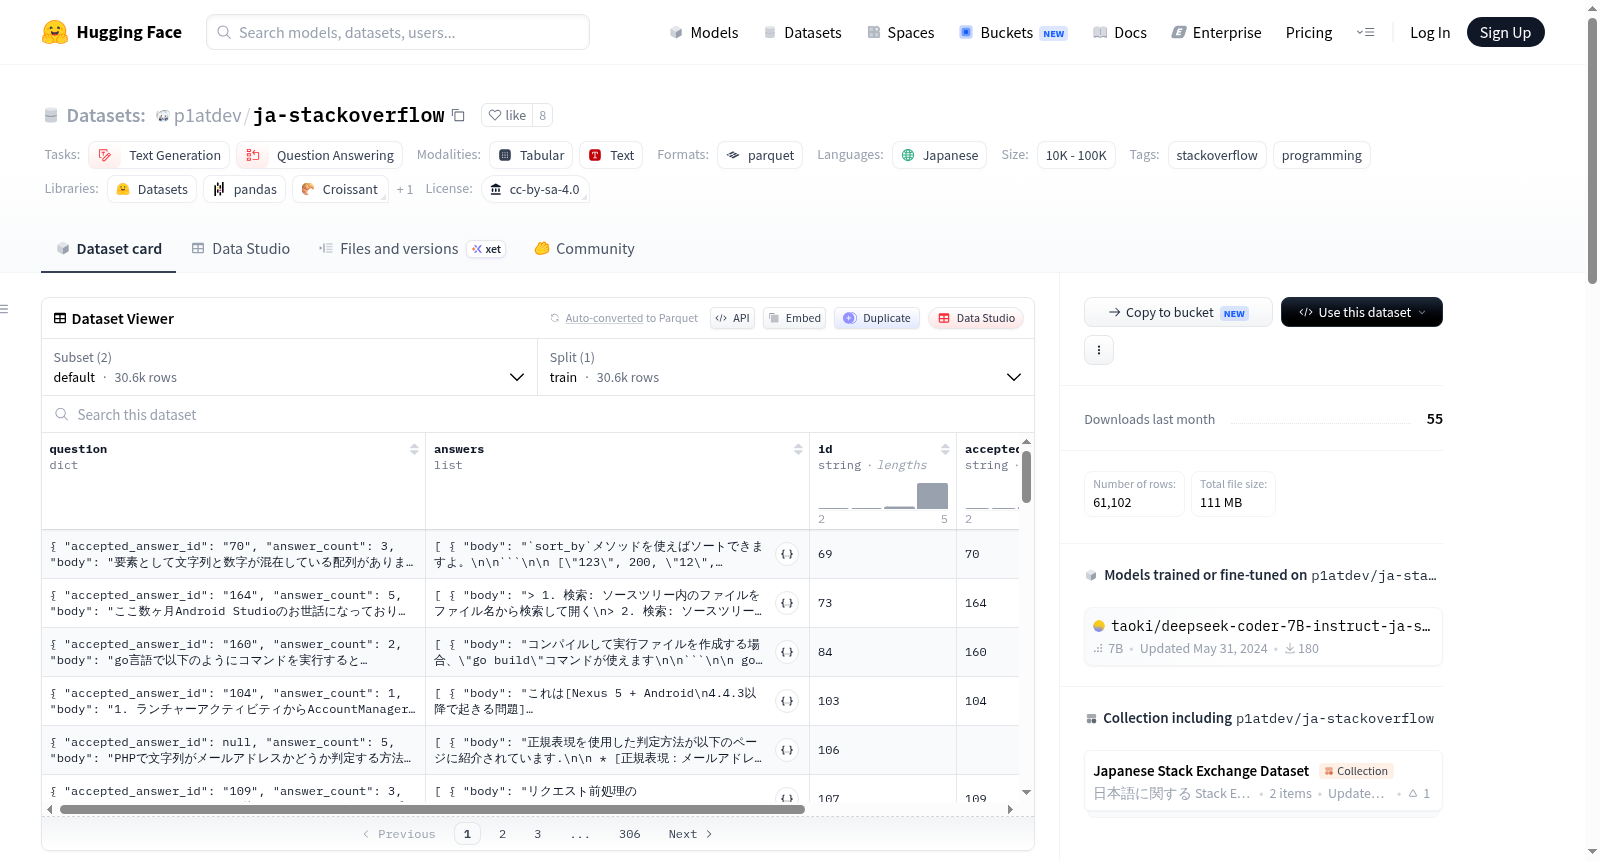
该数据集基于日语版Stack Overflow的数据,经过加工处理,形成了问答对的形式。数据集包含两个子集:default和simple。default子集包含详细的问答信息,如问题ID、问题内容、回答列表、被接受的回答ID和最受欢迎的回答ID等。simple子集则是对default子集的简化版本,包含了问题ID、被接受的回答ID、最受欢迎的回答ID、问题标题、问题正文、问题评分、被接受的回答正文、被接受的回答评分、最受欢迎的回答正文、最受欢迎的回答评分以及问题标签等信息。数据集的使用方法通过代码示例进行了说明,用户可以使用datasets库轻松加载和使用该数据集。
该数据集基于日语版Stack Overflow的数据,经过加工处理,形成了问答对的形式。数据集包含两个子集:default和simple。default子集包含详细的问答信息,如问题ID、问题内容、回答列表、被接受的回答ID和最受欢迎的回答ID等。simple子集则是对default子集的简化版本,包含了问题ID、被接受的回答ID、最受欢迎的回答ID、问题标题、问题正文、问题评分、被接受的回答正文、被接受的回答评分、最受欢迎的回答正文、最受欢迎的回答评分以及问题标签等信息。数据集的使用方法通过代码示例进行了说明,用户可以使用datasets库轻松加载和使用该数据集。
提供机构:
p1atdev原始信息汇总
数据集概述
数据集信息
default 配置
- 特征:
question:accepted_answer_id: 字符串answer_count: 整数body: 字符串comment_count: 整数content_license: 字符串creation_date: 字符串favorite_count: 整数id: 字符串last_activity_date: 字符串last_edit_date: 字符串last_editor_user_id: 字符串owner_user_id: 字符串post_type: 字符串score: 整数tags: 字符串序列title: 字符串view_count: 整数
answers:body: 字符串comment_count: 整数content_license: 字符串creation_date: 字符串id: 字符串last_activity_date: 字符串last_edit_date: 字符串last_editor_user_id: 字符串owner_user_id: 字符串parent_id: 字符串post_type: 字符串score: 整数
id: 字符串accepted_answer_id: 字符串popular_answer_id: 字符串
- 分割:
train:num_bytes: 112596554num_examples: 30551
- 下载大小: 54805530
- 数据集大小: 112596554
simple 配置
- 特征:
id: 字符串accepted_answer_id: 字符串popular_answer_id: 字符串title: 字符串question_body: 字符串question_score: 整数accepted_answer_body: 字符串accepted_answer_score: 整数popular_answer_body: 字符串popular_answer_score: 整数tags: 字符串序列
- 分割:
train:num_bytes: 113051344num_examples: 30551
- 下载大小: 56632072
- 数据集大小: 113051344
配置
default配置:data_files:split:trainpath:data/train-*
simple配置:data_files:split:trainpath:simple/train-*
许可证
- CC BY-SA 4.0
任务类别
- 文本生成
- 问答
语言
- 日语
标签
- stackoverflow
- programming
数据集名称
- Japanese StackOverflow
数据集大小类别
- 10K<n<100K
搜集汇总
数据集介绍
构建方式
在自然语言处理与知识问答领域,高质量的中文编程问答数据集是构建智能代码助手与问答系统的基石。p1atdev/ja-stackoverflow 数据集源自日本版 Stack Overflow 的官方数据转储,经过系统化加工,将原始问答整理为结构化的问答对。构建过程中,利用 html2text 工具将 HTML 格式的帖子正文转换为 Markdown 格式,其中代码块被统一包裹在三个反引号中,而包含 base64 编码图片的 URL 则被替换为 [unk] 占位符。数据集提供了 default 和 simple 两个子集,前者保留问题与答案列表的嵌套结构,后者则将其展开为平铺字段,便于直接使用。
特点
该数据集的核心特点在于其针对日语编程社区的专门化设计,涵盖了从基础语法到高级框架的广泛话题。每个样本包含问题的标题、正文、标签、得分等元信息,以及对应的采纳答案和最高分答案,形成多层次的问答映射。数据规模约为 3 万条样本,属于中等规模,但内容质量较高,因为所有数据均来自真实用户交互,且经过社区评分筛选。此外,数据集采用 CC BY-SA 4.0 许可,确保了学术与商业使用的合规性。
使用方法
用户可通过 Hugging Face 的 datasets 库便捷加载该数据集。加载时需指定子集名称(如 simple)并选择训练集划分,即可获得包含问题与答案字段的 Dataset 对象。simple 子集特别适合直接用于文本生成或问答任务的微调,例如将问题标题与正文拼接作为输入,采纳答案作为目标输出。对于需要更丰富上下文的研究,default 子集提供了完整的答案列表,支持多答案选择或排序模型的训练。数据集的字段设计清晰,可直接用于构建检索增强生成或序列到序列模型。
背景与挑战
背景概述
在自然语言处理领域,高质量、领域特定的问答数据集对于训练和评估模型至关重要。p1atdev/ja-stackoverflow 数据集由开发者 p1atdev 于近期创建,其核心研究问题在于构建一个面向日语编程社区的问答对资源。该数据集源自日本版 Stack Overflow(スタック・オーバーフロー)的官方数据转储,通过精心设计的预处理流程,将原始帖子转化为结构化的问答对。数据集包含 default 和 simple 两个子集,前者保留完整的问答关系,后者则简化了字段结构,便于直接使用。该资源以 CC BY-SA 4.0 许可发布,为日语编程问答研究提供了标准化基础,对推动日语技术领域的文本生成与问答系统发展具有显著影响力。
当前挑战
该数据集面临的挑战主要体现在两个层面。在领域问题层面,日语编程问答任务需要模型同时理解自然语言与代码片段的混合表达,而现有日语语料库中此类结构化数据稀缺,导致模型在代码上下文推理与专业术语处理上表现不足。在构建过程中,挑战尤为突出:原始数据转储包含大量噪声,如 base64 编码的图片 URL 需替换为 [unk] 标记;代码块需通过 html2text 工具转换为统一的 Markdown 格式;此外,需处理缺失的 accepted_answer_id 与 popular_answer_id 字段,确保问答对逻辑一致性。这些预处理步骤的可靠性直接决定了数据集质量,而 30,551 条样本的规模也限制了模型在低资源场景下的泛化能力。
常用场景
经典使用场景
在自然语言处理与信息检索的交叉领域中,p1atdev/ja-stackoverflow数据集以其精心构建的日语问答对结构,成为训练和评估文本生成与问答系统的经典资源。该数据集源自日本版Stack Overflow的公开数据转储,经过去重、清洗及markdown化处理,保留了包含问题、答案、标签、评分及采纳状态在内的丰富元信息。研究者常利用其default子集进行多答案排序与生成模型的微调,或借助simple子集直接获取问题与最优答案的配对,从而在日语编程问答场景下检验模型对技术术语、代码片段及上下文理解的能力。数据集规模适中(逾三万个样本),既避免了小样本过拟合风险,又便于迭代实验,是日语NLP社区中兼具代表性与实用性的基准资源。
实际应用
在实际应用层面,该数据集直接服务于日语编程社区的智能问答系统开发。例如,开发者可基于此数据集构建面向日本程序员的自动问答机器人,在IDE插件或技术论坛中实时推荐相关问题的采纳答案。此外,数据集中包含的代码块与标记化标签,可用于训练代码搜索与推荐引擎,帮助用户在海量技术讨论中快速定位解决方案。企业级应用场景还包括日语技术文档的自动生成与翻译辅助系统,通过分析问题与答案的语义映射,提升跨语言技术支持的效率。数据集采用的CC BY-SA 4.0许可协议也保障了其在商业产品中的合规使用,进一步拓展了从学术研究到工业部署的转化路径。
衍生相关工作
基于ja-stackoverflow数据集,学术界已衍生出多项经典工作。在模型层面,研究者将其用于微调日语版T5或GPT系列模型,产出专门针对编程问答的领域化语言模型,如针对日语代码生成与解释的CodeBERT-ja变体。在任务层面,该数据集催生了日语答案选择与答案摘要的基准评测任务,相关论文在ACL、EMNLP等顶级会议上探讨了如何利用评分与采纳状态进行弱监督学习。此外,亦有工作将其与英语Stack Overflow数据进行跨语言对比分析,揭示不同语言社区在问题表述与答案质量上的差异,为多语言知识迁移提供了实证基础。这些衍生产出不仅验证了数据集的学术价值,也持续拓展着其在计算语言学和软件工程交叉领域的研究边界。
以上内容由遇见数据集搜集并总结生成


