
遇见数据集

PandaVT/datatager_legal_risk_assessor

收藏
Hugging Face2024-06-05 更新2024-06-15 收录
官方服务:

资源简介:

Legal Risk Assessor数据集由DataTager团队创建,旨在提升律师在客户咨询过程中分析事件和评估潜在风险的能力。该数据集包含结构化的案例背景、可能的法律问题和响应建议,提供了法律合规、诉讼风险、合同履行风险、财务风险和声誉风险等方面的详细分析和评估。这些记录帮助律师和法务团队更准确地预测案件结果,制定更有效的法律策略,并确保在案件处理过程中全面考虑各种潜在风险。

The Legal Risk Assessor dataset was created by the DataTager team, aiming to enhance lawyers' ability to analyze incidents and assess potential risks during client consultation processes. This dataset includes structured case backgrounds, potential legal issues and response suggestions, providing detailed analyses and assessments covering legal compliance, litigation risks, contract performance risks, financial risks and reputational risks. These records help lawyers and legal teams more accurately predict case outcomes, develop more effective legal strategies, and ensure comprehensive consideration of various potential risks throughout the case handling process.

提供机构:
PandaVT
原始信息汇总

Legal Risk Assessor Dataset

描述

Legal Risk Assessor 数据集由 DataTager 团队创建,旨在提升律师在客户咨询过程中分析事件和评估潜在风险的能力。该数据集包括案件背景、可能的法律问题和应对建议的结构化记录,提供在法律合规、诉讼风险、合同履行风险、财务风险和声誉风险等方面的详细分析和评估。这些记录有助于律师和法律团队更准确地预测案件结果,制定更有效的法律策略,并在案件处理过程中全面考虑各种潜在风险。

使用

该数据集对于律师事务所、法律部门和法律服务机构具有重要价值,旨在通过 AI 简化法律风险评估。通过使用此数据集,可以训练 AI 模型有效分析和评估潜在法律问题并提供解决方案。它还可用作法律专业人士和学生的教育资源,帮助他们理解案件分析和风险评估的复杂性,从而提高法律咨询和案件处理的效率和准确性。

引用

请在您的工作中按以下方式引用此数据集:

@misc{ Extract Medical Information Dataset, author = {DataTager}, title = {Extract Medical Information Dataset}, year = {2024}, publisher = {GitHub}, journal = {GitHub repository}, howpublished = {https://github.com/PandaVT/DataTager} }
搜集汇总
数据集介绍
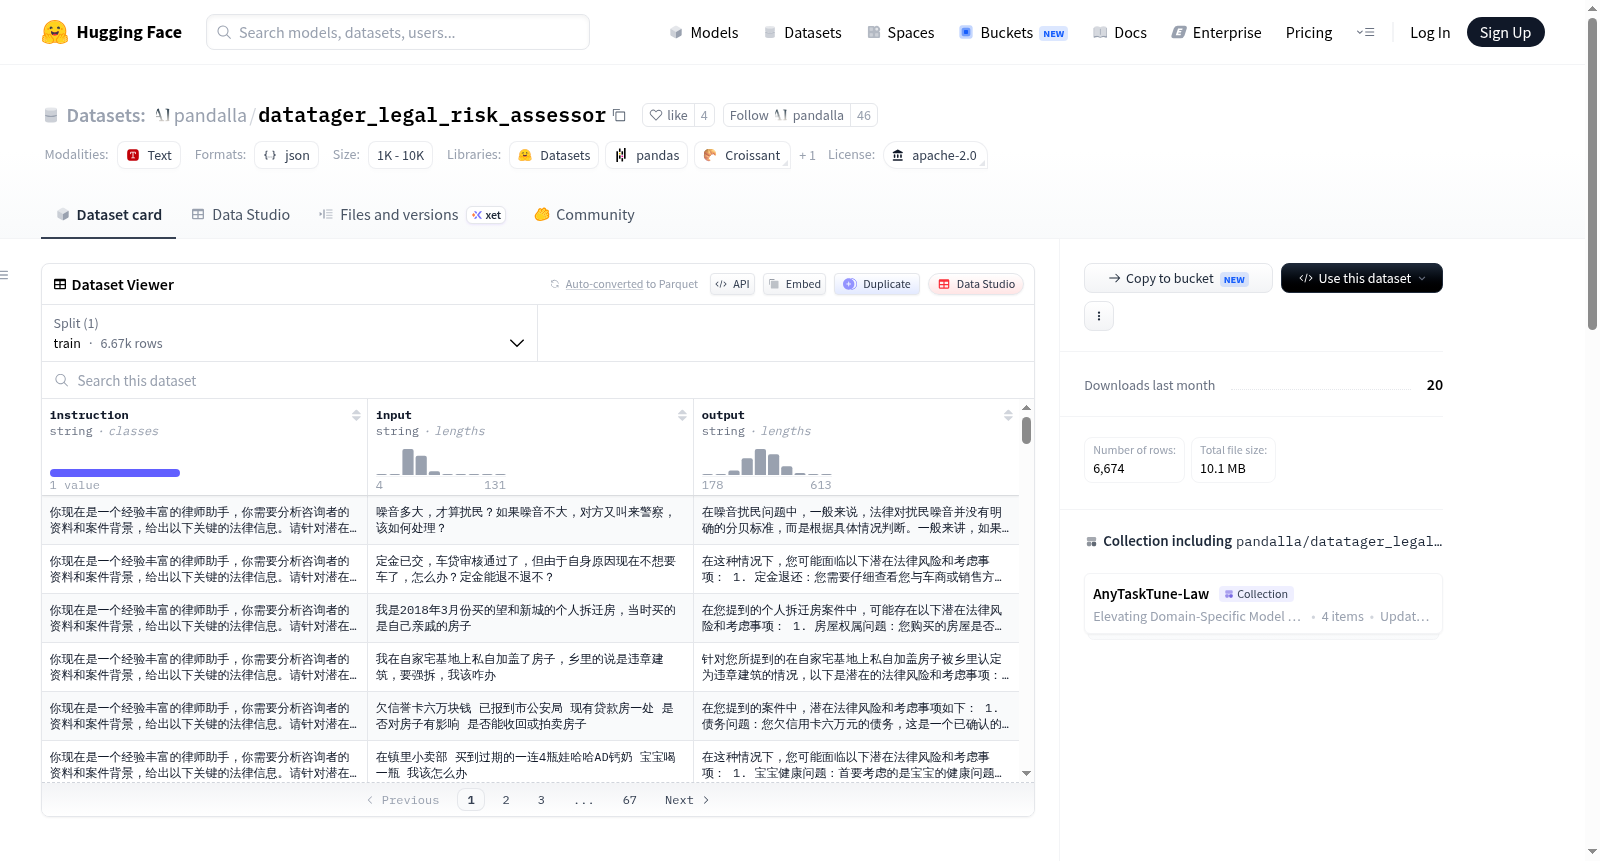
PandaVT/datatager_legal_risk_assessor 数据集图片
构建方式
在法律咨询与案件处理的复杂场景中,精准的风险评估是律师与法务团队的核心诉求。PandaVT/datatager_legal_risk_assessor数据集由DataTager团队精心构建,旨在通过任务特定微调提升大型模型对法律风险的解析能力。该数据集以结构化记录形式呈现,涵盖案件背景、潜在法律问题及应对建议等关键信息,并围绕法律合规性、诉讼风险、合同履行风险、财务风险及声誉风险等维度提供详尽的分析与评估。每一份记录均经过专业标注,确保数据的高质量与实用性,从而为法律从业者提供基于真实业务场景的精细化训练素材。
特点
该数据集的核心特色在于其多维度、高覆盖的风险评估体系,能够全面捕捉法律咨询中的潜在隐患。其结构化设计不仅包含案件事实的客观描述,还整合了法律问题的预测性分析与策略性建议,使得模型能够学习从事实到风险再到解决方案的完整推理路径。此外,数据集聚焦于法律合规、诉讼、合同履行等关键风险领域,兼具专业深度与业务广度,有效弥补了通用数据集在法律细微场景中的不足,为提升AI辅助法律决策的准确性与可靠性奠定了坚实基础。
使用方法
该数据集适用于律师事务所、法务部门及法律服务机构,可高效用于训练AI模型以自动分析法律问题并生成风险评估与解决方案。用户可将其作为微调大型语言模型的专用语料,通过监督学习方式增强模型对法律文本的理解与推理能力。同时,该数据集也可作为法律教育与培训的辅助资源,帮助专业人士和学生深入理解案件分析的复杂性。使用时需遵循Apache-2.0开源许可协议,确保合规引用与共享,从而在推动法律科技发展的同时维护数据使用的规范性。
背景与挑战
背景概述
在法律实务领域,案件风险评估与法律咨询的智能化转型已成为提升司法效率的关键课题。由DataTager团队于2024年创建的Legal Risk Assessor数据集,旨在通过任务特定微调技术,增强律师在客户咨询中对事件潜在风险的剖析能力。该数据集隶属于AnyTaskTune项目,由DataTager团队主导开发,核心研究问题聚焦于如何利用结构化记录——涵盖案件背景、潜在法律问题及应对建议——实现法律合规、诉讼风险、合同履行风险、财务风险及声誉风险的多维度评估。这一资源不仅为法律从业者提供精准的案例预测与策略制定支持,更通过开放源代码(Apache-2.0许可)推动了法律人工智能领域的基准测试与模型优化,对司法辅助系统的学术研究与产业应用产生了深远影响。
当前挑战
该数据集面临的核心挑战首先体现在领域问题的复杂性上:法律风险评估需兼顾事实逻辑与法律规范的动态交互,现有模型在捕捉多类型风险(如合同违约与声誉损害)的因果关联时仍存在显著偏差,难以满足真实场景中高精度的判决预测需求。其次,构建过程中遭遇了数据稀缺性与标注一致性的双重困境——法律文书的隐私保护限制导致可用案例不足,且不同专家对同一事件的风险等级判定常存在分歧,需依赖迭代式人机协同标注框架来校准标签质量。此外,跨法域适用性不足构成另一瓶颈,数据集当前偏重特定司法体系,其泛化能力在应对全球法律差异时仍待验证。
常用场景
经典使用场景
在法律实务与人工智能的交叉领域中,法律风险评估数据集为构建智能法律分析系统提供了核心支撑。该数据集以结构化的案例背景、潜在法律问题及应对建议为核心要素,广泛应用于训练大语言模型以理解复杂法律情境。经典使用场景聚焦于模拟律师与客户的初步咨询过程,模型通过解析案件事实,自动识别诉讼风险、合同履行障碍、合规漏洞及声誉威胁等多维度风险,进而生成精准的风险评估报告。这一过程不仅提升了法律分析的效率,还确保了评估结果的系统性与全面性,成为法律科技领域模型微调与效果验证的基准资源。
解决学术问题
该数据集有效回应了法律人工智能研究中长期存在的细粒度风险量化与多标签分类难题。传统研究往往局限于单一法律领域的风险判断,而本数据集通过涵盖合规、诉讼、合同、财务及声誉五大风险维度,为学界提供了跨领域、多层次的风险标注语料。研究者得以在此基础上探索基于预训练语言模型的法律推理机制,解决从非结构化案件描述到结构化风险评估的语义映射问题。其意义在于推动了法律知识表示与推理的智能化进程,为构建可解释、可泛化的法律决策系统奠定了数据基础,显著提升了法律AI研究的实证严谨性。
衍生相关工作
围绕该数据集,学术界与工业界衍生出多项标志性工作。一方面,研究者基于其多风险标签结构,提出了面向法律文本的层次化注意力网络与多任务学习框架,实现了风险要素的联合抽取与关联分析。另一方面,法律检索增强生成(RAG)系统利用该数据集作为知识锚点,在回答法律咨询时动态引用相关案例与法条,显著提升了生成内容的专业性与可溯源性。此外,若干工作聚焦于模型的可解释性,通过可视化风险贡献度与法律推理路径,使AI的决策过程更符合律师的认知逻辑,推动了可信法律AI的边界拓展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

