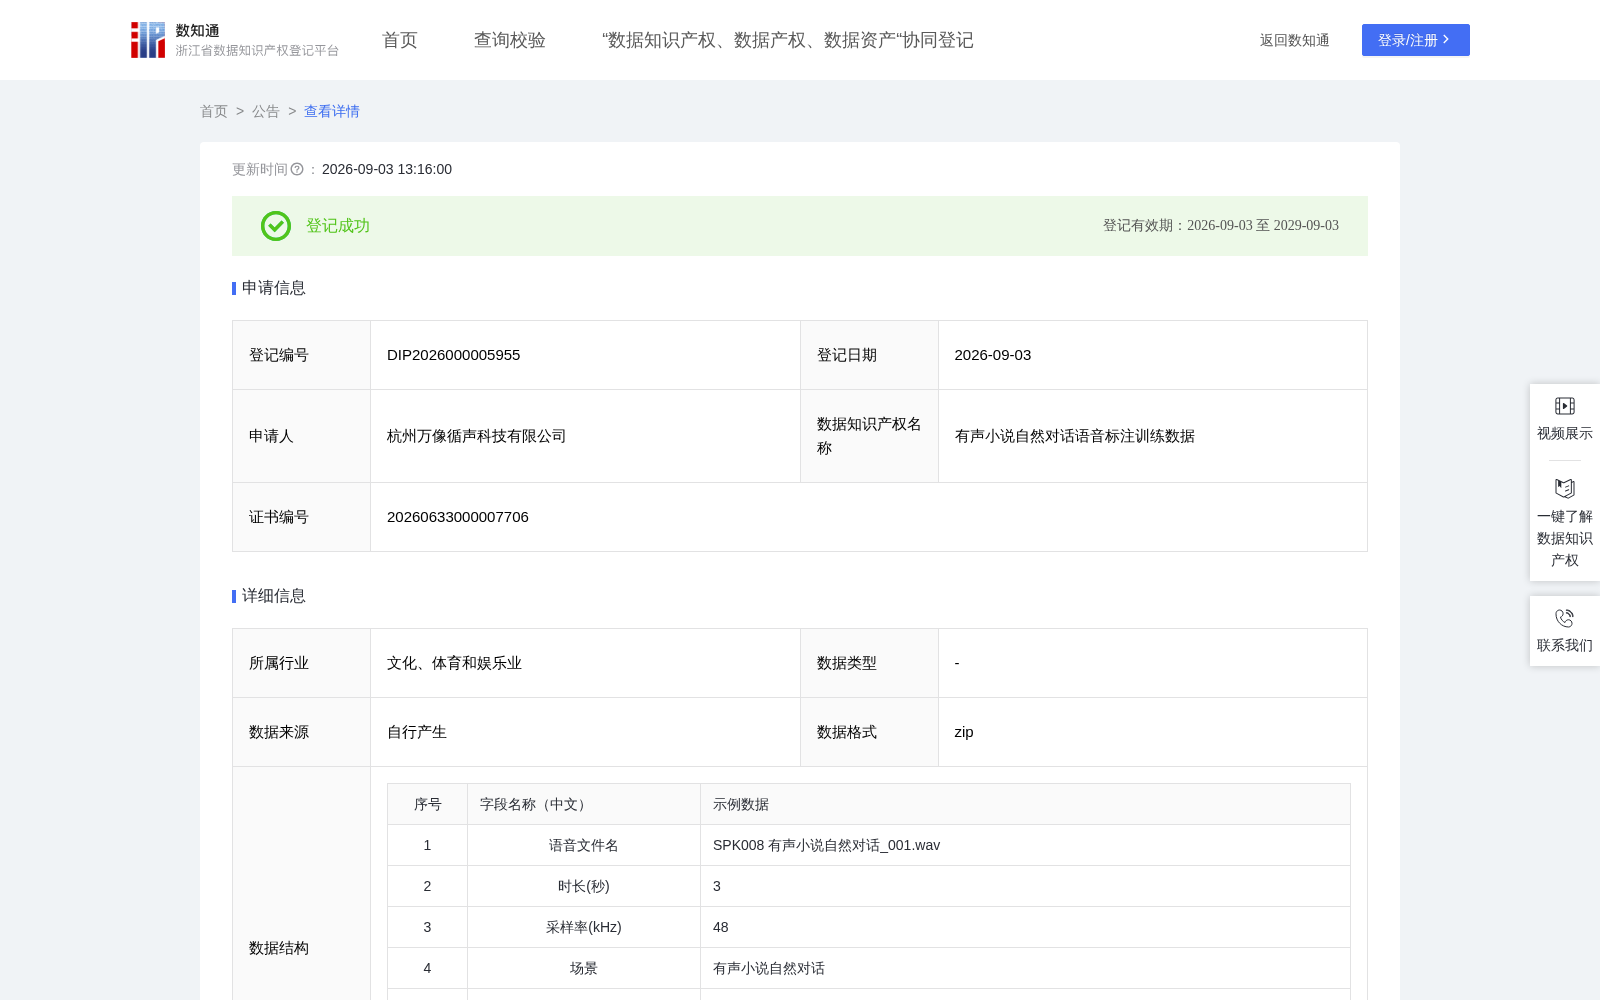
有声小说自然对话语音标注训练数据
收藏资源简介:
本数据集聚焦有声小说朗读者在专业录音棚中录制的自然对话语音,属于有声小说背景下的口语语料,服务于社交语音分析、智能客服、闲聊机器人、有声创作者的口语风格研究等场景。说话人为一位男性有声小说朗读者,语音内容为无脚本日常闲聊,涵盖宿舍生活、节日聚会、星座命理、校园趣事等话题,口语特征鲜明(频繁使用“嗯”、“然后”、“就是说”等语气词,存在重复、自我修正)。每段语音均附有人工转写,完整保留真实口语的无脚本表达。该数据集的说话人具有有声小说朗读的专业发声习惯(声音共鸣、咬字清晰),但内容为即兴口语,兼具广播腔的质感与日常聊天的松弛感,具有独特的声学特征。 独立性与必要性 本数据集的独特性在于:说话人既是专业朗读者(音色、气息、咬字均优于普通人),又完全以自然口语方式交谈,这种“半专业”声线对于训练具有亲和力又清晰耐听的语音合成模型具有重要价值。该数据集在语音合成领域具有不可替代的应用潜力。一、数据采集与预处理 原始数据来源于杭州万像循声科技有限公司在专业录音棚内录制的自然对话语音,说话人为一位男性有声小说朗读者(SPK008)。录音格式为WAV,采样率48kHz,专业声学环境保证高信噪比。采集内容为无脚本自发对话,话题涵盖校园、社交、兴趣等,要求说普通话并保持日常生活聊天状态。预处理阶段,使用音频处理工具批量读取每段语音的时长(秒),统一文件命名格式,并对音频进行音量归一化、静音段切除等标准化处理,保证数据一致性。 二、特征标注 由熟悉口语对话标注的人员对每段语音进行精细化人工标注,针对本数据集“专业朗读者即兴对话”的特点,突出以下差异化标注项: 语音转写:将音频内容逐字转写为标准汉字,重点记录口语化特征,包括频繁出现的语气词(“嗯”、“然后”、“就是说”)、语句重复、自我修正、话题跳跃及非流畅停顿,完整再现自然对话的随意性。与普通朗读数据不同,本数据集要求标注人员特别关注并标记朗读者在即兴状态下脱离“朗读腔”的真实口语现象,如突然的语速变化、气息中断、词汇选择的生活化等; 叙事语调标注:根据语音的语调起伏、节奏变化和情绪饱满度,将每句语音的叙述状态分为平静、轻快、兴奋三类。平静对应语调平稳、无明显情绪起伏的客观陈述;轻快对应语调上扬、有明显轻松愉悦感的分享式表达;兴奋对应语调起伏大、情绪高昂的叙述状态。该分类用于训练模型在不同情绪状态下的语音合成控制; 场景标注:根据内容统一标注场景为“有声小说自然对话”; 说话人属性:标注说话人标识(SPK008)及性别(男)。 三、数据结构化与打包 将上述技术参数(时长、采样率)与人工标注结果汇总为结构化表格文件,每行对应一段语音,字段包括:语音文件名、时长(秒)、采样率(kHz)、场景、说话人/音色、性别、类型、来源与授权、文本、叙事语调。 四、数据应用说明 本数据集可直接用于训练带有广播腔质感的自然对话语音合成、口语语义理解、社交语音分析等AI任务。数据集中每段语音均包含完整的转写文本(含丰富的口语化标注)及叙事语调标注,特别适合需要生成“既专业又亲切”声音的智能客服、有声内容创作者的口语辅助工具、虚拟主播闲聊模块等垂直场景。