
遇见数据集

AgenticCommons/oasst1-zh-pilot

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

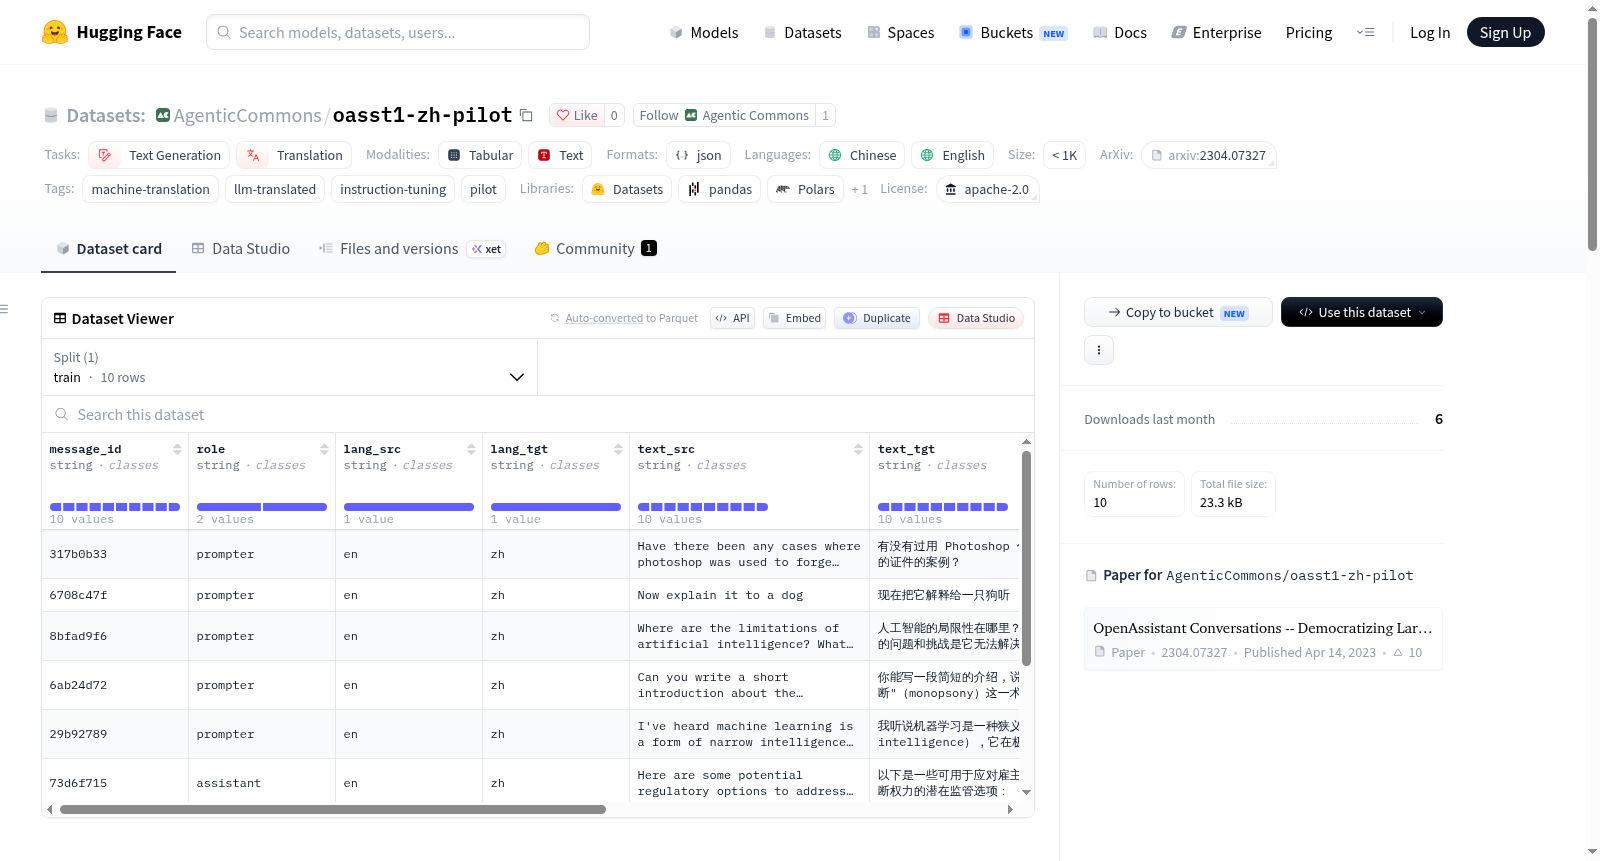
oasst1中文翻译试点数据集(10个样本)是一个试点版本,包含从OpenAssistant/oasst1数据集中翻译的10个英文到中文的平行样本。该数据集旨在展示使用LLM辅助翻译将开放指令调优数据集转化为低资源语言的方法论,并进行质量评估,而非用于训练。样本包括5个用户提示和5个助手回复,覆盖了不同难度和内容类型,如经济术语、事实问答和包含Python代码块的回复。翻译使用Claude Opus 4.7模型进行,并经过人工抽查以确保质量。数据集采用Apache 2.0许可证,来源于OpenAssistant/oasst1。

oasst1 Chinese Translation Pilot (10 samples) is a pilot release containing 10 parallel English→Chinese samples translated from the OpenAssistant/oasst1 dataset. It is intended as a methodology demonstration and quality evaluation artifact for LLM-assisted translation of open instruction-tuning datasets into low-resource languages, not as a training-ready dataset. The samples include 5 user prompts and 5 assistant replies, spanning diverse difficulty levels and content types such as economics terminology, factual Q&A, and Python code blocks. Translation was performed using the Claude Opus 4.7 model with human spot-checking for quality assurance. The dataset is licensed under Apache 2.0 and derived from OpenAssistant/oasst1.
提供机构:
AgenticCommons
搜集汇总
数据集介绍
AgenticCommons/oasst1-zh-pilot 数据集图片
构建方式
在开放指令微调语料日益丰富但多语言资源仍然稀缺的背景下,该数据集以OpenAssistant/oasst1为源语料,通过大模型辅助翻译的方式构建中英平行样本。构建过程从oasst1中选取10条英文消息,覆盖5条用户提问(长度介于23至2198字符之间)与5条助手回复,内容涉及经济学术语、事实问答及含Python代码块的回复。翻译由Claude Opus 4.7以单次翻译方式完成,并明确要求保留代码块、变量名、字符串字面量、URL及学术术语,术语首次出现时在括号中保留英文原词。译文经中文母语者人工抽检,确保质量可控。
特点
作为方法学验证与质量评估的试点发布,该数据集并未定位为可直接用于训练的成品语料。其样本数量仅为10条,规模有限,却刻意覆盖了从短文本到长文本、从日常问答到专业术语与代码保留等多样难度场景,以便快速暴露翻译质量与工程处理中的潜在失效模式。数据字段设计兼顾平行文本与长度分析需求,包含源文本与目标文本及其字符数、角色标注、源与目标语言代码、翻译模型标识等,便于开展长度比例分析与质量对比研究。整体以中英双语平行形式呈现,遵循Apache 2.0许可。
使用方法
该数据集主要面向评估与演示用途,研究者可将其用于检验大模型辅助翻译在指令微调数据本地化中的可行性,或作为人工评估与自动指标评测的样例集合。使用时可通过HuggingFace datasets库加载,依据role字段区分用户提问与助手回复,结合text_src与text_tgt开展平行文本对照分析,利用char_count_src与char_count_tgt进行长度比例研究,并借助translation_model字段追溯翻译来源。若用于学术评价工作,应引用原始oasst1文献。由于样本量小且未经过反向翻译相似度评分,不建议将其直接用于模型训练。
背景与挑战
背景概述
在指令微调语料匮乏的非英语语境中,OpenAssistant/oasst1 作为开源对话数据集为多语言适配提供了重要基础。2023 年前后,Köpf 等人发布 oasst1,推动了大模型对齐数据的开放共享。然而,高质量中文指令数据长期稀缺,机器翻译质量亦缺乏系统验证。为此,Agentic Commons 于 2024 年前后推出 oasst1-zh-pilot,选取 10 条英中平行样本,旨在检验大模型辅助翻译开放指令语料至低资源语言的可行性,并评估其质量能否被社区接受。该试点为后续全量翻译与多语言扩展提供方法学参照,对中文指令微调数据建设具有探索性影响。
当前挑战
该试点所面对的领域问题,在于开放指令语料跨语言迁移后能否保持语义忠实、术语准确与代码结构完整,从而支撑中文指令微调。构建过程中的挑战尤为突出:样本需覆盖从简短提问到长文本回复及含 Python 代码块的多类难度,单一翻译模型需兼顾术语保留、变量名与字符串字面量不被改写、URL 与学术术语处理得当,同时仅依靠母语者人工抽检而缺乏反向翻译相似度评分,质量验证手段尚不充分,10 条样本的规模也难以支撑统计意义上的泛化结论。
常用场景
经典使用场景
在指令微调语料跨语言迁移的研究脉络中,平行语料的构建与质量评估始终是核心议题。oasst1-zh-pilot作为一项先导性发布,精心选取了OpenAssistant/oasst1中10条涵盖不同难度层级的英文样本,包括5条用户提示与5条助手回复,并借助Claude Opus 4.7完成英译中平行对齐,同时保留原始message_id、角色标签及字符计数等元信息。该数据集的经典使用场景集中于机器翻译质量的评估与校验,研究者可依托其平行结构考察代码块、变量名、字符串字面量及学术术语在翻译过程中的保真程度,亦可将其作为低资源语言指令语料构建方法论的演示性案例,审视大模型辅助翻译在开放指令数据集本地化流程中的可行性与边界。
实际应用
在实际应用层面,该数据集可服务于中文大语言模型指令微调数据的质量基准建设,为翻译模型与对齐模型的评估提供小规模但标注清晰的平行语料。开发者可借助其字符计数与翻译模型字段开展长度比例分析与模型对比实验,亦可将其作为翻译提示工程与术语一致性策略的调优参照。对于致力于构建中文开放指令语料的研究团队而言,该先导数据集展示了从样本甄选、模型翻译到人工抽查的完整工作流,能够在正式规模化生产前用于流程验证与风险识别,降低大规模翻译项目中代码破坏与术语漂移等失败模式的成本。
衍生相关工作
作为源自OpenAssistant/oasst1的衍生性工作,该先导数据集与原始oasst1在许可证与引用体系上保持继承关系,其后续规模化计划指向完整oasst1语料的中文翻译及其他低资源语言的扩展。在相关工作中,它可与回译相似度评分、多语言指令微调语料构建以及基于大模型的机器翻译质量评估等方向形成呼应,为探究LLM辅助翻译在开放对话数据集本地化中的应用提供了先导性案例。其维护方Agentic Commons所倡导的全流程AI公共品贡献理念,亦为数据集众包与自动化构建相结合的实践提供了参考范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

