
遇见数据集

synthetic-receipts-ocr

收藏
Hugging Face2026-07-24 更新2026-07-27 收录
官方服务:

资源简介:

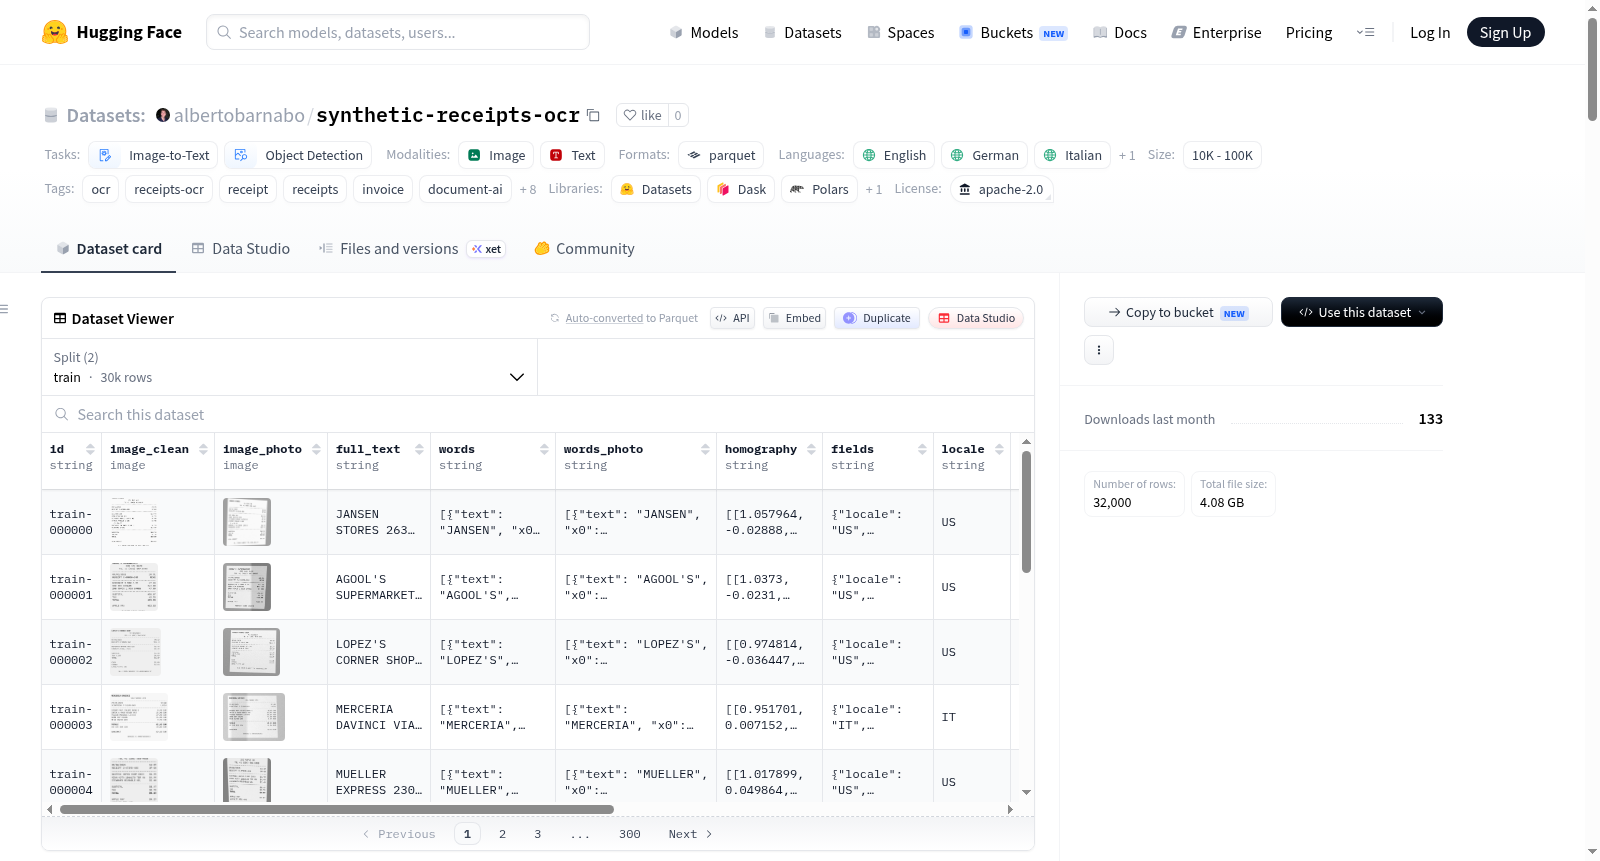
Synthetic Receipts OCR 是一个包含 32,000 张合成热敏收据图像的数据集,涵盖美国、英国、德国、意大利和法国五个地区。每个样本包含两种图像:一张是干净的渲染图像(`image_clean`),具有热敏打印机美学风格;另一张是经过照片级真实感退化的图像(`image_photo`),模拟了透视、光照不均、阴影、热敏褪色、噪声和模糊等效果。数据集提供了精确的像素级词语边界框(`words` 和 `words_photo`)、完整的逐行文本转录(`full_text`)、从干净图像到照片图像的3x3单应性矩阵(`homography`),以及结构化的关键信息提取(KIE)字段(`fields`),包括商户、地址、电话、税号、日期、时间、收据号、商品行(名称、数量、单价、总额、税率、源产品标题)、小计、各类税费、总计、支付方式等。数据集严格遵循“字段非空当且仅当其值打印在图像上”的真实性契约。数据生成过程使用了来自亚马逊 ESCI 数据集的真实产品词汇,并强制执行地区真实性(如增值税率结构、货币/日期格式、本地化标签)。数据集分为训练集(30,000 个样本)和评估集(2,000 个样本),评估集在字体、产品标题和商户姓氏方面与训练集完全不相交,以测试模型对收据结构的泛化能力而非记忆。该数据集适用于收据 OCR、文档 KIE(如 Donut/LayoutLM 风格)、文本检测和图像去噪等任务。整个生成器代码随数据集开源,支持复现和扩展。

Synthetic Receipts OCR is a dataset containing 32,000 synthetic thermal receipt images, covering five regions: USA, UK, Germany, Italy, and France. Each sample includes two types of images: a clean rendered image (`image_clean`) with thermal printer aesthetics, and a photo-realistically degraded image (`image_photo`) simulating effects such as perspective, uneven lighting, shadows, thermal fading, noise, and blur. The dataset provides precise pixel-level word bounding boxes (`words` and `words_photo`), complete line-by-line text transcriptions (`full_text`), a 3x3 homography matrix from clean to photo images (`homography`), and structured Key Information Extraction (KIE) fields (`fields`), including merchant, address, phone, tax ID, date, time, receipt number, item lines (name, quantity, unit price, total, tax rate, source product title), subtotal, various taxes, total, payment method, etc. The dataset strictly adheres to the authenticity contract where fields are non-empty if and only if their values are printed on the image. The data generation process uses real product vocabulary from the Amazon ESCI dataset and enforces regional authenticity (e.g., VAT rate structures, currency/date formats, localized labels). The dataset is divided into a training set (30,000 samples) and an evaluation set (2,000 samples), with the evaluation set completely disjoint from the training set in terms of fonts, product titles, and merchant surnames, to test the models generalization ability on receipt structures rather than memorization. This dataset is suitable for tasks such as receipt OCR, document KIE (e.g., Donut/LayoutLM style), text detection, and image denoising. The entire generator code is open-sourced with the dataset, supporting reproducibility and extension.
创建时间:
2026-07-23
搜集汇总
数据集介绍
synthetic-receipts-ocr 数据集图片
构建方式
该数据集通过一套完全自主的生成流水线构建,涵盖内容建模、渲染引擎、退化模拟及验证网关。其核心在于以随机种子与索引为输入,生成32,000张热敏纸质收据图像,覆盖美、英、德、意、法五个地区。每张收据均包含清晰渲染与模拟真实拍摄退化效果的双版本图像,退化过程涵盖透视畸变、不均匀光照、热敏褪色、噪声与模糊等。词级别边界框在渲染阶段直接捕获,确保像素级精确,而非通过事后OCR反推。生成器全量代码随数据集开源,支持复现、扩展语种或规模扩展至百万级。
使用方法
数据集通过HuggingFace Datasets库直接加载,支持按训练集(30,000条)与评估集(2,000条)分割使用。典型调用方式为`load_dataset('albertobarnabo/synthetic-receipts-ocr', split='train')`,返回的每个样本包含退化图像、清晰图像、全文文本、词边界框(含双图像空间映射)、单应性矩阵以及结构化的关键信息抽取字段。适用于多种下游任务:以退化图像与结构化字段训练Donut式KIE模型;以退化图像与全文文本训练OCR/文字识别;以退化图像与词边界框训练文本检测;或以退化图像至清晰图像训练去噪模型。单应性矩阵支持任意几何映射操作。
背景与挑战
背景概述
在文档人工智能领域,收据光学字符识别(OCR)与关键信息抽取(KIE)是自动化财务处理、票据解析等应用的核心技术。然而,真实收据数据集因涉及用户隐私而规模极小(如CORD仅约1000张、SROIE约1000张),严重制约了深度模型的泛化能力。为此,由Alberto Barnabò等人于2024年创建的synthetic-receipts-ocr数据集,通过全合成方式生成了32000张热敏收据图像,覆盖美、英、德、意、法五种区域格式,每张收据同时提供清洁渲染图和照片级退化图,附带像素级精确的单词框、完整文本转录及结构化KIE字段。该数据集引入来自Amazon ESCI数据集的6万个真实商品标题,并经过三轮对抗性质检与自动验证,确保算术一致性与区域真实性,为收据OCR与文档解析研究提供了大规模的可靠基准。
当前挑战
该数据集主要面临三方面挑战。首先,就领域问题而言,传统收据OCR因数据稀疏、隐私限制而难以建模真实场景中的复杂版式与光照退化,模型易因训练数据中的算术错误而幻视总额,该数据集通过合成技术确保了逐笔金额的精确性,但合成与真实收据之间的域差异仍是迁移学习的关键难点。其次,构建过程中需实现多区域格式的真实性模拟,包括各地增值税率结构、货币符号、日期格式及本地化标签,同时保证标签的严格可见性契约(仅标注图像中实际打印的内容)。此外,退化管线中的透视变换、不均匀光照、热敏褪色等参数化模拟,虽复现了典型采集噪声,但未涵盖手写、条形码或三维褶皱等真实场景要素,限制了模型在极端条件下的鲁棒性验证。
常用场景
经典使用场景
在文档智能与光学字符识别领域,合成数据因其可精确标注且无隐私风险而备受青睐。synthetic-receipts-ocr数据集提供了32,000张合成热敏收据图像,每张图像均包含干净渲染图和经逼真退化处理(如透视畸变、不均匀光照、热褪色、噪声模糊等)的照片模拟版本。该数据集最经典的使用场景在于训练端到端的收据OCR模型,尤其在处理复杂背景和劣质图像条件下的文本识别任务中表现卓越。研究者可同时利用干净图像与退化图像进行对比学习或联合训练,有效提升模型对真实世界中模糊、歪斜或部分褪色的收据图像的鲁棒性。此外,数据集中像素级精确的词级边界框和完整的结构化字段标注,使其成为训练文本检测模型和关键信息抽取模型的理想选择。
解决学术问题
该数据集的核心贡献在于解决了收据OCR领域长期存在的标注数据稀缺与隐私保护矛盾。真实收据数据集如CORD和SROIE仅包含约1,000张样本,且受限于隐私法规难以大规模公开。synthetic-receipts-ocr通过全合成生成策略,提供了三个数量级规模的数据量,同时保持数学一致性(每张收据的行合计、税额、找零等数值均严格可验证),从根本上消除了模型因训练数据中存在计算错误而产生的数值幻觉问题。该数据集推动了对多语言收据、多税率体系和多样化货币格式的统一理解,其严格的文体真实性(如符合各国VAT税率结构、本地化日期格式和付款标签)使跨域迁移学习研究成为可能。此外,通过提供干净与退化图像对,它揭示了合成数据在文档去噪和图像增强研究中的潜力,开创了文档图像复原与OCR联合建模的新方向。
实际应用
在现实世界的商业场景中,收据OCR技术广泛应用于自动化会计记账、费用报销审核、供应链审计和零售数据分析等流程。基于synthetic-receipts-ocr训练的系统能够自动从收据图像中提取商户名称、日期、合计金额、税率和行项目明细等关键结构化信息,极大减少人工录入错误。例如,企业财务系统可集成此类模型,实现扫描收据直接生成电子账目;电商平台可自动解析退货收据以验证商品信息和交易金额,防范欺诈风险。对于跨国企业而言,该数据集支持英语、德语、法语、意大利语等多语言收据的同步解析,满足了全球业务中统一发票管理平台的构建需求。税务审计机构可利用该技术快速核查大量收据的税额计算正确性,提升监管效率。
数据集最近研究
最新研究方向
当前,合成收据OCR数据集正推动文档人工智能领域实现关键突破。该数据集以32,000张覆盖五种语言区域的高保真合成收据为核心,通过渲染与光学退化双重图像对照、像素级精确的词边界框及结构化关键信息抽取(KIE)注释,为端到端的收据理解提供了前所未有的高质量训练资源。其前沿研究方向聚焦于利用合成数据克服真实收据数据集的隐私壁垒与规模局限,通过模拟热敏票据的透视畸变、不均匀光照、褪色等物理退化效应,训练模型在复杂真实场景下的稳健识别与信息抽取能力。该数据集的深远意义在于,它不仅为Donut、LayoutLM等经典架构在收据理解任务上的性能提升提供了可靠基准,更通过开源完整的生成管线,使得研究人员可便捷扩展至新语言区域或百万级数据规模,从而加速文档AI在商业自动化、财务审计及无纸化办公等热点应用中的落地进程,彻底改变了该领域依赖少量私密标注数据的现状。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

