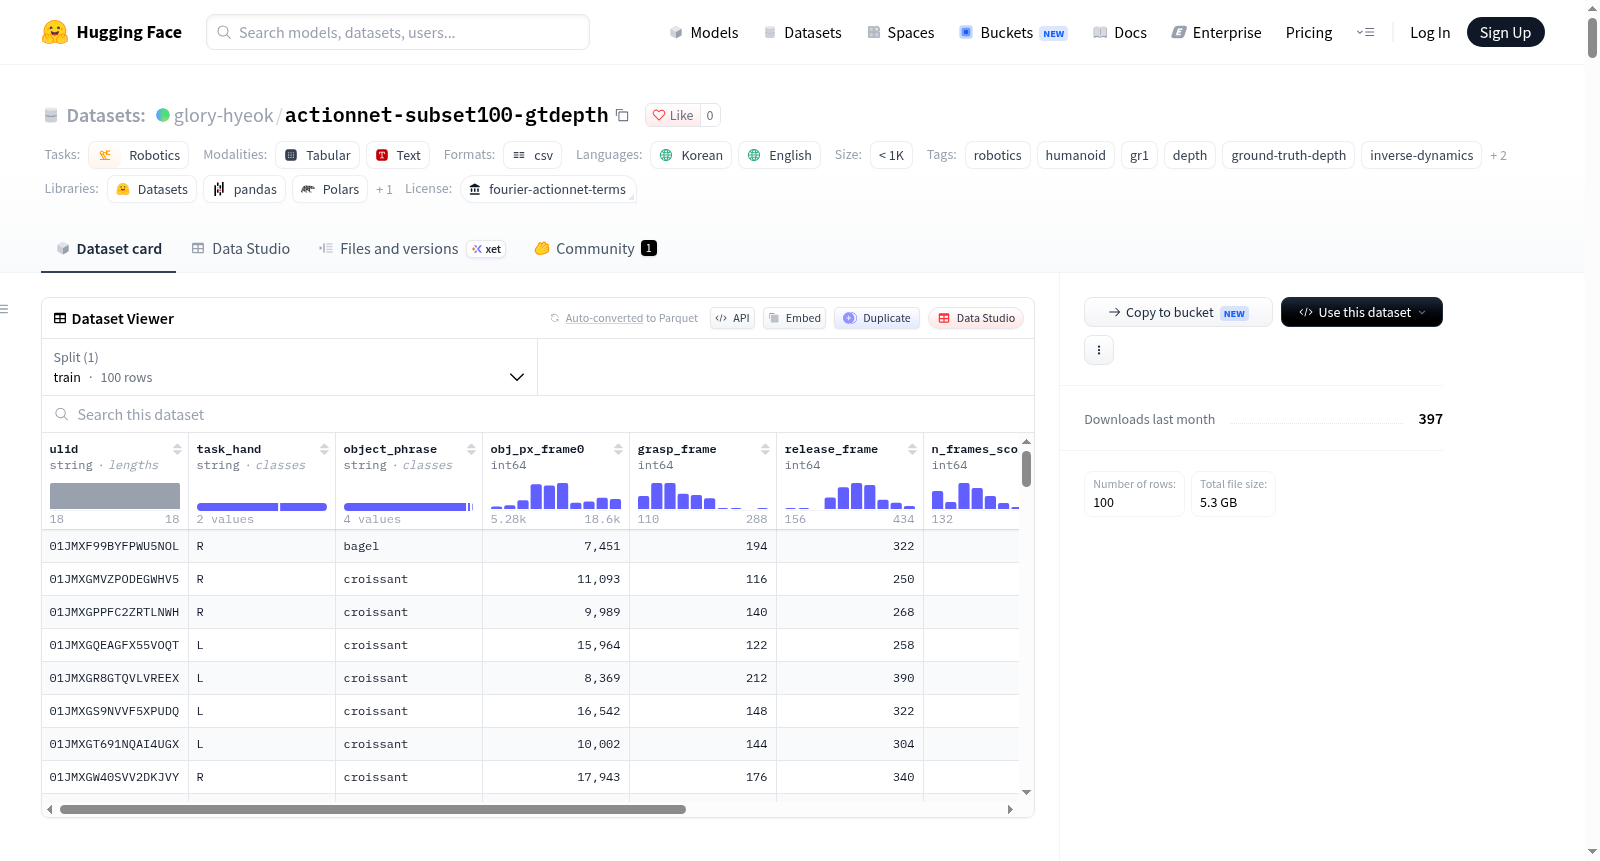
actionnet-subset100-gtdepth
收藏资源简介:
ActionNet subset100 是原始 ActionNet 数据集的一个 100 个 episode 的子集,包含了地面真值深度和修正后的状态数据。该子集旨在解决 LeRobot 转换版本中深度缺失、RGB 分辨率降低(192×288)以及状态与视频帧同步错误(60Hz 状态索引与 30Hz 视频帧不匹配)的问题。数据来自 Fourier GR1-T1 人形机器人,配备 6 自由度 DexHands 和单台头戴鱼眼相机(1280×800)。每个 episode 包含四个文件:RGB 视频(1280×800,30fps,h264)、无损深度视频(1280×800,16-bit,ffv1)、帧时间戳 JSON 和 HDF5 文件(包含机器人状态、动作、姿态等)。所有 100 个 episode 均为单一任务——拾取牛角面包(三种表述变体),场景为单物体(牛角面包放在盘子上,条纹桌布)。数据集总大小约 4.4 GB。此外,该子集还提供了预接触过滤(Pre-Contact Level Filtering)的完整实现和相关文件,包括:深度图(gtdepth/)、目标掩码(masks/)、修正后的状态和动作(states/)、跟踪手部掩码(handmasks/)、3D 世界坐标(world3d/)和遮挡判定(occlusion/)。过滤方法分为两个层次:Pre-Contact 几何检测(基于动作流判断指尖是否到达物体边界)和 Occlusion 像素检测(在接触时刻检查视频中手臂是否遮挡物体)。在该数据集上,过滤准确率为 98/100,可用作校准过滤参数和验证生成视频一致性的基准。该数据集适用于机器人学习中的逆动力学、数据过滤、接触检测、视频生成验证等任务。注意:深度为原始分辨率,状态已通过重采样和 tau 校正修正;边界球体采用百分位数裁剪,在单物体场景下表现良好,但迁移到多物体或小物体场景时需重新推导参数。
ActionNet subset100 is a 100-episode subset of the original ActionNet dataset, containing ground truth depth and corrected state data. This subset aims to address issues in the LeRobot conversion version, such as missing depth, reduced RGB resolution (192×288), and synchronization errors between states and video frames (60Hz state indices mismatched with 30Hz video frames). The data comes from a Fourier GR1-T1 humanoid robot equipped with 6-DOF DexHands and a single head-mounted fisheye camera (1280×800). Each episode includes four files: an RGB video (1280×800, 30fps, h264), a lossless depth video (1280×800, 16-bit, ffv1), a frame timestamp JSON, and an HDF5 file (containing robot states, actions, poses, etc.). All 100 episodes involve a single task—picking up a croissant (three variants of expression), with a single-object scene (croissant on a plate, striped tablecloth). The total dataset size is approximately 4.4 GB. Additionally, this subset provides a complete implementation of pre-contact level filtering and related files, including: depth maps (gtdepth/), target masks (masks/), corrected states and actions (states/), tracked hand masks (handmasks/), 3D world coordinates (world3d/), and occlusion determination (occlusion/). The filtering method has two levels: Pre-Contact geometric detection (based on action flow to determine if fingertips reach the object boundary) and Occlusion pixel detection (checking whether the arm occludes the object in the video at the contact moment). On this dataset, the filtering accuracy is 98/100, serving as a benchmark for calibrating filtering parameters and verifying video generation consistency. The dataset is suitable for tasks such as inverse dynamics, data filtering, contact detection, and video generation verification in robot learning. Note: depth is at original resolution, states have been corrected via resampling and tau correction; the bounding sphere uses percentile clipping, performing well in single-object scenes but requiring re-derivation of parameters when transferred to multi-object or small-object scenes.
ActionNet subset100 with ground-truth depth 数据集详情
数据集概述
这是一个从第三方数据集 FourierIntelligence/ActionNet 中提取的 100 个 episode 子集,并附带作者派生的校正产物。该数据集保留了原始的高分辨率 RGB 视频和无损深度数据,同时修正了 LeRobot 转换版本中存在的状态-图像错位问题。
许可与归属
| 项目 | 说明 |
|---|---|
| 上游数据集 | FourierIntelligence/ActionNet(Fourier Intelligence 提供) |
| 再分发内容 | 从 30,121 个 episode 中选取 100 个,与上游 tar 包逐字节一致:rgb.mp4(1280x800 鱼眼)、depth.mkv(无损 16 位)、timestamps.json、<ULID>.hdf5 |
| 上游条款 | 以上游仓库声明为准,约束 episode 负载;若上游禁止再分发,本仓库将下架 |
| 作者自有内容(CC-BY-4.0) | derived/ 下所有内容、映射表、build_subset100.py 及本文档 |
| 机器人平台 | Fourier GR1-T1,6 自由度 Fourier DexHands,单个头戴相机(top) |
数据集目的
LeRobot 转换版本(lerobot/action_net)存在两个问题:
- 丢弃了深度信息,并将 RGB 降采样至 192x288
observation.state以 60 Hz 索引,而行标签为 30 Hz 相机帧率,导致图像与状态最多偏差半个 episode
本子集保留原始 1280x800 RGB、无损地面真值深度,并基于原始 hdf5 构建了校正后的逐视频帧状态。
数据修正内容(2026-08-20)
| 校验项 | 测量结果 |
|---|---|
observation.robot_joints[k] 与 hdf5 /state/robot[k] 对比 |
97/100 个 episode 误差在 1e-5 以内(中位最大绝对差 5.95e-08) |
文档中的 [2k] 规则 |
0/100 符合,中位最大绝对差 0.740 rad |
校正后状态的正运动学与 /state/pose 对比 |
左末端执行器 0.29 cm,右 0.27 cm,头部 0.59 cm,0/100 超过 3 cm |
| 按视频帧索引状态的同一检查 | 移动臂中位偏差 7.59 cm(范围 2.96-18.66),99/100 超过 3 cm;静止臂保持 0.33 cm |
数据文件结构
manifest.csv 每个 episode 一行:ulid, task_hand, object_phrase, obj_px_frame0, grasp/release frame, occlusion_pos, occlusion_neg camera.json K_pinhole, K_fisheye, D 及空间定义
gtdepth/depth_<U>.npz 地面真值深度(已去畸变+降采样): depth (T, 400, 640) float16, 米 frame_indices (T,) 对应视频帧 K_ds (3,3) 该数组的内参 ds () 降采样因子(2) K_full (3,3) 1280x800 针孔内参 zero_frac, sat_frac 逐帧传感器质量 masks/object_masks_<U>.npz 目标物体掩码,(T, 800, 1280) bool + frame_indices, n_px, object_phrase, method, n_obj states/states_<U>.npz 状态 (T,44) + 动作 (T,44) + frame_indices,tau 校正后 handmasks/<U>{L,R}.npz 追踪手臂掩码(24 个 episode 的子采样) world3d/world3d<U>.json Pre-Contact 判定结果,逐 episode + 逐帧 occlusion/occlusion_full.json Occlusion 判定结果,全部 100 个在单个表中 occlusion/occlusion_series.json 窗口内逐帧得分
另有早期部分暂存:derived/points/(VLM 物体点)、derived/hand_points2/、derived/hand_tracks3/(各 10 个 episode)、derived/states/(未做 tau 校正的状态)及 subset100_gtdepth.tar。
Pre-Contact 层级过滤
F0. 过滤器的判定
给定视频及其伴随的动作流,判断视频是否与这些动作一致。过滤器分两级判定,两级均须通过:
| 层级 | 问题 | 空间 | 可见内容 |
|---|---|---|---|
| Pre-Contact | 动作指尖是否曾到达目标物体边界? | 1280x800 针孔 | 单个状态、动作流、第 0 帧物体。绝不使用像素 |
| Occlusion | 在该时刻,视频中绘制的手臂是否真正覆盖物体? | 视频自身分辨率 | 像素 |
本集合是参照集而非目标集——每个 episode 都是真实遥操作演示,手臂确实够到物体。在此运行过滤器回答的是"是否会破坏好数据",答案是 98/100,同时校准常量。目标判定集合为生成视频,见 glory-hyeok/robocurate-synth100。
F1. 场景
每个 episode 有 n_obj = 1:条纹桌布上盘子里的单个糕点。掩码由 SAM 3 文本提示生成(croissant x94、bread x3、bagel x2、donut x1),保留面积带内最大连通分量。
F2. 轨迹构建
从 episode 的第一个状态开始,使用记录的动作(降采样至 15 Hz,actions[::2])滚动状态,采用一阶跟踪模型:
q[t+1] = q[t] + beta * (q[t] - q[t-1]) + alpha * (a[t] - q[t]) beta = 0.0 alpha = 0.45 (身体) alpha = 0.60 (手)
并叠加两层偏移:
rollout_offsets——双臂及腰/头链,最大项 4.29 度left_arm_offset——仅左臂:肩俯仰 0.40、横滚 -0.27、偏航 4.04、肘俯仰 7.21 度。这是左臂编码器零偏,不可镜像到右臂
F3. 物体边界
仅在第 0 帧,深度栅格经传感器范围门控(0.05-2.6 米),按 5-95 百分位剔除离群值,将点云变换到基座坐标系,取 1-99 百分位(非最小/最大)构造包围盒,边界为包围盒的外接球。中位半径为 8.15 cm,来自 13.1 x 7.0 x 7.1 cm 的 AABB。
F4. 距离与事件
逐帧计算任务手五个 *_tip_link 指尖到球心的最小距离减去半径,d == 0 表示进入。Pre-Contact 是事件而非状态:入口帧是 d == 0 且前一帧在外部的首帧。100/100 个 episode 均存在入口事件。
F5. Occlusion 判定
窗口取入口帧 ±1 秒(即 ±30 帧,30 fps):
python occ = max(|arm_mask[f] & obj| / |obj| for f in window) keep = occ >= tol
分母为物体而非并集。任务手 occlom 中位 43.1 %(第 10 百分位 19.8 %);空闲手(负对照)最大 0.00 %。分离完全,因此阈值在本集台中不可识别,须在生成视频上设定。
F6. 过滤结果
| 指标 | 数值 |
|---|---|
| episode 数 | 100 |
| Pre-Contact 入口找到 | 76(24 个从第 0 帧即位于球内) |
| Occlusion,任务手 | 中位 43.1 %,p10 19.8 % |
| Occlusion,空闲手(对照) | 中位 0.00 %,最大 0.00 % |
| 两级均通过 | 98 / 100 |
| 边界球 | 中位 8.15 cm |
已知局限
边界球会吸收深度泄漏,但在此集合中影响较小:羊角面包 AABB 最长轴为真实轴且占主导,深度仅占 43%;在生成集合中物体为近乎各向同性的方块,深度为最短真轴,同样 5 cm 泄漏会使球体增大 42 %。建议在物体区域中位数周围选择深度带,而非百分位修剪。本集合中未更改任何内容,判定使用 5-95 百分位修剪。
其他说明
- 44 通道状态布局为 ActionNet 自有格式;手部 6 槽位为 DexHand 原始单位 [0, 10.3],非弧度
- 机器人模型
GR1T1_fourier_hand_6dof.urdf来自 FFTAI/teleoperation,未在本仓库再分发 - 100 个 episode 全部为羊角面包任务(3 种表达方式:55 个"Pick up the croissant and put it on a plate"、42 个"Put the croissant in the container"、3 个"Place the croissant into the container"),这是有意选择——单一物体便于建立过滤基准
- 共享掩码计算于去畸变后的针孔渲染上,非原始鱼眼坐标;直接叠加到原始
rgb.mp4上会在边缘产生 100 px 以上偏差