
遇见数据集

Manicule-NUBIS-Tapuscrit-FR_FRO_LAT

收藏
Hugging Face2026-07-04 更新2026-07-05 收录
官方服务:

资源简介:

Manicule-Tapuscrit-FR_FRO_LAT 是一个专为光学字符识别(OCR)模型训练而设计的数据集。它包含从 Nubis 目录中收集的手稿图像及其对应的文本。数据集涵盖了三种语言:法语(fr)、拉丁语(la)以及中古法语(fro)。数据规模在 1,000 到 10,000 个样本之间(1K<n<10K)。数据以图像到文本(image-to-text)的形式组织,适用于 OCR 相关的训练与评估任务。该数据集以 etalab-2.0(Licence Ouverte / Open Licence)许可证发布。此外,该数据集还提供了 PageXML 格式的版本,可通过指定链接获取。

Manicule-Tapuscrit-FR_FRO_LAT is a dataset specifically designed for training optical character recognition (OCR) models. It contains manuscript images and their corresponding texts collected from the Nubis catalog. The dataset covers three languages: French (fr), Latin (la), and Middle French (fro). The data size ranges from 1,000 to 10,000 samples (1K<n<10K). The data is organized in an image-to-text format, suitable for OCR-related training and evaluation tasks. The dataset is released under the etalab-2.0 (Licence Ouverte / Open Licence) license. Additionally, a version in PageXML format is provided and can be accessed via a specified link.

创建时间:
2026-06-26
原始信息汇总

数据集名称

Manicule-Tapuscrit-FR_FRO_LAT

数据集描述

该数据集专为光学字符识别(OCR)训练而设计,包含来自 Nubis 目录 的手稿资源。

语言

  • 法语(fr)
  • 拉丁语(la)
  • 古法语(fro)

许可协议

  • Licence Ouverte / Open Licence(etalab-2.0)

数据集大小

  • 样本数量:1,000 < n < 10,000

任务类型

  • 图像到文本(image-to-text)

数据集格式

该数据集也以 PageXML 格式提供,可通过以下链接获取: https://src.koda.cnrs.fr/lamop/Manicule-NUBIS-Tapuscrit-FR_FRO_LAT/
搜集汇总
数据集介绍
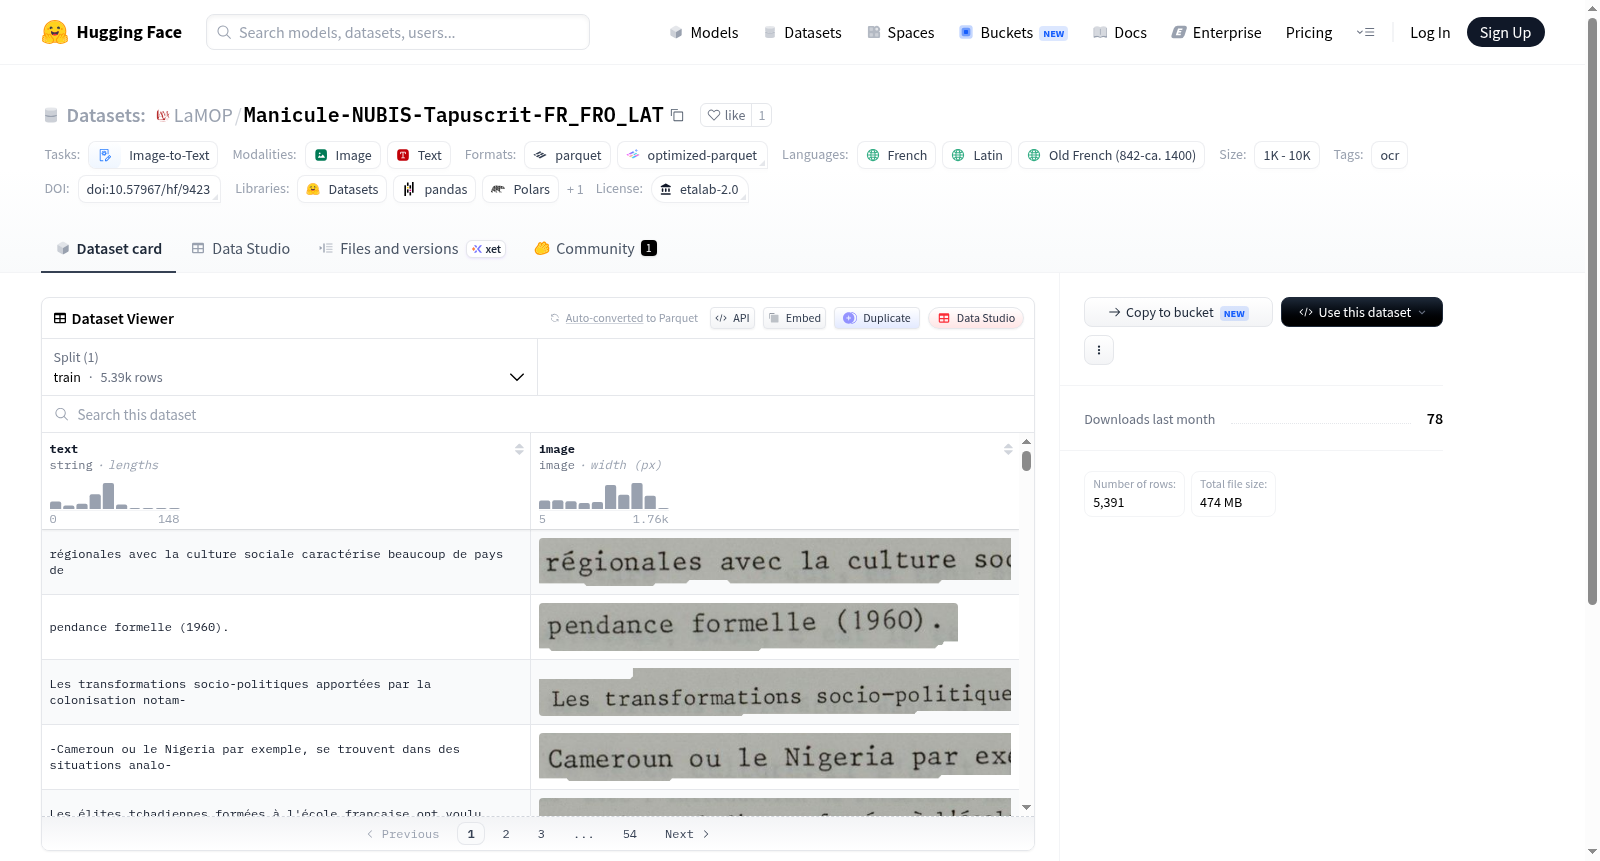
Manicule-NUBIS-Tapuscrit-FR_FRO_LAT 数据集图片
构建方式
该数据集针对光学字符识别(OCR)训练任务构建,其图像与文本语料源自Nubis目录(Nubis catalog),汇聚了丰富的法文、拉丁文及古法文手稿资源。数据集的制作遵循严谨的数字化流程,对原始手稿进行高精度扫描与转录,并辅以PageXML格式的标注文件,确保每幅图像与其对应的文本内容实现精确对齐,为模型学习跨语种与字体的文字形态提供了坚实基础。
特点
数据集涵盖法语(fr)、拉丁语(la)与古法语(fro)三种语言,具有鲜明的多语种与历史文献特征。其规模介于1千至1万条数据之间,虽为中等规模,但手稿来源的多样性与字迹风格的复杂性,使其在OCR模型训练中具备独特的挑战性与代表性。同时,数据集遵循Etalab 2.0开放许可协议,易于获取与使用,利于推动历史文档数字化研究。
使用方法
使用者可将此数据集直接应用于图像到文本(image-to-text)的OCR模型训练,如基于Transformer的视觉语言模型。推荐采用HuggingFace Datasets库加载数据,结合预处理步骤(如图像归一化与文本编码),构建训练管道。此外,PageXML格式的标注文件亦支持用户在外部工具(如OCR4all或Kraken)中开展微调或评估,以适应特定历史手稿的识别任务。
背景与挑战
背景概述
在古籍数字化与光学字符识别(OCR)技术迅猛发展的当下,多语言、多字体手写文本的自动转录成为数字人文领域的一大研究热点。Manicule-NUBIS-Tapuscrit-FR_FRO_LAT数据集应运而生,其创建依托于法国索邦高等实践研究学院(EPHE)旗下的Nubis目录数据库,由LAMOP实验室主导开发,旨在为中世纪法语(fro)、拉丁语(la)及现代法语(fr)手稿提供高质量的OCR训练素材。该数据集整合了来自Nubis数字图书馆的珍贵手稿图像与转录文本,规模介于1000至10000条样本之间,填补了面向中世纪多语种手稿OCR训练资源的空白,对推动古籍自动识别、古文字学及跨语言文献分析具有显著影响力。
当前挑战
该数据集面临的核心挑战包括:其一,中世纪手稿中复杂多变的连笔字、缩略词及装饰性字体显著增加了OCR模型的识别难度,且混合语种(法语、拉丁语及古法语)的频繁交替要求模型具备跨语言上下文理解能力。其二,数据构建过程中,手稿图像常因年代久远而存在褪色、墨迹渗化或纸张破损,导致字符边界模糊,同时Nubis目录中部分原始扫描件分辨率不一,需进行精细的图像预处理与对齐标注。此外,如何处理稀缺的高质量标注样本与模型泛化性之间的权衡,亦是该领域持续面临的实践困境。
常用场景
经典使用场景
Manicule-NUBIS-Tapuscrit-FR_FRO_LAT数据集专为光学字符识别(OCR)模型的训练而设计,其核心应用场景聚焦于古籍手稿的数字化转录。该数据集汇集了来自Nubis目录的中世纪与近代早期手稿,涵盖法语、拉丁语及古法语三种语言,为OCR领域提供了一个兼具语言多样性与历史文献特色的训练资源。研究者可借助该数据集训练高精度字符识别模型,尤其适用于处理带有特殊书写风格、缩略词及破损边缘的复杂手稿图像。通过该数据集,模型能够学习从图像到文本的映射关系,从而有效推动历史文献的自动化整理与数字化存档进程。
实际应用
在实际应用中,该数据集支撑了文化遗产数字化保护与知识传播的多个环节。图书馆与档案馆可依托基于此数据集训练出的OCR模型,将馆藏手稿快速转化为可搜索的电子文本,极大提升编目效率与用户访问体验。在数字出版领域,古籍数字化平台能利用该技术实现自动标注与跨库检索,降低人工校对成本。此外,该数据集还可服务于教育场景,例如历史课程中手稿的智能解读与翻译工具开发,使得非专业研究者也能便捷获取古代文本信息,从而扩展文化资源的普惠路径。
衍生相关工作
围绕该数据集已衍生出多项具有影响力的研究工作。首先,基于PageXML格式的标注数据,研究者发展出了针对手稿特定字体风格的细粒度OCR流水线,如结合卷积神经网络与序列标注模型的方法。其次,数据集所包含的法语与拉丁语混合语料,催生了面向低资源古语言的迁移学习研究,通过预训练语言模型微调提升转写质量。此外,该数据集还成为评估OCR模型对历史版面噪声鲁棒性的基准之一,相关成果常出现在国际文档分析与识别会议(如ICDAR)中。这些工作共同拓展了手稿数字化的技术边界,并反向推动了数据集本身的版本迭代与扩充。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

