
遇见数据集

ebixhaferaj/handwriting-signatures-dataset

收藏
Hugging Face2026-04-30 更新2026-05-03 收录
官方服务:

资源简介:

一个包含手写签名及文本提示的数据集,专为扩散模型的LoRA微调设计,用于生成逼真的个人签名。该数据集经过预处理,适用于签名验证和文本到图像任务。处理步骤包括标注、使用OpenCV进行预处理(清洁、裁剪、居中、调整大小至256×256)和手动过滤低质量样本。数据集结构包含.png格式的签名图像和metadata.jsonl注释文件。每个样本包含签名图像和描述签名的文本提示。数据集基于CC-BY-NC-4.0许可证,仅限非商业用途。

A dataset of handwritten signatures with text prompts, designed for LoRA fine-tuning of diffusion models to generate realistic personal signatures. This dataset contains preprocessed handwritten signatures designed for signature verification and LoRA fine-tuning of diffusion models (e.g., Stable Diffusion) for text-to-image tasks. Processing steps include labeling, preprocessing with OpenCV (cleaning, cropping, centering, resizing to 256×256), and manual filtering of low-quality samples. The dataset structure includes .png files for signature images and metadata.jsonl for annotations. Each sample contains an image and a text prompt describing the signature. The dataset is licensed under CC-BY-NC-4.0 for non-commercial use only.
提供机构:
ebixhaferaj
搜集汇总
数据集介绍
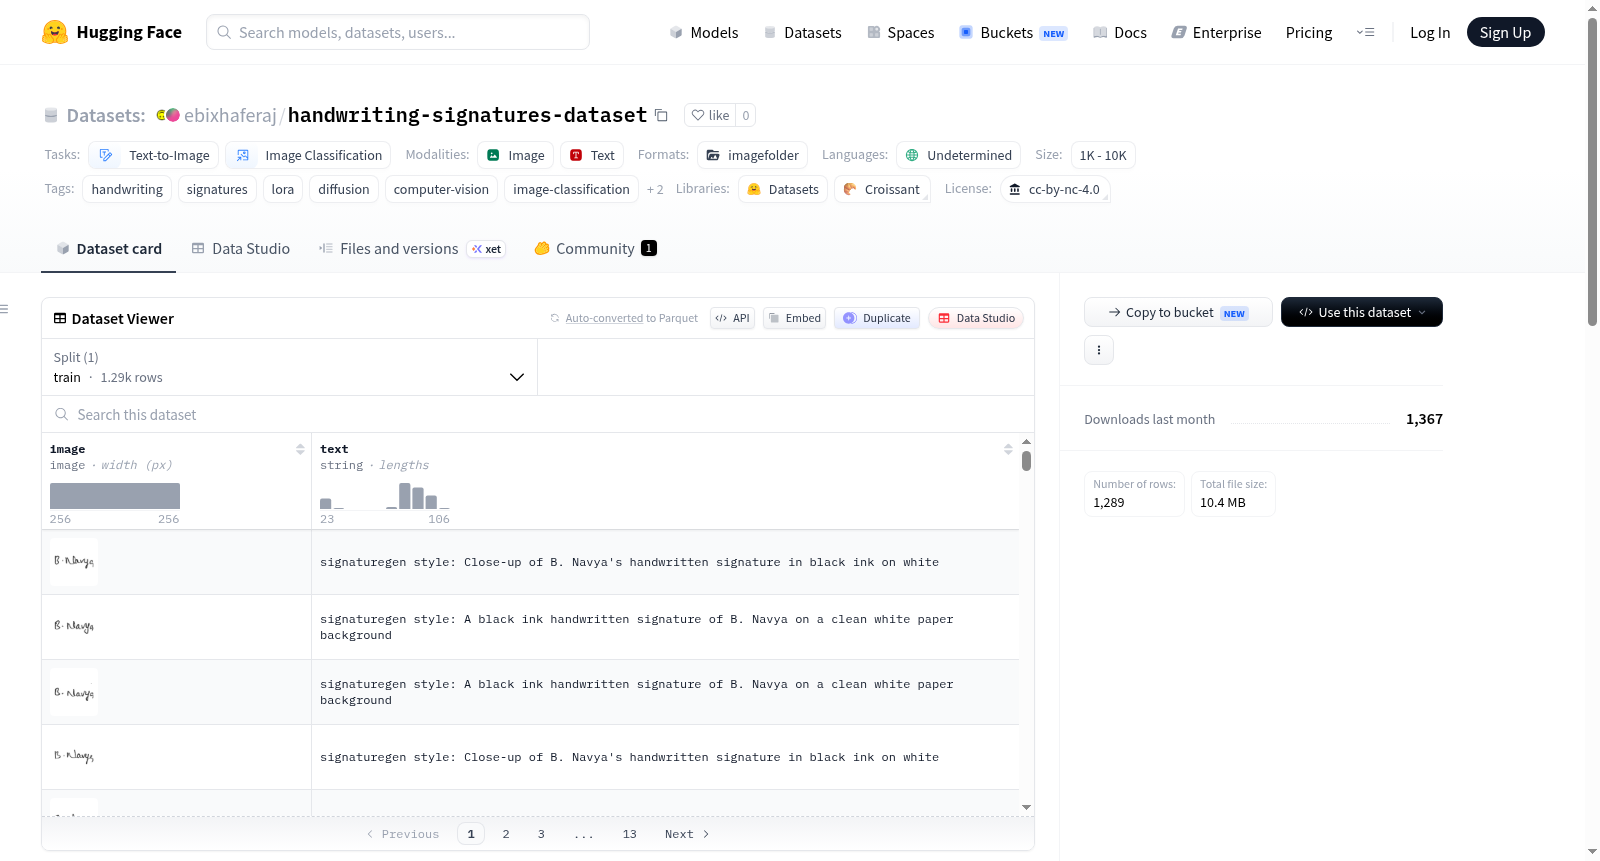
ebixhaferaj/handwriting-signatures-dataset 数据集图片
构建方式
该数据集源自Kaggle上的签名验证数据集,经过系统化的预处理流程构建而成。首先,借助计算机视觉与人工智能模型对原始手写签名图像进行自动标注,依据签署人姓名将其分组归类。随后,利用OpenCV库执行一系列图像清洗操作,包括裁剪、居中及尺寸调整,最终统一缩放至256×256像素分辨率。最后,通过人工筛选剔除低质量或噪声样本,确保数据集的纯净度与可用性。所有图像以PNG格式存储,并配套提供metadata.jsonl文件,记录每张图像对应的文本标签。
特点
该数据集专为手写签名生成与验证任务设计,兼具文本到图像生成与图像分类的双重任务属性。其核心特点在于每张签名图像均关联一条描述性文本提示,例如“Close-up of B. Navya's handwritten signature in black ink on white”,这使得数据集能够直接用于LoRA微调扩散模型(如Stable Diffusion),以生成逼真的个性化签名。数据集规模介于1000至10000个样本之间,采用CC-BY-NC-4.0非商业许可协议,确保研究用途的合规性。
使用方法
使用者可通过HuggingFace的datasets库便捷加载该数据集,代码示例为:`ds = load_dataset("sl4shuur/handwriting-signatures-dataset", split="train")`。每个样本包含两个字段:`image`字段提供PIL图像对象,为256×256像素的签名图像;`text`字段提供对应的文本提示。该设计既适用于文本到图像生成任务的训练与推理,也支持图像分类任务中签名风格的识别与验证。研究者在进行LoRA微调时,可直接将文本提示作为条件输入,驱动扩散模型生成具有特定签名风格的新图像。
背景与挑战
背景概述
手写签名作为生物特征识别的重要载体,在金融、法律及身份认证领域具有不可替代的地位。基于深度学习的签名验证与生成技术近年来受到广泛关注,然而高质量、标准化的签名数据集仍相对匮乏。该数据集由研究者sl4shuur于近年创建,源自Kaggle上的签名验证数据集,经过精细预处理与手工筛选,最终形成包含数千张256×256像素签名图像的数据集。其核心研究问题在于为图像分类与文本到图像生成任务提供结构化训练资源,尤其是支持LoRA微调的扩散模型以生成逼真的个性化签名。该数据集通过规范化处理与文本标注,在签名验证、合成与数据增强等领域具备显著的推动价值,降低了生成式模型在签名任务中的门槛。
当前挑战
当前数据集面临多重挑战。首先,在领域问题层面,签名验证与生成的复杂性体现在笔迹风格的细微差异与仿冒难度,现有模型需要应对高内类相似性与跨个体差异之间的平衡,而数据集的规模有限(1K至10K样本)可能限制模型泛化能力。其次,在构建过程中,原始数据的噪声与标签不确定性是重大障碍:预处理依赖计算机视觉与AI模型进行自动标注,难以完全消除误分类;手工过滤虽能提升质量,却降低了数据规模且引入了主观偏差。此外,图像尺寸统一为256×256可能丢失关键笔触细节,影响生成签名的真实性。数据集的非商业许可也限制了其在工业场景中的广泛应用与迭代优化。
常用场景
经典使用场景
该数据集专为手写签名图像的生成与验证任务而构建,是文本到图像生成与图像分类两大领域的交叉典范。在文本到图像方面,它支持通过LoRA微调稳定扩散模型来逼真地生成个性化签名;在图像分类方面,则可用于签名真伪鉴别的监督学习与对比学习。数据集中每个样本均包含清晰的手写签名图像及其对应的文本提示(如“B. Navya的黑墨白纸手写签名特写”),这种图文对齐的设计使其成为少样本生成、个性化内容合成以及细粒度图像表征学习的理想训练资源。
实际应用
在实际应用中,该数据集可用于银行、金融与电子合同平台中自动签名验证系统的模型训练,辅助提升伪造签名的识别准确率。同时,借助文本到图像的生成能力,它能够为数字签名设计、个性化电子印章制作提供可控的自动生成工具。在办公自动化与数字化身份认证场景中,该数据集支撑了基于扩散模型的签名生成与防伪技术落地,为无纸化流程中的安全稽核与文书溯源提供了高效的技术路径。
衍生相关工作
该数据集的衍生工作主要集中在两个方向:一是基于扩散模型的签名生成与编辑研究,如利用LoRA参数高效微调实现不同书写风格的签名合成,以及结合文本引导的多模态签名样式迁移;二是将生成式签名作为数据增强手段,提升传统签名验证模型的泛化能力与对抗鲁棒性。此外,部分工作探索了将签名图像与笔迹时序信息结合的多模态模型,以及利用对比学习从生成签名中提取更具判别力的笔迹特征,进一步拓展了手写签名分析与合成的研究边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

