
mkd-hossain/keural-dpo-merged
收藏官方服务:
资源简介:
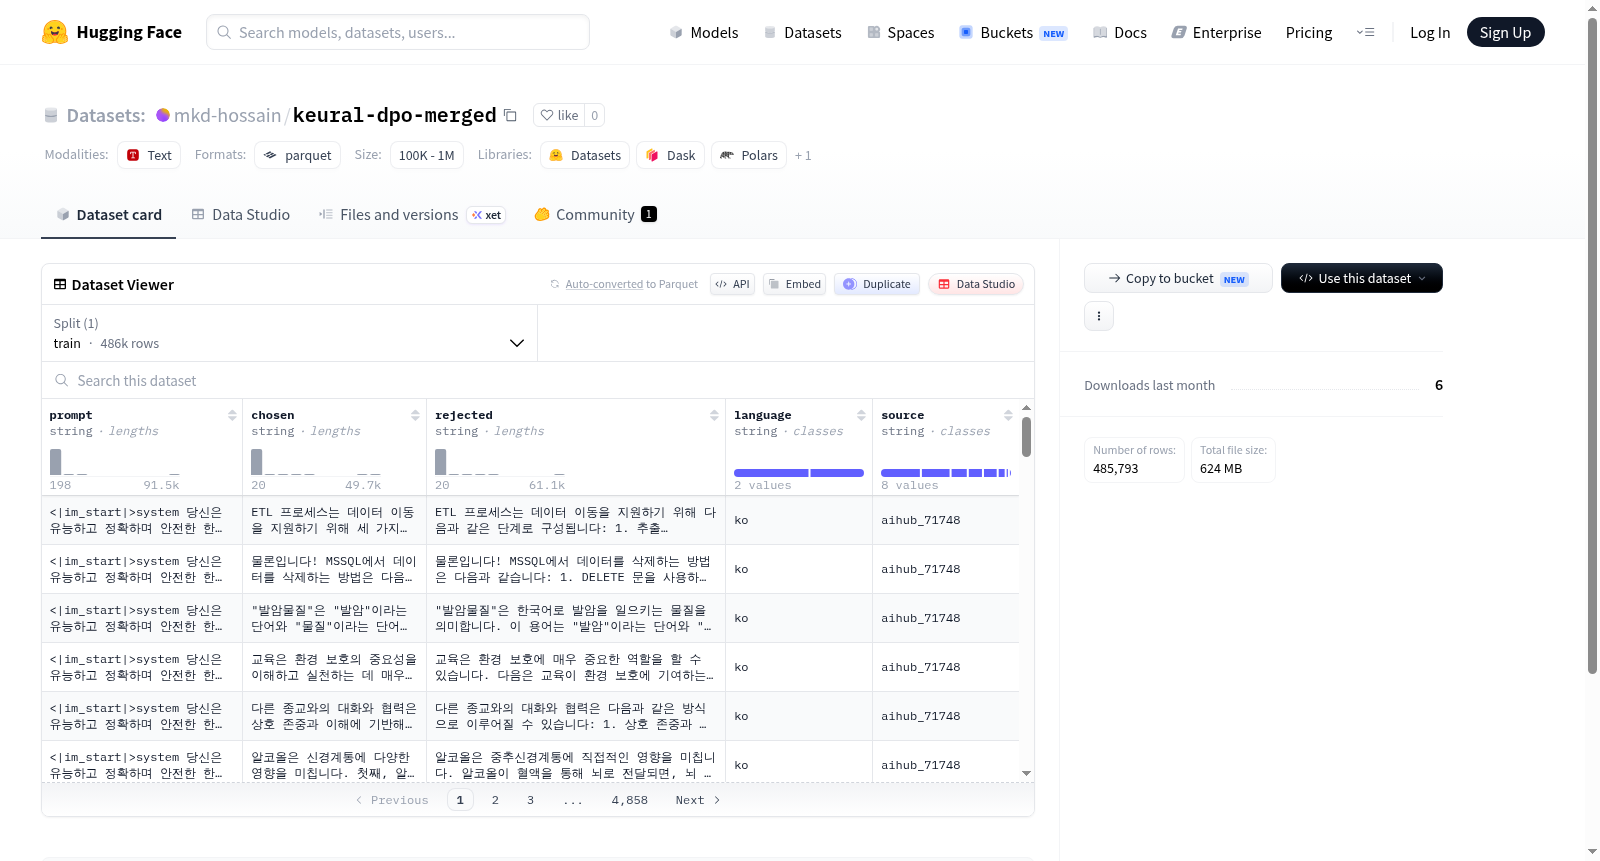
该数据集包含用于偏好对齐的样本,每条记录包括一个提示(prompt)、一个被选中的回复(chosen)和一个被拒绝的回复(rejected),以及语言和来源信息。训练集共有485793个样本。
This dataset contains samples for preference alignment, each record includes a prompt, a chosen response, a rejected response, along with language and source information. The training set contains 485,793 samples.
提供机构:
mkd-hossain搜集汇总
数据集介绍
构建方式
keural-dpo-merged数据集是基于多源偏好数据融合构建的大规模韩语偏好对齐数据集,其构建过程遵循DPO(Direct Preference Optimization)方法的范式,收录了约48.6万条训练样本。每条数据包含四个核心字段:'prompt'字段承载模型输入指令,'chosen'与'rejected'字段分别对应人类偏好的优劣响应,'language'字段明确标注韩语属性,'source'字段则追溯数据来源,确保了数据溯源的可信度与领域覆盖的多样性。
特点
该数据集最显著的特征在于其规模与结构化程度:总数据量达1.3GB的压缩体量(约623MB下载量)使其成为当前韩语偏好领域的标杆资源。其双响应对比设计天然适配DPO或RLHF(基于人类反馈的强化学习)训练框架,能够高效驱动语言模型进行价值观对齐。四个字段的清晰分离(prompt、chosen、rejected、language、source)不仅简化了预处理流程,更通过'language'字段的独特性聚焦于韩语场景,为低资源语言的偏好学习提供了高质量基准。
使用方法
实际应用时,研究者可通过HuggingFace Datasets库直接加载该数据集,使用以下代码即可获取标准化格式的训练数据:`from datasets import load_dataset; dataset = load_dataset('keural-dpo-merged', split='train')`。模型训练过程中,每条数据需以'chosen'字段作为正例、'rejected'字段作为负例输入DPO损失函数,同时保留'prompt'字段作为条件输入。需注意数据已预先划分为单一训练集(train),无需额外拆分,可直接用于微调开源大语言模型在韩语偏好对齐任务中的表现。
背景与挑战
背景概述
在自然语言处理与强化学习交叉研究的前沿领域中,基于人类反馈的强化学习(RLHF)已成为对齐大型语言模型与人类偏好的一种关键技术。在此背景下,由多个研究机构联合构建的keural-dpo-merged数据集于近年诞生,旨在通过直接偏好优化(DPO)范式,将人类偏好信号融入模型微调过程。该数据集汇集了近48.6万条训练样本,每条样本包含提示(prompt)、正向选择(chosen)与负向拒绝(rejected)文本对,覆盖多语言来源,显著扩展了偏好数据的规模与多样性。其发布为语言模型在安全性、有用性和价值对齐方面的研究提供了新的基准资源,推动了偏好学习方法的标准化与实证评估。
当前挑战
keural-dpo-merged数据集所面临的挑战主要体现在两个层面。首先,在领域问题层面,偏好数据集的构建本质上需解决语言模型中主观价值判断的量化难题——如何从海量生成文本中精准捕捉人类偏好的细微差异,避免引入单一文化或群体的偏见。其次,在构建过程中,数据来源的异构性导致标签一致性难以保证,例如不同语言或领域下的正/负样本划分标准可能存在冲突。此外,数据集中近50万条实例的规模虽大,但缺乏独立验证集与测试集,不利于模型泛化能力的系统评估与跨数据集间的公平比较。
常用场景
经典使用场景
在强化学习与人类偏好对齐的研究浪潮中,keural-dpo-merged数据集以其大规模、多源头的特性,成为训练偏好对齐模型的基石。该数据集涵盖了近49万条样本,每条样本包含提示词、优选回答与拒绝回答,完美适配直接偏好优化(DPO)算法的需求。研究者通过该数据集,能够高效地微调大规模语言模型,使其生成内容更贴近人类的价值观与偏好,从而在文本生成质量、有害内容规避等维度实现显著跃升。
衍生相关工作
该数据集催生了一系列关于偏好对齐效率与泛化能力的探索性工作。研究者基于其多源特性,提出了跨领域偏好迁移学习框架,验证了在单一领域训练的DPO模型可以零样本适配新领域。另有工作聚焦于数据质量对对齐效果的影响,通过过滤keural-dpo-merged中的噪声样本,优化了奖励信号的准确度。此外,针对其语言多样性,衍生出多语言偏好蒸馏方法,使得小规模模型也能继承大模型的对齐能力,推动了轻量化对齐技术的发展。
数据集最近研究
最新研究方向
在自然语言处理领域,偏好对齐技术正成为大语言模型与人类价值观契合的关键路径。keural-dpo-merged数据集汇聚了约48.6万条高质量偏好对样本,涵盖多语言来源的提示与回应对比数据,为直接偏好优化(DPO)等前沿方法提供了坚实的训练基石。该数据集的出现,使得研究者能够在大规模、多样化的场景中探究模型偏好学习的内在机理,尤其聚焦于消除生成偏见、提升回答安全性与指令跟随能力。其融合多元语言与来源的设计,更推动了跨文化语境下对齐研究的深化,对于构建可信、可控的生成式AI系统具有重要的实践意义。
以上内容由遇见数据集搜集并总结生成


