遇见数据集

OATML-Markslab/ProteinGym

收藏
Hugging Face2022-07-29 更新2024-03-04 收录
官方服务:

资源简介:

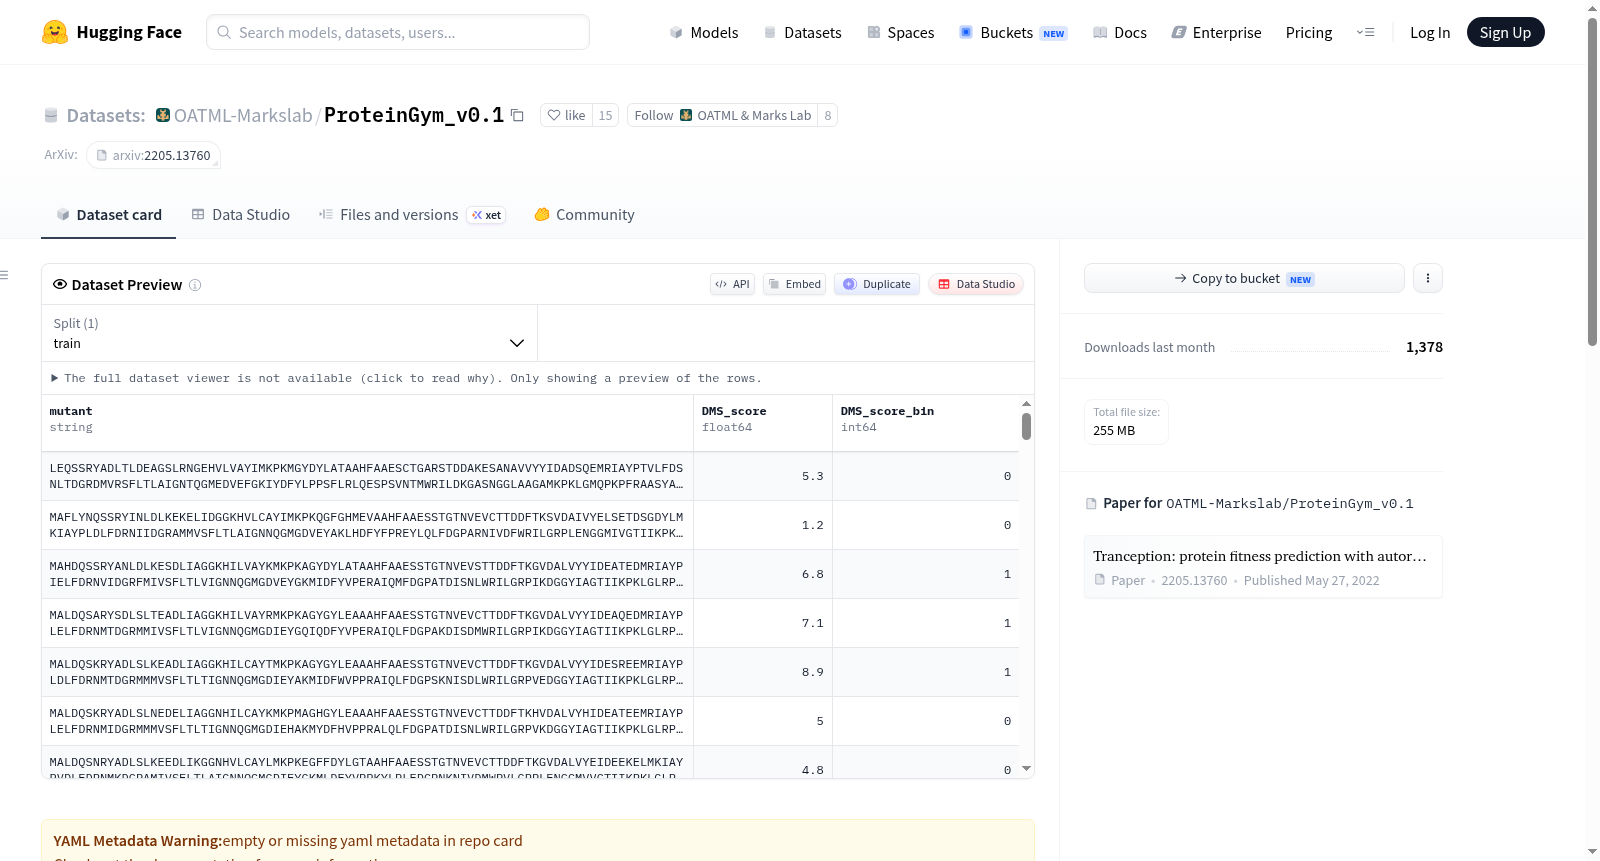
ProteinGym数据集是一个广泛的深度突变扫描(DMS)实验集合,用于比较不同突变效应预测器在不同条件下的表现。数据集包含两个基准:1)替换基准,包含87个DMS实验中的约150万个错义变体的实验特征;2)插入/删除基准,包含7个DMS实验中的约30万个突变体。每个基准中的处理文件对应一个DMS实验,并包含三个变量:突变体、DMS_score和DMS_score_bin。此外,还提供了两个参考文件,进一步详细说明了每个实验的细节。

The ProteinGym dataset is a comprehensive collection of deep mutational scanning (DMS) experiments, developed to compare the performance of various mutation effect predictors across diverse experimental conditions. The dataset includes two benchmark sets: 1) The substitution benchmark, which encompasses experimental features of approximately 1.5 million missense variants across 87 distinct DMS experiments; 2) The insertion/deletion (indel) benchmark, which contains roughly 300,000 mutants from 7 DMS experiments. Processing files within each benchmark correspond to one individual DMS experiment, and include three core variables: mutant, DMS_score, and DMS_score_bin. Additionally, two reference files are provided to further elaborate on the detailed information of each individual experiment.

提供机构:
OATML-Markslab
原始信息汇总

数据集概述

ProteinGym 是一个包含深度突变扫描(DMS)测定的综合数据集,旨在比较不同突变效应预测器在不同条件下的表现。该数据集由两个基准组成:

  1. 替代基准:包含约1.5M错义变异在87个DMS测定中的实验表征。
  2. 插入缺失基准:包含约300k变异在7个DMS测定中的数据。

数据集内容

每个处理过的文件对应一个单独的DMS测定,并包含以下三个变量:

  1. mutant (字符串):
    • 对于替代基准,描述了在参考序列上应用的替代集合以获得突变序列。
    • 对于插入缺失基准,对应于完整的突变序列。
  2. DMS_score (浮点数): 表示DMS测定中的实验测量值,所有测定中DMS_score值越高,突变蛋白的适应性越高。
  3. DMS_score_bin (整数): 指示DMS_score是否高于适应性阈值(1表示适应,0表示不适应)。

参考文件

数据集提供了两个参考文件:

  • ProteinGym_reference_file_substitutions.csv
  • ProteinGym_reference_file_indels.csv

这些文件提供了每个测定的详细信息,包括:

  • 对应的蛋白质的UniProt_ID、分类和MSA深度类别。
  • 测定中使用的目标序列(target_seq)。
  • DMS_score从原始文件创建和二值化的详细信息。
搜集汇总
数据集介绍
OATML-Markslab/ProteinGym 数据集图片
构建方式
ProteinGym数据集由OATML-Markslab构建,旨在系统评估蛋白质突变效应预测器的性能。其构建基于两大基准:替代基准涵盖87个深度突变扫描(DMS)实验,包含约150万个错义突变体;插入缺失基准则整合7个DMS实验,涉及约30万个突变体。每个处理文件对应单一DMS实验,记录突变序列、实验测量的适应度得分(DMS_score)及其二值化分类标签。此外,提供两个参考文件,详述每个实验的UniProt ID、目标序列、分类学信息及得分来源与二值化方法。
特点
该数据集的显著特点在于其规模庞大且覆盖全面,整合了多个物种和突变类型,包括错义突变与插入缺失突变。每个实验均提供标准化变量,如突变字符串、连续型适应度得分及二值化标签,便于跨实验比较。参考文件进一步补充了蛋白质的UniProt ID、序列深度类别等元数据,增强了数据集的解释性和可复用性。这种结构使得ProteinGym成为评估突变效应预测模型在多样化条件下性能的权威基准。
使用方法
使用ProteinGym时,用户可直接加载每个DMS实验的处理文件,提取突变序列、DMS_score及二值化标签进行模型训练或评估。对于替代基准,突变字符串需解析为氨基酸替换操作;对于插入缺失基准,则直接使用完整突变序列。参考文件提供了实验细节,可用于过滤或分组分析。建议结合Tranception等预测框架,将DMS_score作为目标变量,通过回归或分类任务衡量模型预测能力。数据集已开源在HuggingFace,便于集成到现有工作流中。
背景与挑战
背景概述
蛋白质功能预测是计算生物学与机器学习交叉领域的核心议题,其研究进展直接关乎药物发现、酶工程及疾病机制解析等关键应用。在此背景下,牛津大学OATML实验室与Marks实验室于2022年联合发布了ProteinGym基准数据集,该工作由Pascal Notin领衔,相关成果发表于ICML 2022。ProteinGym旨在系统性地评估不同突变效应预测方法在多样化实验条件下的表现,涵盖约150万错义变异与30万插入缺失突变数据,分别来源于87项和7项深度突变扫描实验。该数据集通过统一处理流程整合了跨物种、跨功能类别的实验数据,为比较自回归Transformer(如Tranception)与传统预测工具提供了标准化评价平台,显著推动了蛋白质适应性景观建模领域的方法学发展。
当前挑战
ProteinGym所应对的核心挑战在于弥合计算预测与实验验证之间的鸿沟。在领域层面,蛋白质突变效应预测长期受困于数据稀疏性与实验条件异质性,不同DMS实验采用的筛选阈值、测量指标及序列背景差异巨大,导致跨实验比较缺乏统一基准。在构建过程中,团队面临三大技术难题:其一,需从分散的原始文献中提取并标准化87项独立实验的突变数据,确保序列命名规则与评分体系的一致性;其二,针对插入缺失突变,需设计区别于点突变的表示方案(如直接存储全长突变序列);其三,需建立合理的二值化阈值以区分功能性与非功能性突变,同时保留连续DMS评分以支持回归任务。这些挑战使得ProteinGym成为检验预测模型泛化能力的关键试金石。
常用场景
经典使用场景
ProteinGym数据集整合了来自深度突变扫描实验的大规模蛋白质变异效应数据,涵盖约150万个错义突变和30万个插入缺失突变,横跨近百种不同的蛋白质功能测定。研究者借助该基准,能够系统性地评估与比较各类蛋白质突变效应预测方法,包括基于进化保守性的传统统计模型、基于深度学习的序列模型,以及近年来兴起的蛋白质语言模型。该数据集在变异类型全面性与实验多样性上具有显著优势,为理解基因型与表型之间的复杂映射关系提供了坚实的实验基础。
解决学术问题
ProteinGym的构建直指计算生物学中一个核心难题:如何准确预测蛋白质突变对功能活性的影响。此前,由于缺乏大规模、标准化且覆盖多种蛋白质家族的基准测试集,不同预测方法之间的性能比较往往不可靠,难以客观评估模型优劣。该数据集通过统一处理来自87个DMS实验的突变效应数据,并引入二值化适应度标签,使研究者能够量化模型在零样本预测、跨蛋白质泛化以及稀有突变预测等场景下的表现,从而推动了对突变效应预测范式从经验规则向数据驱动方法的根本性转变。
衍生相关工作
ProteinGym的问世催生了一系列具有影响力的后续研究。其原始论文中提出的Tranception模型,通过结合自回归变换器与推理时检索机制,在突变效应预测上取得了显著突破,成为该领域的基线方法之一。随后,基于ProteinGym基准,研究者开发了诸如ESM-1v、ESM-2等蛋白质语言模型的变异预测变体,并系统评估了零样本突变效应预测能力。此外,该数据集还被广泛用于验证基于结构信息的预测方法,如利用AlphaFold预测的蛋白质结构作为输入来提升突变效应估计的准确性,进而推动了结构与序列联合建模方向的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务