GPT-5.6-luna-reasoning-102881x
收藏资源简介:
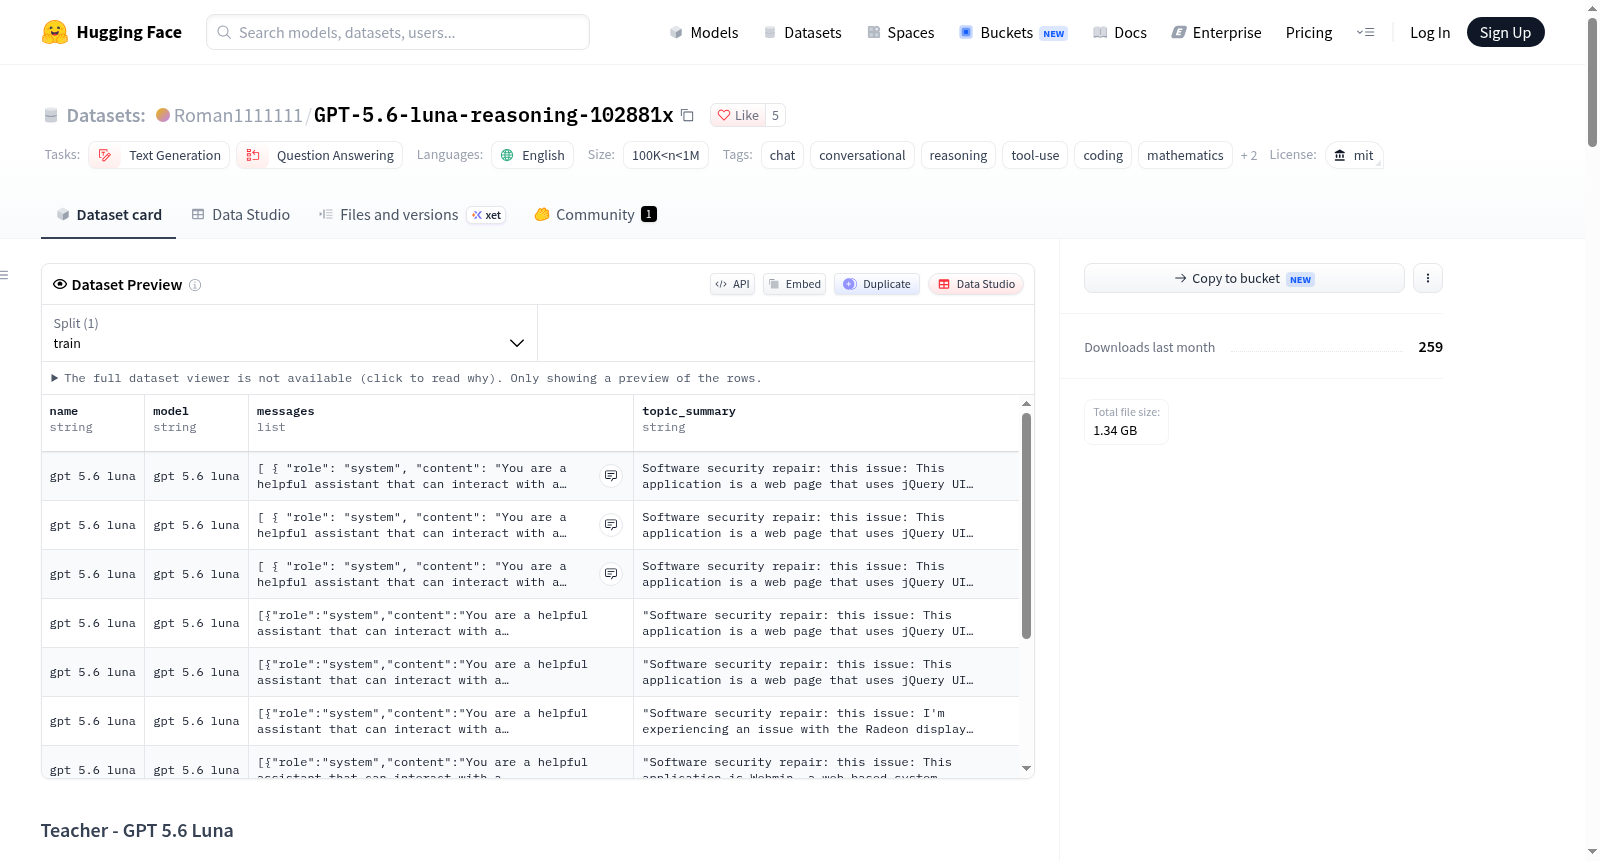
GPT 5.6 Luna 是一个高质量、多领域的对话训练数据集,专注于推理、数学、STEM、Python编程、软件安全和工具使用。数据集由创建者通过 API 生成,总成本为 164 美元(另有 80 美元用于代码生成)。包含 102,881 条对话,总大小约 1.27 GiB。每条数据采用 Hugging Face 对话格式,包含有序的对话消息列表(messages)以及可选的工具定义(tools)和元数据(metadata)。此外,每条数据还包含一个简短的 topic_summary 字段,用于过滤、分析和课程设计。数据集涵盖数学推理(逐步求解)、STEM 技术问题、Python 实现任务、软件安全调试与修复轨迹、以及多轮工具调用对话。适用于监督式对话微调、数学与 STEM 推理、Python 代码生成、多轮工具使用行为、安全修复轨迹以及基于主题的采样和课程设计等研究和实验任务。需要注意的是,数据集由 API 生成,可能存在错误,推理轨迹可能冗长或不一致,主题摘要为启发式生成,领域分布不均衡,且未进行去重、去污染、毒性审核或基准重叠分析。
GPT 5.6 Luna is a high-quality, multi-domain conversation training dataset focused on reasoning, mathematics, STEM, Python programming, software security, and tool use. The dataset was generated by the creator via API, with a total cost of $164 (plus $80 for code generation). It contains 102,881 conversations, with a total size of approximately 1.27 GiB. Each data entry follows the Hugging Face conversation format, including an ordered list of conversation messages (messages) alongside optional tool definitions (tools) and metadata (metadata). Additionally, each entry includes a short topic_summary field for filtering, analysis, and curriculum design. The dataset covers mathematical reasoning (step-by-step solutions), STEM technical problems, Python implementation tasks, software security debugging and repair traces, and multi-turn tool-calling conversations. It is suitable for research and experimental tasks such as supervised conversational fine-tuning, mathematical and STEM reasoning, Python code generation, multi-turn tool-use behavior, security repair traces, and topic-based sampling and curriculum design. Note that the dataset is API-generated and may contain errors; reasoning traces may be lengthy or inconsistent; topic summaries are heuristically generated; domain distribution is imbalanced; and no deduplication, decontamination, toxicity review, or benchmark overlap analysis has been performed.
数据集概述
GPT 5.6 Luna 是一个由数据集创建者独立生成的高质量多领域对话训练数据集,专注于推理、数学、STEM、Python 编程、软件安全及工具使用。该数据集通过 API 生成,总生成成本为 $164。
基本信息
- 规模: 102,881 条对话记录(约 1.27 GiB)
- 语言: 英语
- 任务类别: 文本生成、问答
- 标签: 对话、推理、工具使用、编程、数学、STEM、网络安全
- 数据格式: JSONL(每行一个 JSON 对象),符合 Hugging Face 对话
messages格式
内容领域
| 领域 | 内容 |
|---|---|
| 数学推理 | 逐步解题与答案生成 |
| STEM | 跨科学学科的技术问题 |
| Python | 实现任务、推理及完整代码 |
| 软件安全 | 调试、漏洞分析与修复轨迹 |
| 工具使用 | 包含结构化工具调用与响应的多轮对话 |
数据格式
每个 JSON 对象包含以下核心字段:
name: 数据集标签,固定为gpt 5.6 lunamessages: 有序的 Hugging Face 对话消息列表topic_summary: 该行的简要主题描述,用于筛选与分析tools(可选): 原始工具定义metadata(可选): 额外构建与示例元数据
支持工具调用的示例可能包含顶层的 tools 数组以及带有 tool_calls 或 tool 角色的消息。
使用方式
- 加载: 可通过 Hugging Face
datasets库的load_dataset函数加载 JSONL 文件。 - 聊天模板: 可使用
transformers库的AutoTokenizer.apply_chat_template渲染消息,但需注意不同模型家族的聊天模板差异,尤其在处理工具调用记录时。
主题摘要说明
topic_summary 值通过本地确定性、抽取式规则生成,优先使用现有的学科、主题、领域、函数名、数据集来源和用户请求字段,不依赖外部模型或 API,构建过程可复现。这些摘要适用于导航和粗略筛选,而非作为真实标签。
预期用途
该数据集适用于研究及实验,包括:
- 监督式聊天微调
- 数学与 STEM 推理
- Python 代码生成
- 多轮工具使用行为
- 安全修复轨迹
- 基于主题的采样与课程设计
局限性
- 数据集为 API 生成,以质量为导向,但个别答案可能仍存在错误。
- 推理轨迹可能冗长、不一致,或不适合直接用于生产环境。
- 主题摘要为启发式生成,可能遗漏部分细节。
- 各领域及回答风格分布不均,数学内容占多数。
- 工具模式与调用格式在不同示例间可能不同。
- 未声明进行去重、去污染、毒性审计或基准重叠分析。
用户应根据自身模型与部署场景评估数据的质量、安全性与适用性。