shorthand-agent-comm
收藏资源简介:
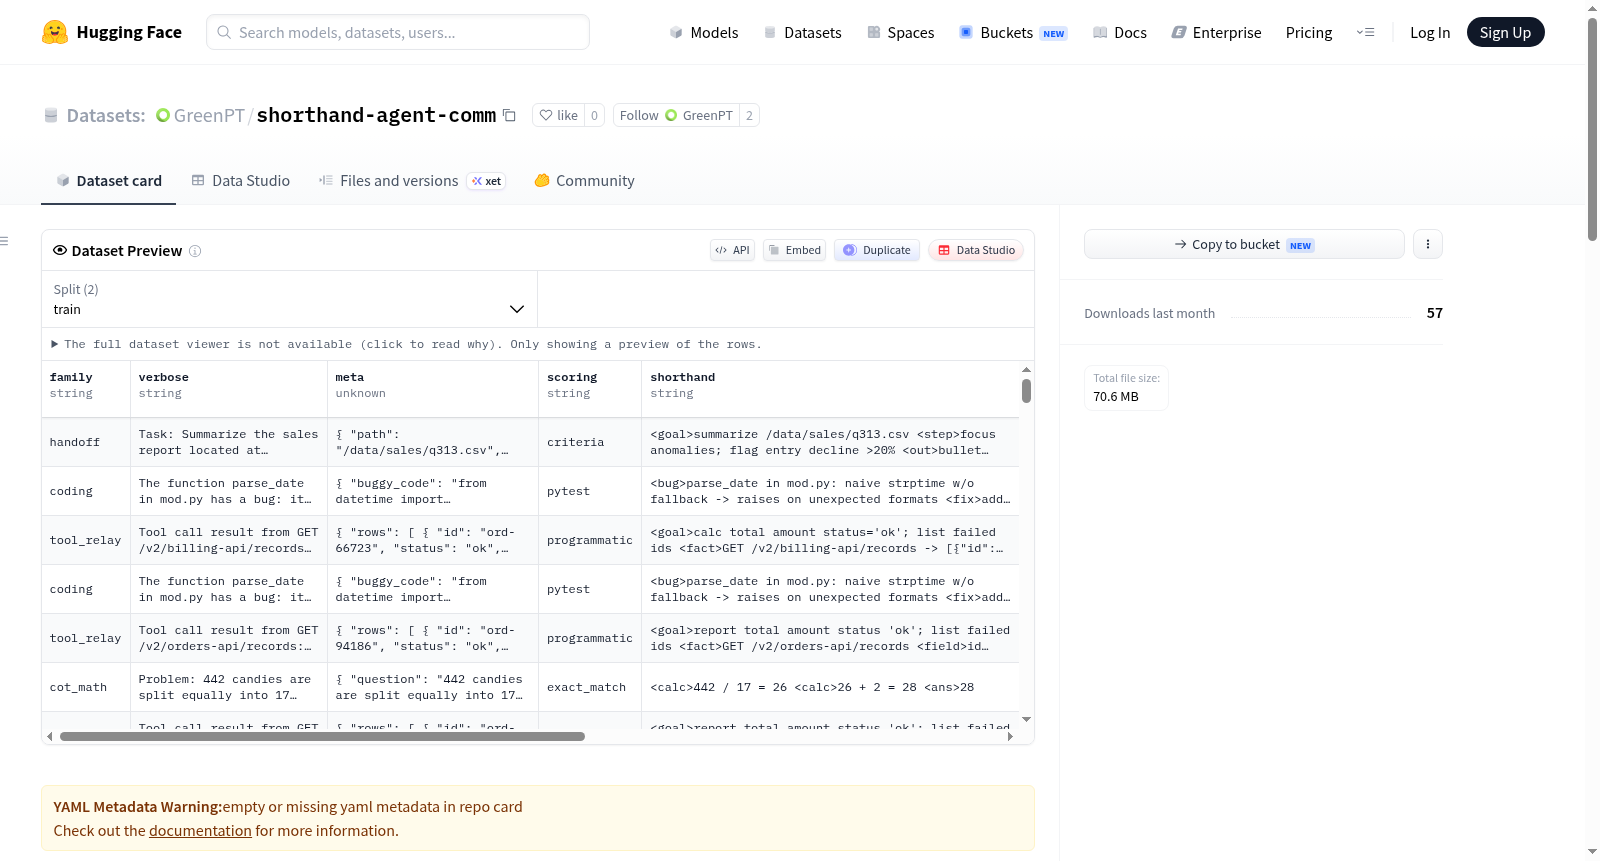
该数据集用于训练 Qwen3.5-9B 代理(通过 LoRA 微调)以在简略的已学习插槽标记简写中通信。数据集包含 v4 架构的轨迹数据:翻译器(translator)将英文任务转换为 slot-marker 简写规范,工作器(worker)执行 agentic 循环(读/编辑/测试/完成),然后翻译器将简写报告转换为英文摘要。数据规模为 2,883 条轨迹(有效性 92-98%),其中 195 条作为保留集。训练数据包括 v4_worker_train.jsonl(11,532 行)和 v4_translator_train.jsonl(8,649 行)。此外还包含 v1/v3 版本的训练和评估数据(如 real_*.jsonl、eval_*.jsonl、train_pairs.jsonl 等),以及生成脚本、验证模式和基准测试代码。该数据集适用于训练基于简写通信的代理模型,特别适合需要高效 token 消耗的任务执行场景(中位数 1.3-2.5k tokens/任务)。
This dataset is used to train the Qwen3.5-9B agent (via LoRA fine-tuning) to communicate in a concise learned slot-marker shorthand. The dataset contains trajectory data of the v4 architecture: a translator converts English tasks into slot-marker shorthand specifications, a worker executes an agentic loop (read/edit/test/complete), and then the translator converts the shorthand report into an English summary. The data scale is 2,883 trajectories (validity 92-98%), with 195 as a holdout set. Training data includes v4_worker_train.jsonl (11,532 lines) and v4_translator_train.jsonl (8,649 lines). Additionally, it contains training and evaluation data for v1/v3 versions (e.g., real_*.jsonl, eval_*.jsonl, train_pairs.jsonl, etc.), as well as generation scripts, validation patterns, and benchmark code. This dataset is suitable for training agent models based on shorthand communication, especially for task execution scenarios requiring efficient token consumption (median 1.3-2.5k tokens/task).
数据集概述:shorthand-agent-comm
项目背景
该数据集服务于 trained shorthand 项目,旨在通过LoRA微调Qwen3.5-9B智能体,使其能够使用一种简洁的学习型槽标记(slot-marker)简写语言进行通信。
v4架构(当前版本)
系统采用三段式流水线架构:
- 翻译器 (TRANSLATOR):
GreenPT/shorthand-translator-v4,将英文任务转换为槽标记简写规范 - 工人 (WORKER):
GreenPT/shorthand-worker-v4,以简写原生智能体循环运行,在pytest沙箱中执行读/编辑/测试/完成操作 - 翻译器回译:将简写完成报告转换为英文摘要
数据构成
- 总轨迹数:2,883条(有效性92–98%)
- 保留数据:195条独立任务
训练数据文件
| 文件 | 内容 |
|---|---|
v4_traj_raw.jsonl |
原始v4轨迹数据 |
v4_worker_train.jsonl |
工人角色训练数据,共11,532行 |
v4_translator_train.jsonl |
翻译器角色训练数据,共8,649行 |
v4_heldout_*.jsonl |
195条保留测试任务 |
其他数据文件
real_*.jsonl:v3真实任务评估数据eval_*.jsonl、train_pairs.jsonl、reader_train*.jsonl、encoder_train_v3.jsonl:v1/v3训练及评估数据
模型与训练细节
- 教师模型:
Qwen/Qwen3.5-397B-A17B(通过HF Inference Providers的:deepinfra路由) - 微调方式:LoRA(r=64,3轮训练,bf16精度,包含分词器)
- 验证结果:20任务烟雾测试中成功率100%,每个任务中位token消耗1.3–2.5k
成本统计(v4,第三轮)
| 项目 | 金额 |
|---|---|
| 教师API(397B生成) | $1.68 |
| GPU(a100-large) | ~$7 |
| 第三轮总计 | ≈ $9 |
| 项目GPU总成本 | ≈16个a100小时 ≈ $40 |
脚本与工具
gen_v4.py:v4数据生成器schema.py:简写验证模块loop_bench.py:循环基准测试run_*.py、train_sft.py:评估运行器与SFT训练脚本swe_harness.py:SWE-bench测试框架
使用说明
详细使用方法请参考代码仓库中的GUIDE.md文件,或访问GreenPT/trained-shorthand-report获取完整报告。仓库提供了基于peft库的快速加载示例,支持动态切换翻译器与工人两个适配器。