llm-xray-lesion-scans
收藏资源简介:
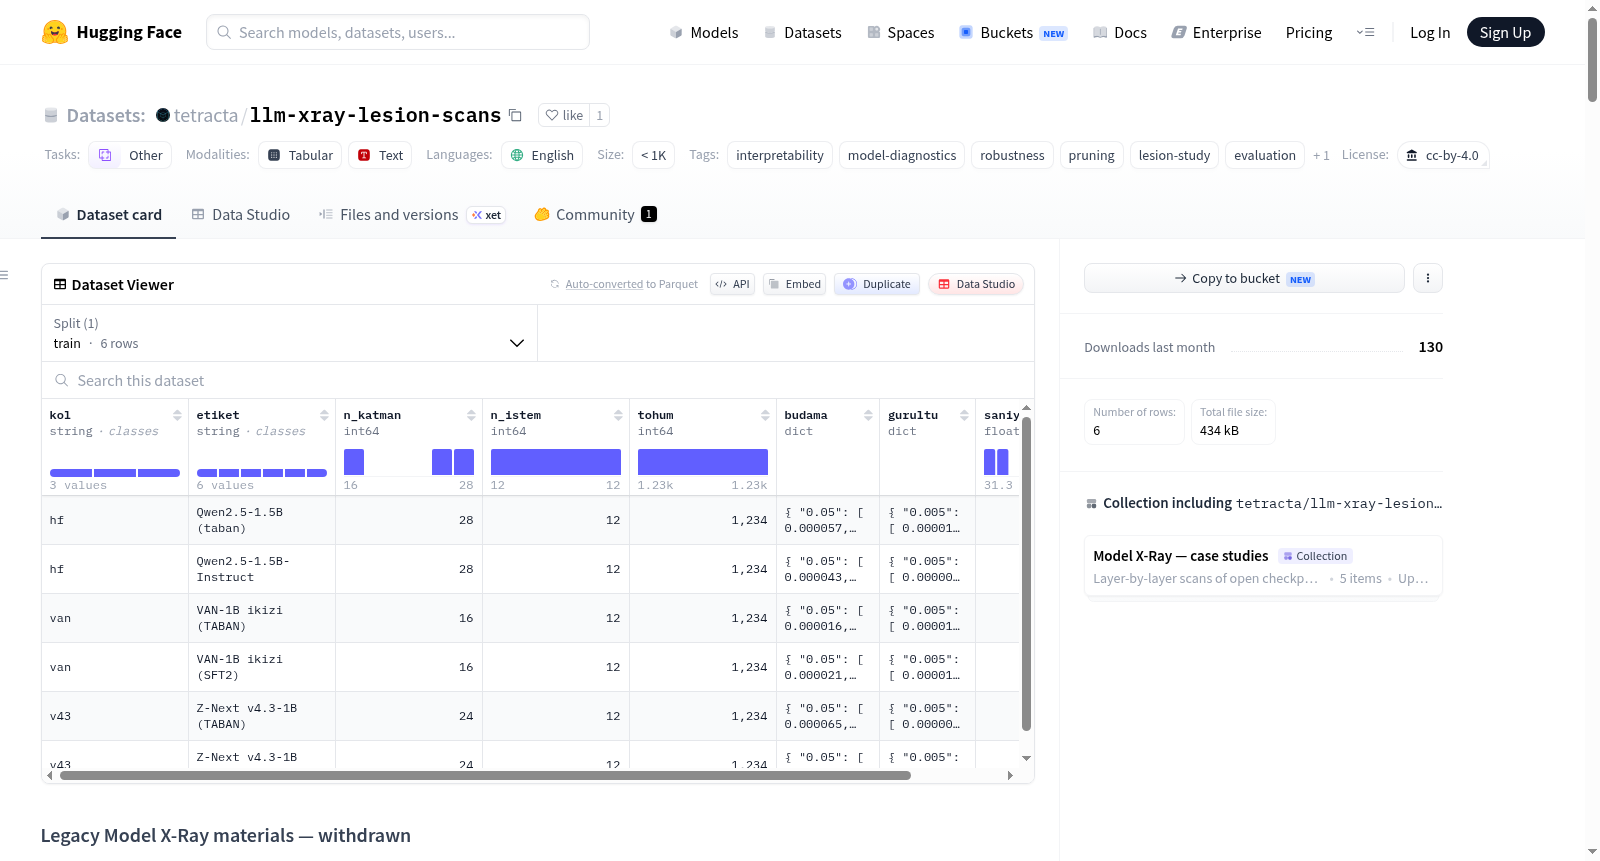
LLM Lesion X-Ray 数据集是一个已撤回的历史数据集,包含六个约1B参数的语言模型的层损伤扫描结果。该数据集由 Tetracta AI 使用单一预注册协议生成,仅包含测量数据(KL散度值),不包含模型权重。数据集的背景在于:传统基准测试只能评估模型的知识输出,而无法揭示模型内部结构;本数据集通过逐层损伤(剪枝或加噪)并测量输出分布变化,试图回答“模型是如何构建的”这一问题。数据内容包括六个模型的扫描结果,分别为:Qwen2.5-1.5B(基础版和指令版)、van-1b(内部Transformer,基础版和SFT版)、以及znext-v43(恒定状态架构,基础版和SFT版)。其中van-1b和znext-v43是在相同数据上训练的匹配对,仅架构不同。每个模型在12个固定英语提示下,对每一层应用五种损伤强度(剪枝:5%/10%/20%/30%;噪声:σ=0.005/0.01/0.02×权重标准差),记录损伤前后的分布KL散度。数据以JSON格式存储,每个文件包含字段:etiket(标签)、n_katman(层数)、n_istem(提示数)、tohum(随机种子)、budama(剪枝结果数组)、gurultu(噪声结果数组),数组长度为层数,顺序为输入到输出。数据规模为n<1K,共6个文件。该数据集适用于模型可解释性、鲁棒性分析、剪枝研究、损伤研究等任务,但注意:数据集已撤回,不得用于支持任何位置、知识、肖像、损伤响应、模拟量化、质量、安全或部署声明。
The LLM Lesion X-Ray dataset is a withdrawn historical dataset containing layer-wise lesion scans of six ~1B parameter language models. Generated by Tetracta AI using a single pre-registered protocol, it contains only measurement data (KL divergence values) and no model weights. The dataset includes scans of six models: Qwen2.5-1.5B (base and instruct versions), van-1b (internal Transformer, base and SFT versions), and znext-v43 (constant-state architecture, base and SFT versions). van-1b and znext-v43 are matched pairs trained on the same data differing only in architecture. Each model is tested with 12 fixed English prompts, applying five lesion intensities (pruning: 5%/10%/20%/30%; noise: σ=0.005/0.01/0.02×weight standard deviation) per layer, recording the KL divergence before and after lesion. Data is stored in JSON format, each file containing fields: etiket (label), n_katman (number of layers), n_istem (number of prompts), tohum (random seed), budama (pruning results array), gurultu (noise results array), with array length equal to number of layers in input-to-output order. Data size is n<1K, 6 files total. Suitable for model interpretability, robustness analysis, pruning research, and lesion studies, but note: the dataset is withdrawn and must not be used to support any claims regarding location, knowledge, representation, lesion response, simulated quantization, quality, safety, or deployment.
数据集概述:LLM Lesion X-Ray
基本信息
LLM Lesion X-Ray 数据集由 Tetracta AI 发布,针对六个 1B 级语言模型进行神经层损伤(layer-lesion)扫描实验,采用统一的预注册协议(pre-registered protocol)。该数据集包含的是测量数据(measurements),而非模型权重。
- 许可证:CC-BY-4.0
- 语言:英语
- 数据规模:小于 1K 条记录
- 标签:可解释性、模型诊断、鲁棒性、剪枝、逐层损伤研究、评估
⚠️ 重要声明(撤回状态)
根据 2026 年 9 月 6 日的修正声明:该数据集此前发布的 Model X-Ray 结果已被撤回。这些文件被视为历史性材料而非当前证据,不得用于支持关于定位、知识、画像、病变响应、模拟量化、质量、安全或部署方面的任何主张。目前尚未发布替代数据,验证工作仍在进行中。
实验设计
实验方法
对所有模型执行相同的扫描协议:逐层对模型权重进行损伤处理——按幅度剪枝最小 5% / 10% / 20% / 30% 的权重,或添加高斯噪声(σ = 0.005 / 0.01 / 0.02 × 权重标准差),然后计算损伤前后输出分布之间的 KL 散度。
核心指标
| 指标 | 含义 |
|---|---|
| fragility(脆弱性) | 每单位损伤导致输出分布变化的程度 |
| concentration(集中度) | 最敏感的前 1/5 层所承载的损伤比例(均匀分布时为 20%,若模型过度依赖少数层则接近 90%) |
数据集内容
数据集包含 6 个 JSON 文件,涵盖以下模型:
| 文件 | 模型 | 权重状态 |
|---|---|---|
qwen2.5-1.5b-base.json |
Qwen2.5-1.5B | 开源 |
qwen2.5-1.5b-instruct.json |
Qwen2.5-1.5B-Instruct | 开源 |
van-1b-base.json |
内部 Transformer 模型(10.32B tokens) | 未发布 |
van-1b-sft.json |
上述模型 SFT 版本 | 未发布 |
znext-v43-base.json |
Z-Next v4.3 恒定状态架构(10.00B tokens) | 未发布 |
znext-v43-sft.json |
上述模型 SFT 版本 | 未发布 |
其中 van-1b 与 znext-v43 构成匹配对:使用相同数据、相同预算训练,仅架构不同。在标准基准测试上两者仅相差 0.62 个宏平均分(95% CI [−0.06, +1.28],统计上视为相等),但实验仪器下表现截然不同。
核心发现(30% 剪枝下的平均 KL/层,×10⁻³)
| 模型 | Base | SFT 后 | 集中度(base → SFT) |
|---|---|---|---|
| Z-Next v4.3 | 7.7 | 12.8 | 37% → 39% |
| 内部 Transformer | 60.6 | 117.1 | 72% → 69% |
| Qwen2.5-1.5B | 18.5 | 10.3 | 41% → 52% |
关键结论:
- 匹配对在脆弱性上相差 7.9 倍(base)/ 9.1 倍(SFT 后),集中度分别为 37% vs 72%
- 微调对集中度影响极小(37→39,72→69),该特征似乎在预训练结束时已确定
- 微调使 Qwen 更鲁棒(18.5→10.3),但使自家两个模型更脆弱
数据集局限
- 不构成架构层面的因果结论:缺少独立种子控制实验,无法区分架构差异与训练随机性造成的影响
- Qwen 对比受限:数据、规模、架构多重因素同时不同,无法解耦分析
- 作者曾于 2026 年 7 月因控制模型显示结果位于正常噪声区间内而撤回过内部差异的发表
文件格式
字段使用土耳其语命名:etiket(标签)、n_katman(层数)、n_istem(提示数量)、tohum(种子)、budama(剪枝)、gurultu(噪声)。每个数组按层顺序存储每层一个 KL 值,跨架构比较需将层索引归一化至 0–1。
相关链接
- 完整研究笔记:https://www.tetracta.ai/note-xray-lesion.html
- 扫描服务与示例报告:https://www.tetracta.ai/xray.html
- 恒定状态模型演示:https://www.tetracta.ai/zchat
- 配对研究(含种子控制):https://huggingface.co/tetracta/llm-xray-twin-study-1b
- 修正记录:https://www.tetracta.ai/model-xray/correction/